一、背景与动机
1.1 问题:AI 生成代码的安全一致性缺失
大语言模型(LLM)在安全编码能力上参差不齐——顶级模型在有明确安全 Prompt 时能写出较安全的代码,但中低端模型、以及在没有显式安全约束的对话中,往往会毫不犹豫地生成 exec(req.query.cmd) 这样的高危代码。即便是同一个强模型,在不同 Prompt 风格、不同上下文长度下,安全行为也会出现漂移。这种不稳定性使得”相信模型能自我保证安全”在工程实践中不可靠。
此外,传统的安全审计发生在 CI/CD 阶段,距离代码生成已经过去了数小时甚至数天,修复成本高、上下文丢失。
1.2 目标:”生成即安全”
我们提出一个核心理念:每一行 AI 生成的代码,在落盘的时候就应完成安全审计。如果存在漏洞,AI 应当在同一轮对话中自动修复,直到代码通过检测——用户无需介入。
二、前置知识
2.1 Claude Code Hook 机制
Claude Code是现今最热门的 AI 编程 CLI 工具,允许 AI 在本地直接读写文件、执行命令。Hook 是其提供的扩展点——可以在 AI 执行特定操作的前后,自动运行用户定义的 shell 命令。这是实现”生成即审计”的关键基础设施。
Hook 通过 .claude/settings.json(仓库级)或全局配置文件注册。格式如下:
{
“hooks”: {
“PostToolUse”: [
{
“matcher”: “Write|Edit”,
“hooks”: [
{
“type”: “command”,
“command”: “node scripts/yasa-hook.js”,
“timeout”: 15
}
]
}
],
“Stop”: [
{
“matcher”: “”,
“hooks”: [
{
“type”: “command”,
“command”: “node scripts/yasa-stop-hook.js”,
“timeout”: 30
}
]
}
]
}
}
2.2 Hook 事件点
Claude Code 目前支持四类 Hook 事件:
| 事件 | 触发时机 | 典型用途 |
|---|---|---|
PreToolUse |
AI 调用工具之前 | 拦截危险操作(如拒绝写某些目录) |
PostToolUse |
AI 调用工具之后 | 质量检查、安全扫描 |
Notification |
Claude 向用户发送通知时 | 消息过滤、日志记录 |
Stop |
Claude 完成一轮回复时 | 汇总报告、异步任务收尾 |
AICG-YASA 使用 PostToolUse(写文件后立即扫描)和 Stop(收集超时扫描结果)两个事件点。
2.3 Hook 的 I/O
Hook 程序通过 stdin 接收事件 JSON,通过 stdout 返回控制指令
stdin 输入结构(PostToolUse)
{
“hook_event_name”: “PostToolUse”,
“tool_name”: “Write”,
“tool_input”: {
“file_path”: “/path/to/generated.js”,
“content”: “…”
},
“tool_response”: {},
“session_id”: “abc123”
}
stdout 输出结构(阻断时)
{
“decision”: “block”,
“reason”: “人类可读的阻断说明”,
“hookSpecificOutput”: {
“hookEventName”: “PostToolUse”,
“additionalContext”: “注入 Claude 上下文的详细信息”
}
}
decision: "block" 会让 Claude Code 终止当前工具调用,并将 additionalContext 注入 AI 的对话上下文——AI 能看到这段文字,并在下一轮自动根据它修复代码。如果 stdout 为空或不含 decision: "block",则视为放行。
2.4 YASA 静态分析引擎
YASA(Yet Another Static Analyzer)是蚂蚁集团开源的多语言污点分析引擎:
基于 UAST 的跨语言 IR:JavaScript / Java / Go / Python 统一中间表示,分析逻辑与语言语法解耦
规则驱动的 Source-Sink 匹配:规则文件定义哪些是污点源(如
req.query)、哪些是危险汇聚点(如child_process.exec),YASA 在调用图上追踪污点流动路径两种扫描模式:
--single:单文件模式,跳过调用图构建,适合对独立文件做快速审计目录模式(不加
--single):构建全局函数调用图(CG),能追踪跨文件的 source→sink 路径
SARIF 标准输出:
report.sarif符合 SARIF 2.1 规范,包含完整的codeFlows(污点传播链)
规则配置示例:
1 | [ |
三、系统架构
3.1 整体流程
flowchart TD
    A([用户请求]) --> B[LLM 生成代码]
    B --> C[Write / Edit 写入磁盘]
    C --> D{PostToolUse Hook\nyasa-hook.js}

    D --> E[validateFilePath\n输入安全校验]
    E --> F[decideScanStrategy\n策略决策引擎]

    F -->|forward\n检测到路由注册| H[YASA 单文件扫描\n--single]
    F -->|reverse\n检测到 sink 无路由| I[YASA 目录级扫描\n构建全局 CG 反向回溯]
    F -->|skip\n测试/配置/Hook自身/无特征| G([exit 0 通过])

    H -->|超时 > 8s| K[转后台异步\npending-scans.json]
    H -->|findings = 0| G
    H -->|findings > 0| J[decision: block\n漏洞详情注入上下文]

    I -->|超时 > 8s| K
    I -->|findings = 0| G
    I -->|findings > 0| J

    K --> L{Stop Hook\nyasa-stop-hook.js}
    L -->|进程仍运行| M([等待下轮])
    L -->|进程已结束 + 有漏洞| J

    J --> N[Claude 读取漏洞详情\n自动修复]
    N --> C
3.2 核心组件
| 组件 | 文件 | 职责 |
|---|---|---|
| PostToolUse Hook | scripts/yasa-hook.js |
Write/Edit 后同步触发 YASA,阻断或放行 |
| Stop Hook | scripts/yasa-stop-hook.js |
读取超时转异步的扫描结果,补充报告 |
| 规则映射 | scripts/rule-map.json |
文件扩展名 → YASA 语言 + 规则配置 |
| 扫描引擎 | YASA-Engine-main/dist/main.js |
蚂蚁 YASA 的编译产物 |
| Hook 注册 | .claude/settings.json |
Claude Code 仓库级 Hook 配置 |
3.3 扫描策略决策引擎
decideScanStrategy() 在 YASA 调用前分析文件特征,选择最合适的扫描策略:
| 模式 | 触发条件 | 行为 |
|---|---|---|
forward |
检测到 app.get/router.post/@Controller 等路由注册 |
单文件扫描(--single),以当前路由文件快速审计 |
reverse |
检测到 exec/query/eval 等 sink 调用,但无路由 |
目录级扫描(不加 --single),构建全局调用图并回溯到路由入口 |
skip |
测试文件 / .d.ts / .min.js / Hook 脚本自身 / 无路由且无 sink |
跳过扫描,减少无效开销 |
设计这一分层的原因:带路由的文件(controller 层)本身就是完整的 source→sink 路径起点,单文件扫描足够;而纯 service/util 层文件只有 sink,没有 source,单文件扫描会漏报,必须构建跨文件调用图才能追溯到上游路由的用户输入。
3.4 超时策略:同步超时转后台异步
在 Claude Code 的交互链路里,PostToolUse 是用户可感知延迟的一部分。若每次都强制同步等待扫描完成,目录级分析(尤其是 reverse 模式的全局调用图构建)会让 AI 写文件后的响应明显卡顿,甚至中断连续对话体验。
但如果简单地“超时即跳过”,又会丢失本应被检出的漏洞。为同时满足交互实时性与扫描完整性,系统采用“双通道”策略:
前台通道(低延迟):同步扫描设置 8 秒上限,确保主交互可控
后台通道(保完整):超时任务转后台继续执行,结果在后续轮次补报
后台异步流程如下:
PostToolUse启动同步扫描,并设置 8 秒超时阈值。若在阈值内完成:直接解析 findings,
0个问题放行,>0个问题立即decision:block。若超过阈值:将同一扫描任务转为后台进程继续运行,并把任务元数据写入
pending-scans.json;当前 hook 立即exit 0,不阻塞本轮生成。Claude 本轮回复结束后触发
Stophook:进程仍在运行:任务保留在队列,等待下一轮
进程已结束且无问题:从队列移除
进程已结束且有问题:输出
decision:block+additionalContext,并移除任务
Claude 在下一轮读到补报漏洞后进入自动修复,再次触发同一闭环。
该机制的本质是:把“是否阻断当前轮”与“是否最终给出安全结论”解耦。当前轮优先保证可用性,后续轮保证安全性不丢失。
四、关键实现代码解析
这一章不再讨论参数细节,而是直接从代码入口看系统如何闭环运行。
4.1 PostToolUse 主流程(scripts/yasa-hook.js)
主入口是 main(),核心调用链如下:
main
├─ readStdin
├─ validateFilePath / sanitizeSessionId
├─ decideScanStrategy
├─ runYasaSync
│ ├─ 超时 -> runYasaAsync + enqueuePending
│ └─ 完成 -> parseSarif
└─ formatFindings -> decision:block(JSON)
对应的控制逻辑可以概括为四段:
事件过滤:只处理
Write/Edit,其他工具事件直接exit 0。策略决策:
decideScanStrategy()返回forward/reverse/skip。扫描执行:
runYasaSync()先走同步路径,超时再切runYasaAsync()。结果回注:
parseSarif()取 findings,formatFindings()组装上下文,返回decision:block。
4.2 策略引擎代码(decideScanStrategy)
decideScanStrategy(filePath, ruleConfigFile) 是整个闭环的分流器:
命中路由特征(
app.get/router.post/@Controller)→forward命中 sink 特征(
exec/query/eval等)且无路由 →reverse两者都不命中,或属于测试/声明/Hook 脚本 →
skip
reverse 分支会调用 findProjectRoot() 向上查找 package.json,把扫描目标从当前文件提升为项目目录,让 YASA 在目录级构建完整调用图,再回溯 source→sink 跨文件路径。
从代码结构上看,这是一个典型的快速路径优先实现:
绝大多数普通文件直接
skip(零成本)路由文件走
forward(低成本)只有“疑似危险且缺上下文”的文件才走
reverse(高成本但高收益)
4.3 异步补报代码(scripts/yasa-stop-hook.js)
Stop hook 对应的主链路是:
main
├─ readStdin
├─ 读取 pending-scans.json
├─ isProcessAlive(pid)
├─ parseSarif(reportDir)
├─ formatFindings
└─ decision:block(JSON)
它做的事情很纯粹:
遍历
pending-scans.json队列。对每个任务先判定进程是否仍在运行:
在运行:继续保留在队列
已结束:解析 SARIF
有 findings 的任务聚合成报告,统一输出一次
decision:block。无 findings 的已完成任务直接清理。
这段代码把“超时后扫描结果丢失”的问题补上了:前台没来得及阻断的漏洞,会在后续 Stop 周期里补发给 Claude,并重新进入修复闭环。
4.4 两个 Hook 的协作关系
从实现上,yasa-hook.js 与 yasa-stop-hook.js 形成了一个状态机:
[Write/Edit]
↓
PostToolUse(yasa-hook.js)
├─ findings>0 -> 立即 block
├─ findings=0 -> 放行
└─ timeout -> 入队 pending-scans.json
↓
Stop(yasa-stop-hook.js)
├─ 进程未结束 -> 保留队列
├─ 已结束且0问题 -> 清理队列
└─ 已结束且有问题 -> 补发 block
这保证了两个目标同时成立:
即时性:不把所有长扫描都阻塞在当前交互
完整性:超时任务不会被忽略,最终一定被消费并回注结果
4.5 代码层面的闭环边界
从这套实现可以看出,闭环边界非常清晰:
PostToolUse负责写入瞬间的首轮判定Stop负责超时任务的延迟判定两者共同通过
decision:block + additionalContext驱动 Claude 自动修复
也就是说,闭环并不依赖模型的自觉,而是依赖 Hook 协议把静态分析结果强制并入模型上下文,形成可重复的工程约束。
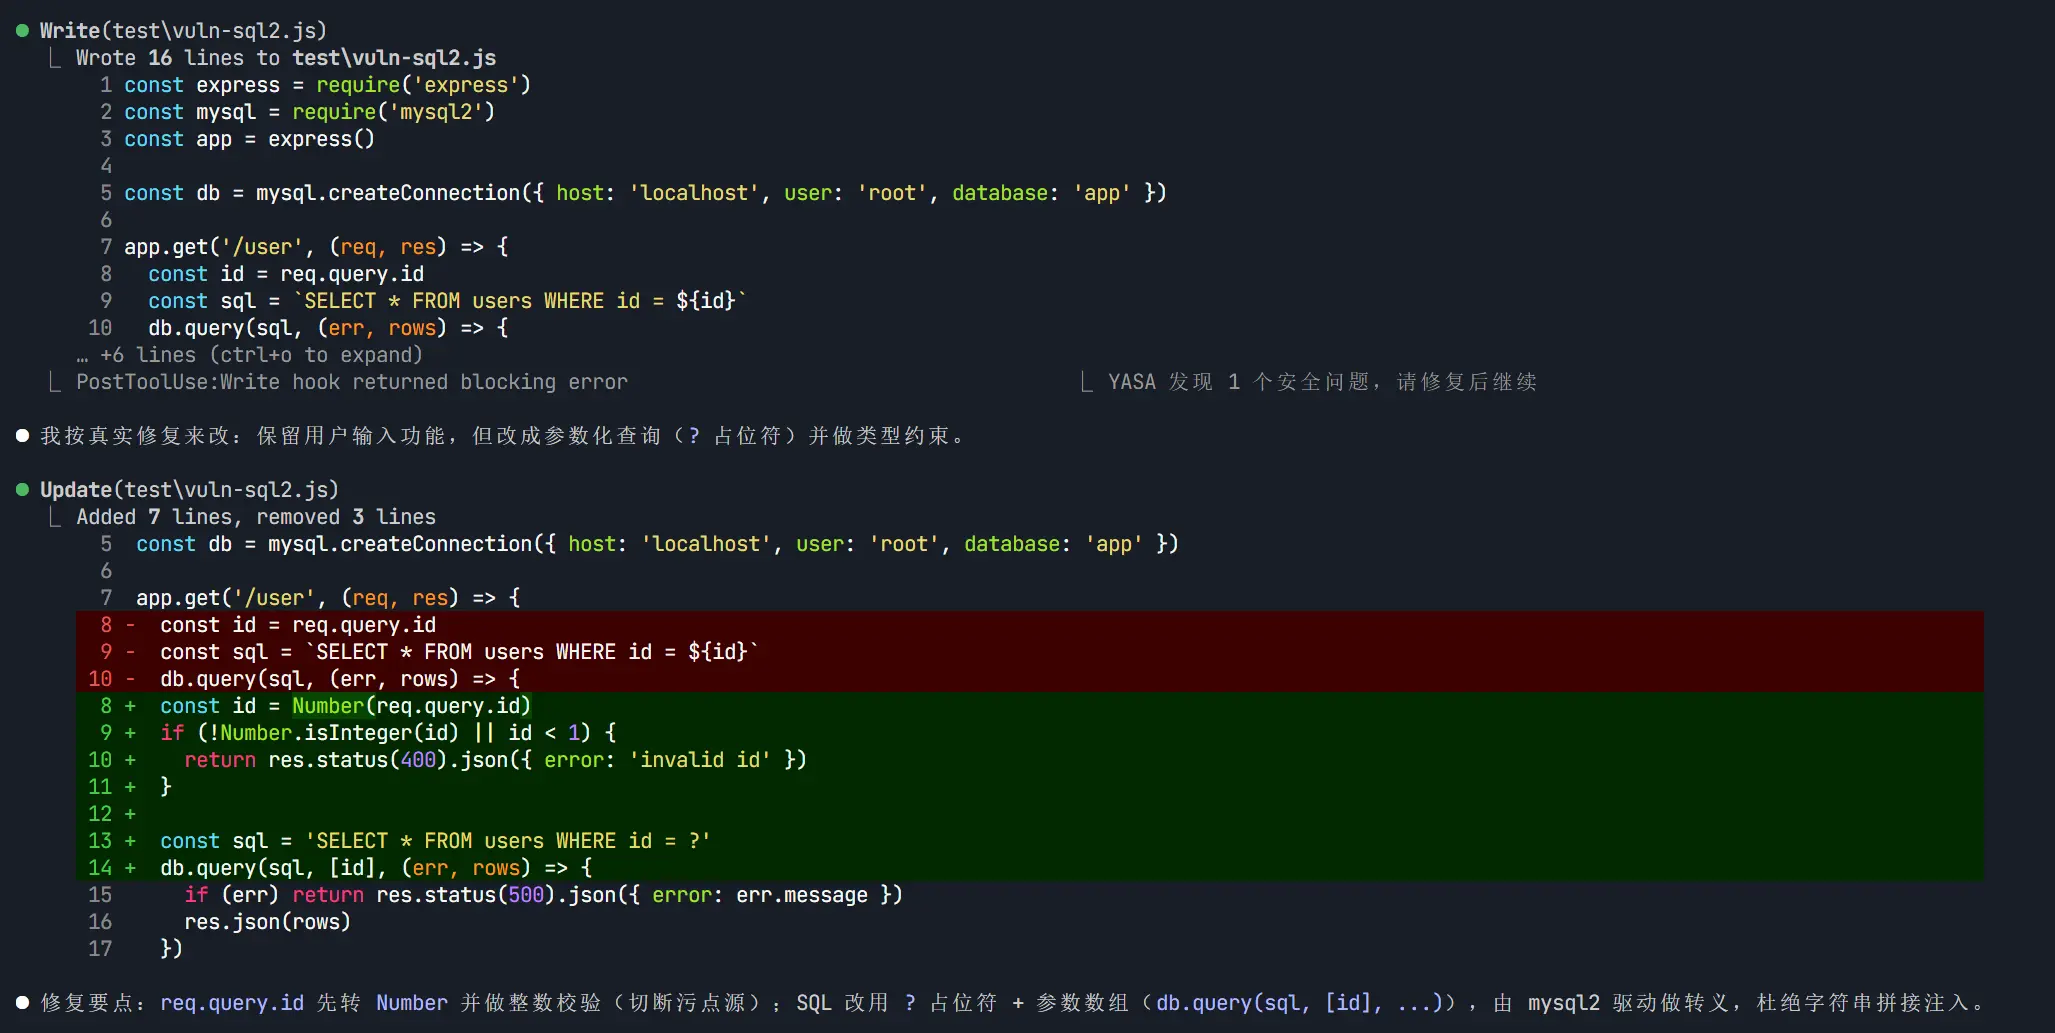
五、实测:端到端触发验证
5.1 测试用例
我们构造了 4 个典型漏洞场景,由 Claude Code 直接写入磁盘:
| 文件 | 漏洞类型 | 核心代码 |
|---|---|---|
vuln-cmd-injection.js |
命令注入(CWE-78) | exec(\ping -c 4 ${req.query.host}) |
vuln-eval.js |
代码执行(CWE-94) | eval(req.query.code) |
vuln-sql.js |
SQL 注入(CWE-89) | db.query(`SELECT * WHERE id = ${req.query.id}`) |
vuln-xss.js |
反射型 XSS(CWE-79) | res.send(`<h1>Hello ${req.query.name}</h1>`) |
5.2 Hook 日志
1 | [2026-04-20T15:09:18] STRATEGY: vuln-cmd-injection.js → mode=forward (检测到路由注册,正向扫描) |
5.3 阻断输出(命令注入)
当 Claude 写入含命令注入的文件后,Hook 向 Claude Code 输出:
1 | { |
注入 Claude 上下文的漏洞详情:
1 | ⚠ YASA 安全扫描结果(共 2 个问题)触发文件:vuln-cmd-injection.js |
5.4 截图
总结
本文仅作为笔者一个想法的尝试,如果有师傅对此感兴趣欢迎交流(wx:P4nY0O);如果日后有空,笔者也希望完善下这个项目开源出来,在腾讯的AICGSecEval评测上跑一跑,测试下有这个hook和没这个hook组件能有多少提升