Pointer Analysis
本课主要内容如下:
- Motivation
- Introduction to Pointer Analysis
- Key Factors of Pointer Analysis
- Concerned Statements
首先先来讲一下有了之前的CHA算法之后为什么还要指针分析,一个很简单的例子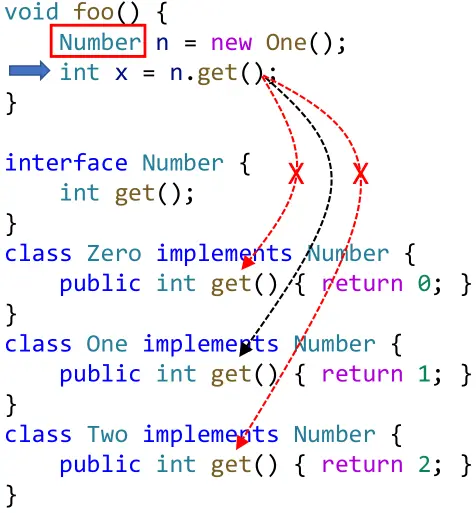
如果用CHA分析这个get()方法,那么它会得到3个目标方法,常量传播分析的话,这里的结果就是NAC,但实际上这里只会调用class One里的get(),x就是一个常量1. 而用CHA分析丢失了精度,所以我们需要一种精度更高的分析方法也就是指针分析,用于解决CHA在调用图中引入了很多假的调用边的问题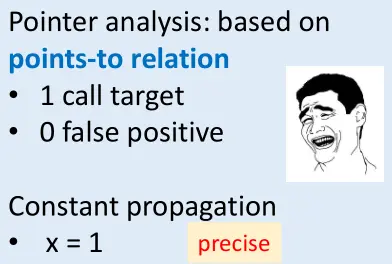
Introduction to Pointer Analysis
那么什么是指针分析呢,举了一个例子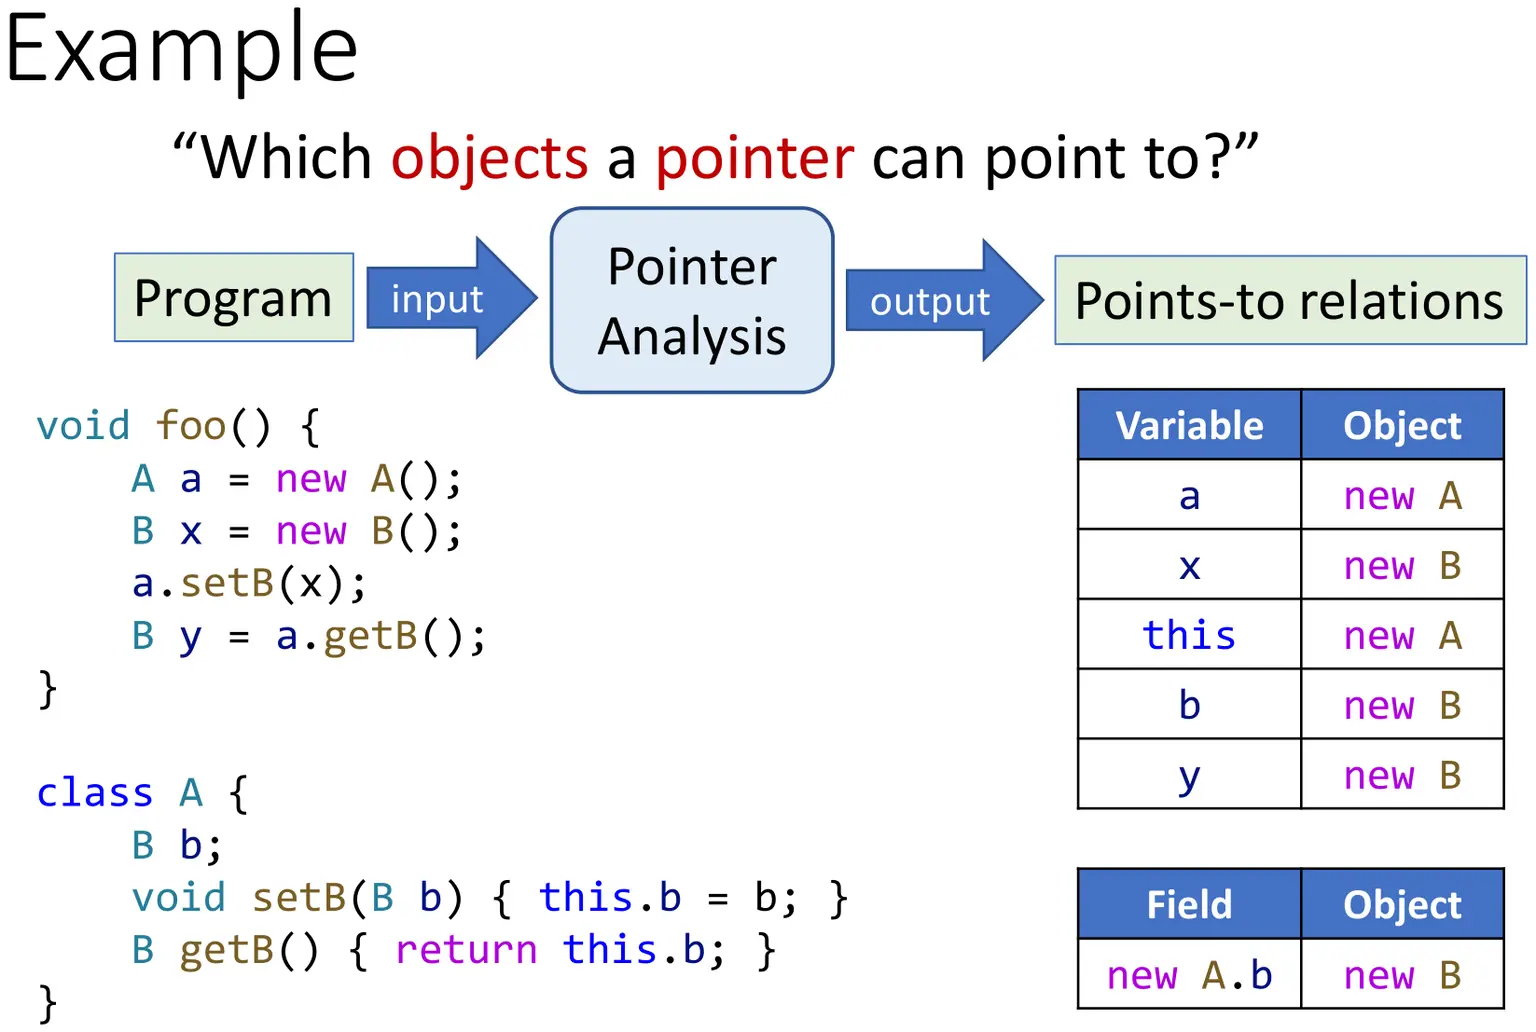
程序–(输入)–>指针分析–(输入)–>指向关系
指针分析简要地说,就是解决了:”一个变量指向了哪个对象“ 这么一个问题
程序中保存一个地址的东西都可以视为指针(Pointer/Reference)。
Regarded as a may-analysis
- Computes an over-approximation of the set of objects that a pointer can point to, i.e., we ask “a pointer may point to which objects?”
Foundations-1
Pointer Flow Graph: Edges
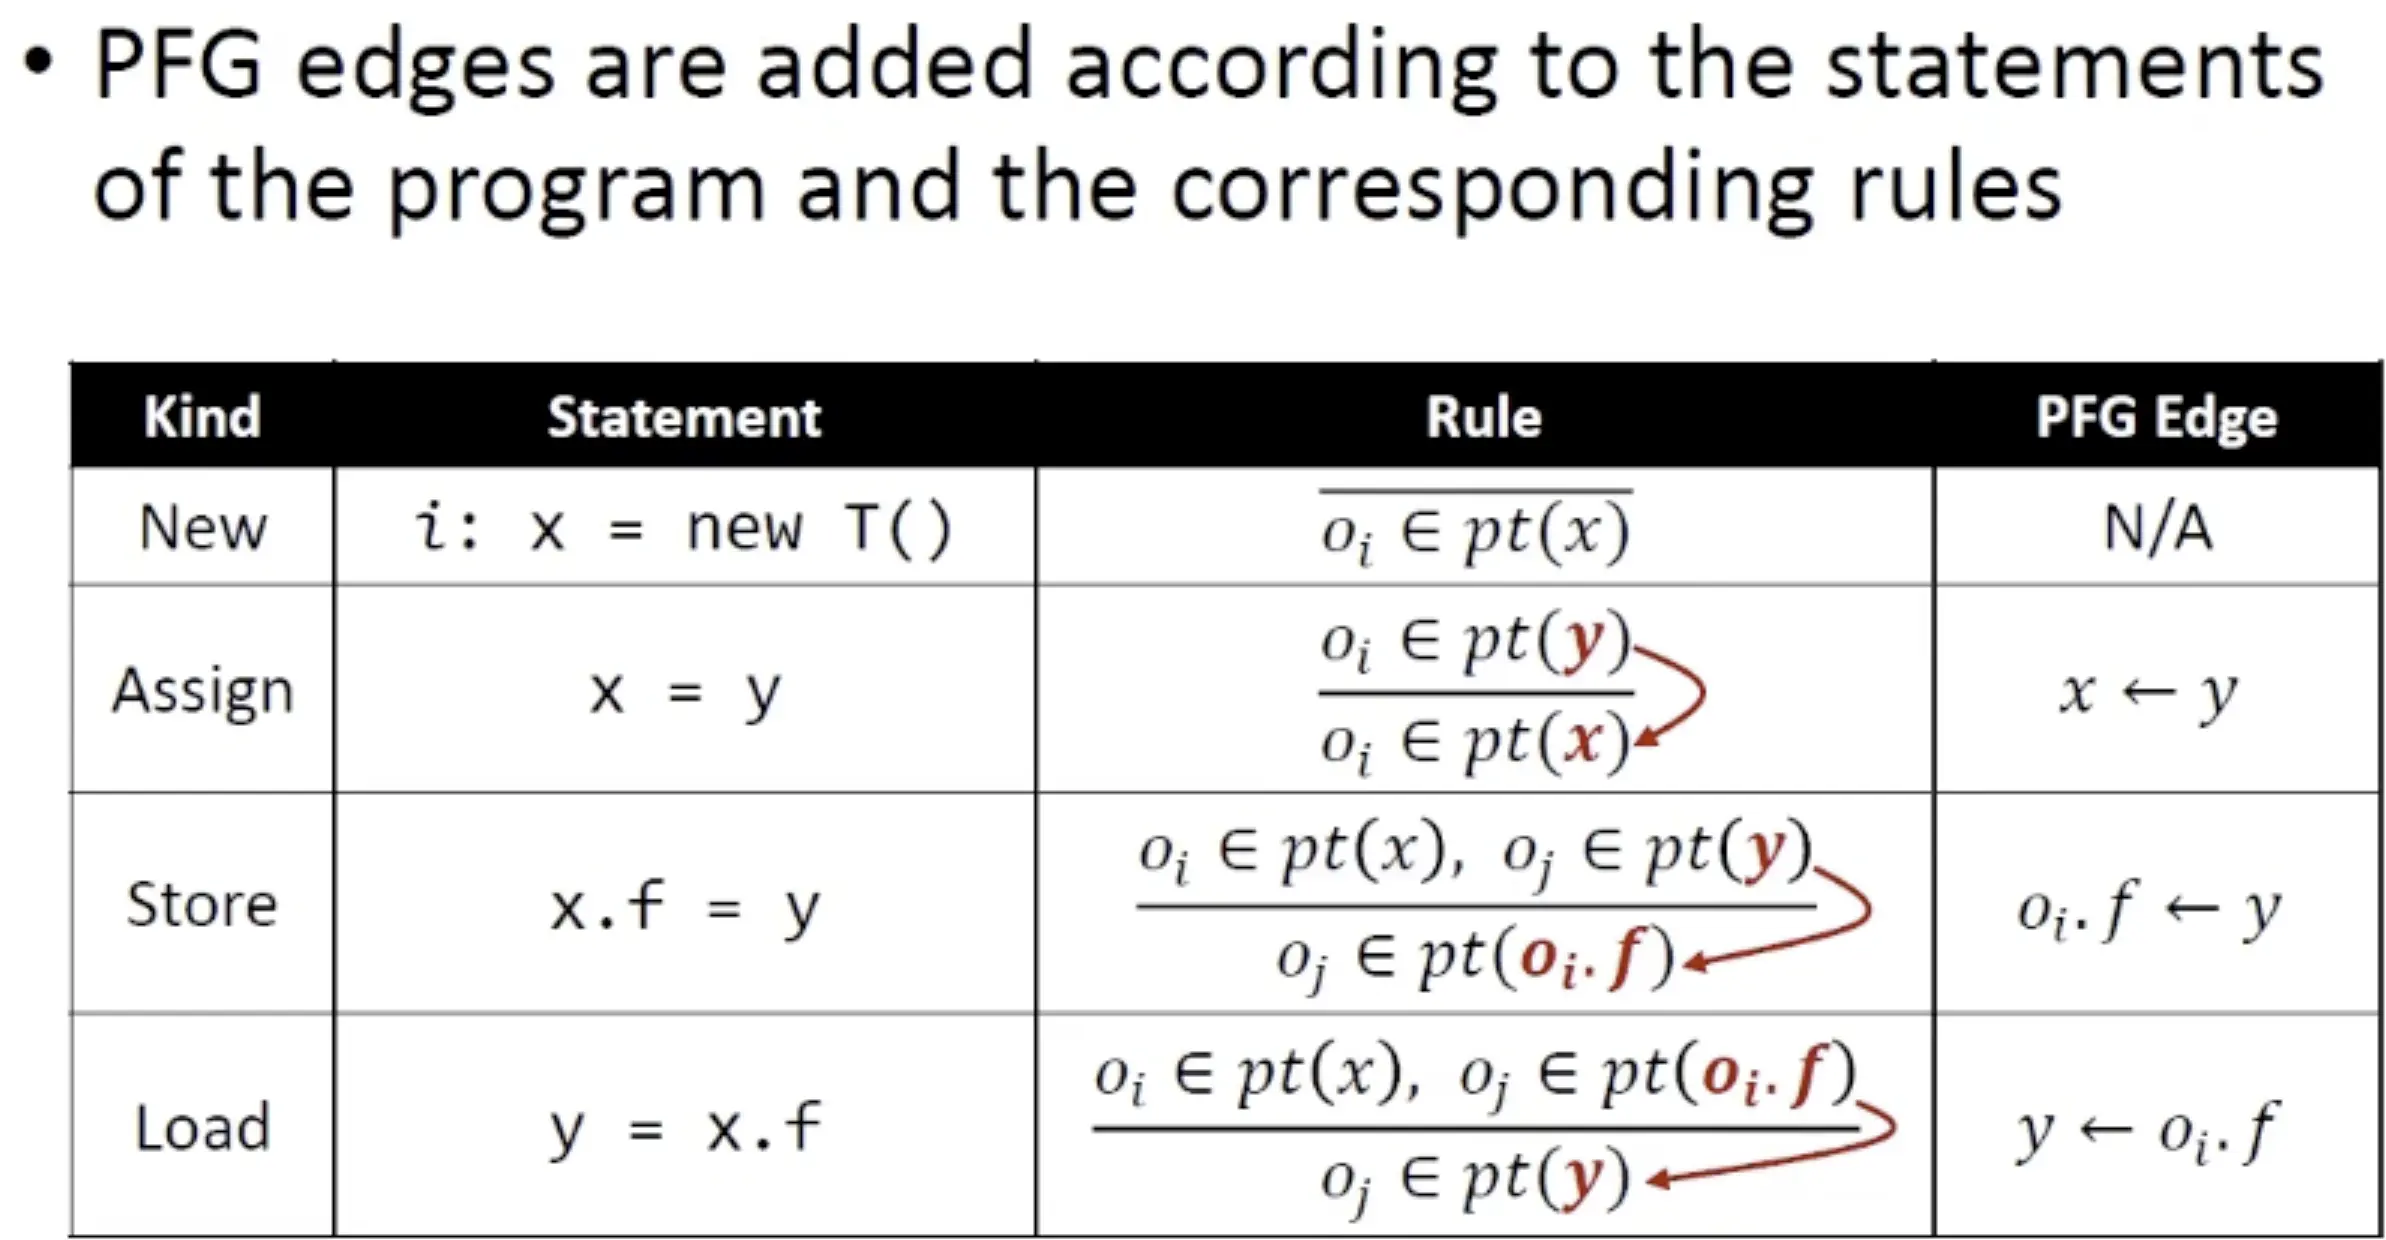
这是我们往PFG中加边的规则
用一个例子来辅助理解
PFG中有两种node,一种表示变量,记作v,一种表示Instance field记作Oi.f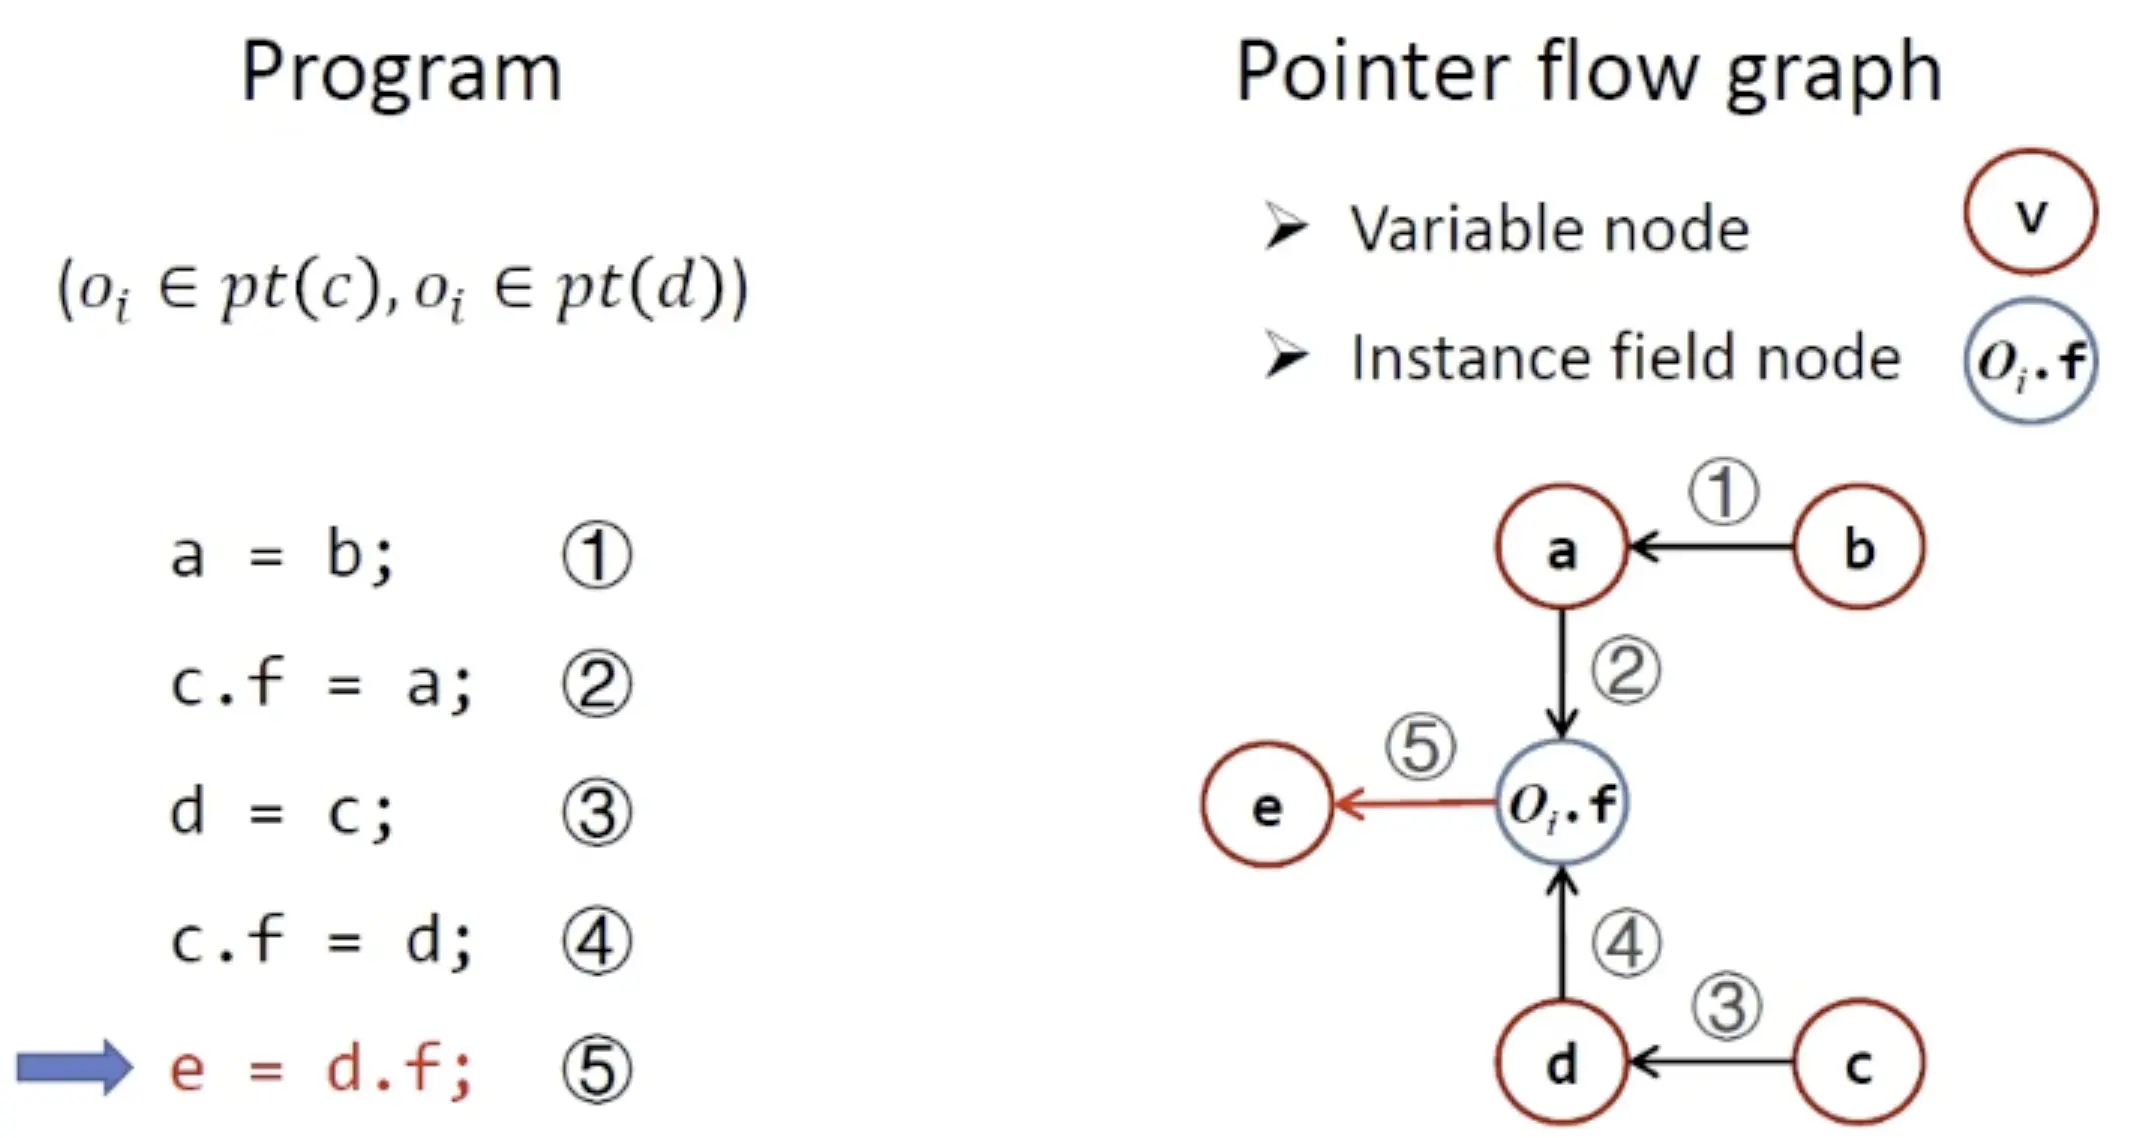
使用PFG,可以通过计算PFG的传递闭包来解决指针分析问题。
例如,在PFG中,e可以从b到达,这意味着b所指向的对象可以流向e并也被e所指向。
利用这个PFG图我们就可以进行所谓指针分析了,加入我们一开始给b传一个对象,那么我们根据PFG可以立刻得到这个对象Oj可以到达的节点
但显然,这也是一个may analysis,所以有些可达的节点实际上不一定真的指向这个对象
但是我们可以把指针分析的问题转化为图上的传播问题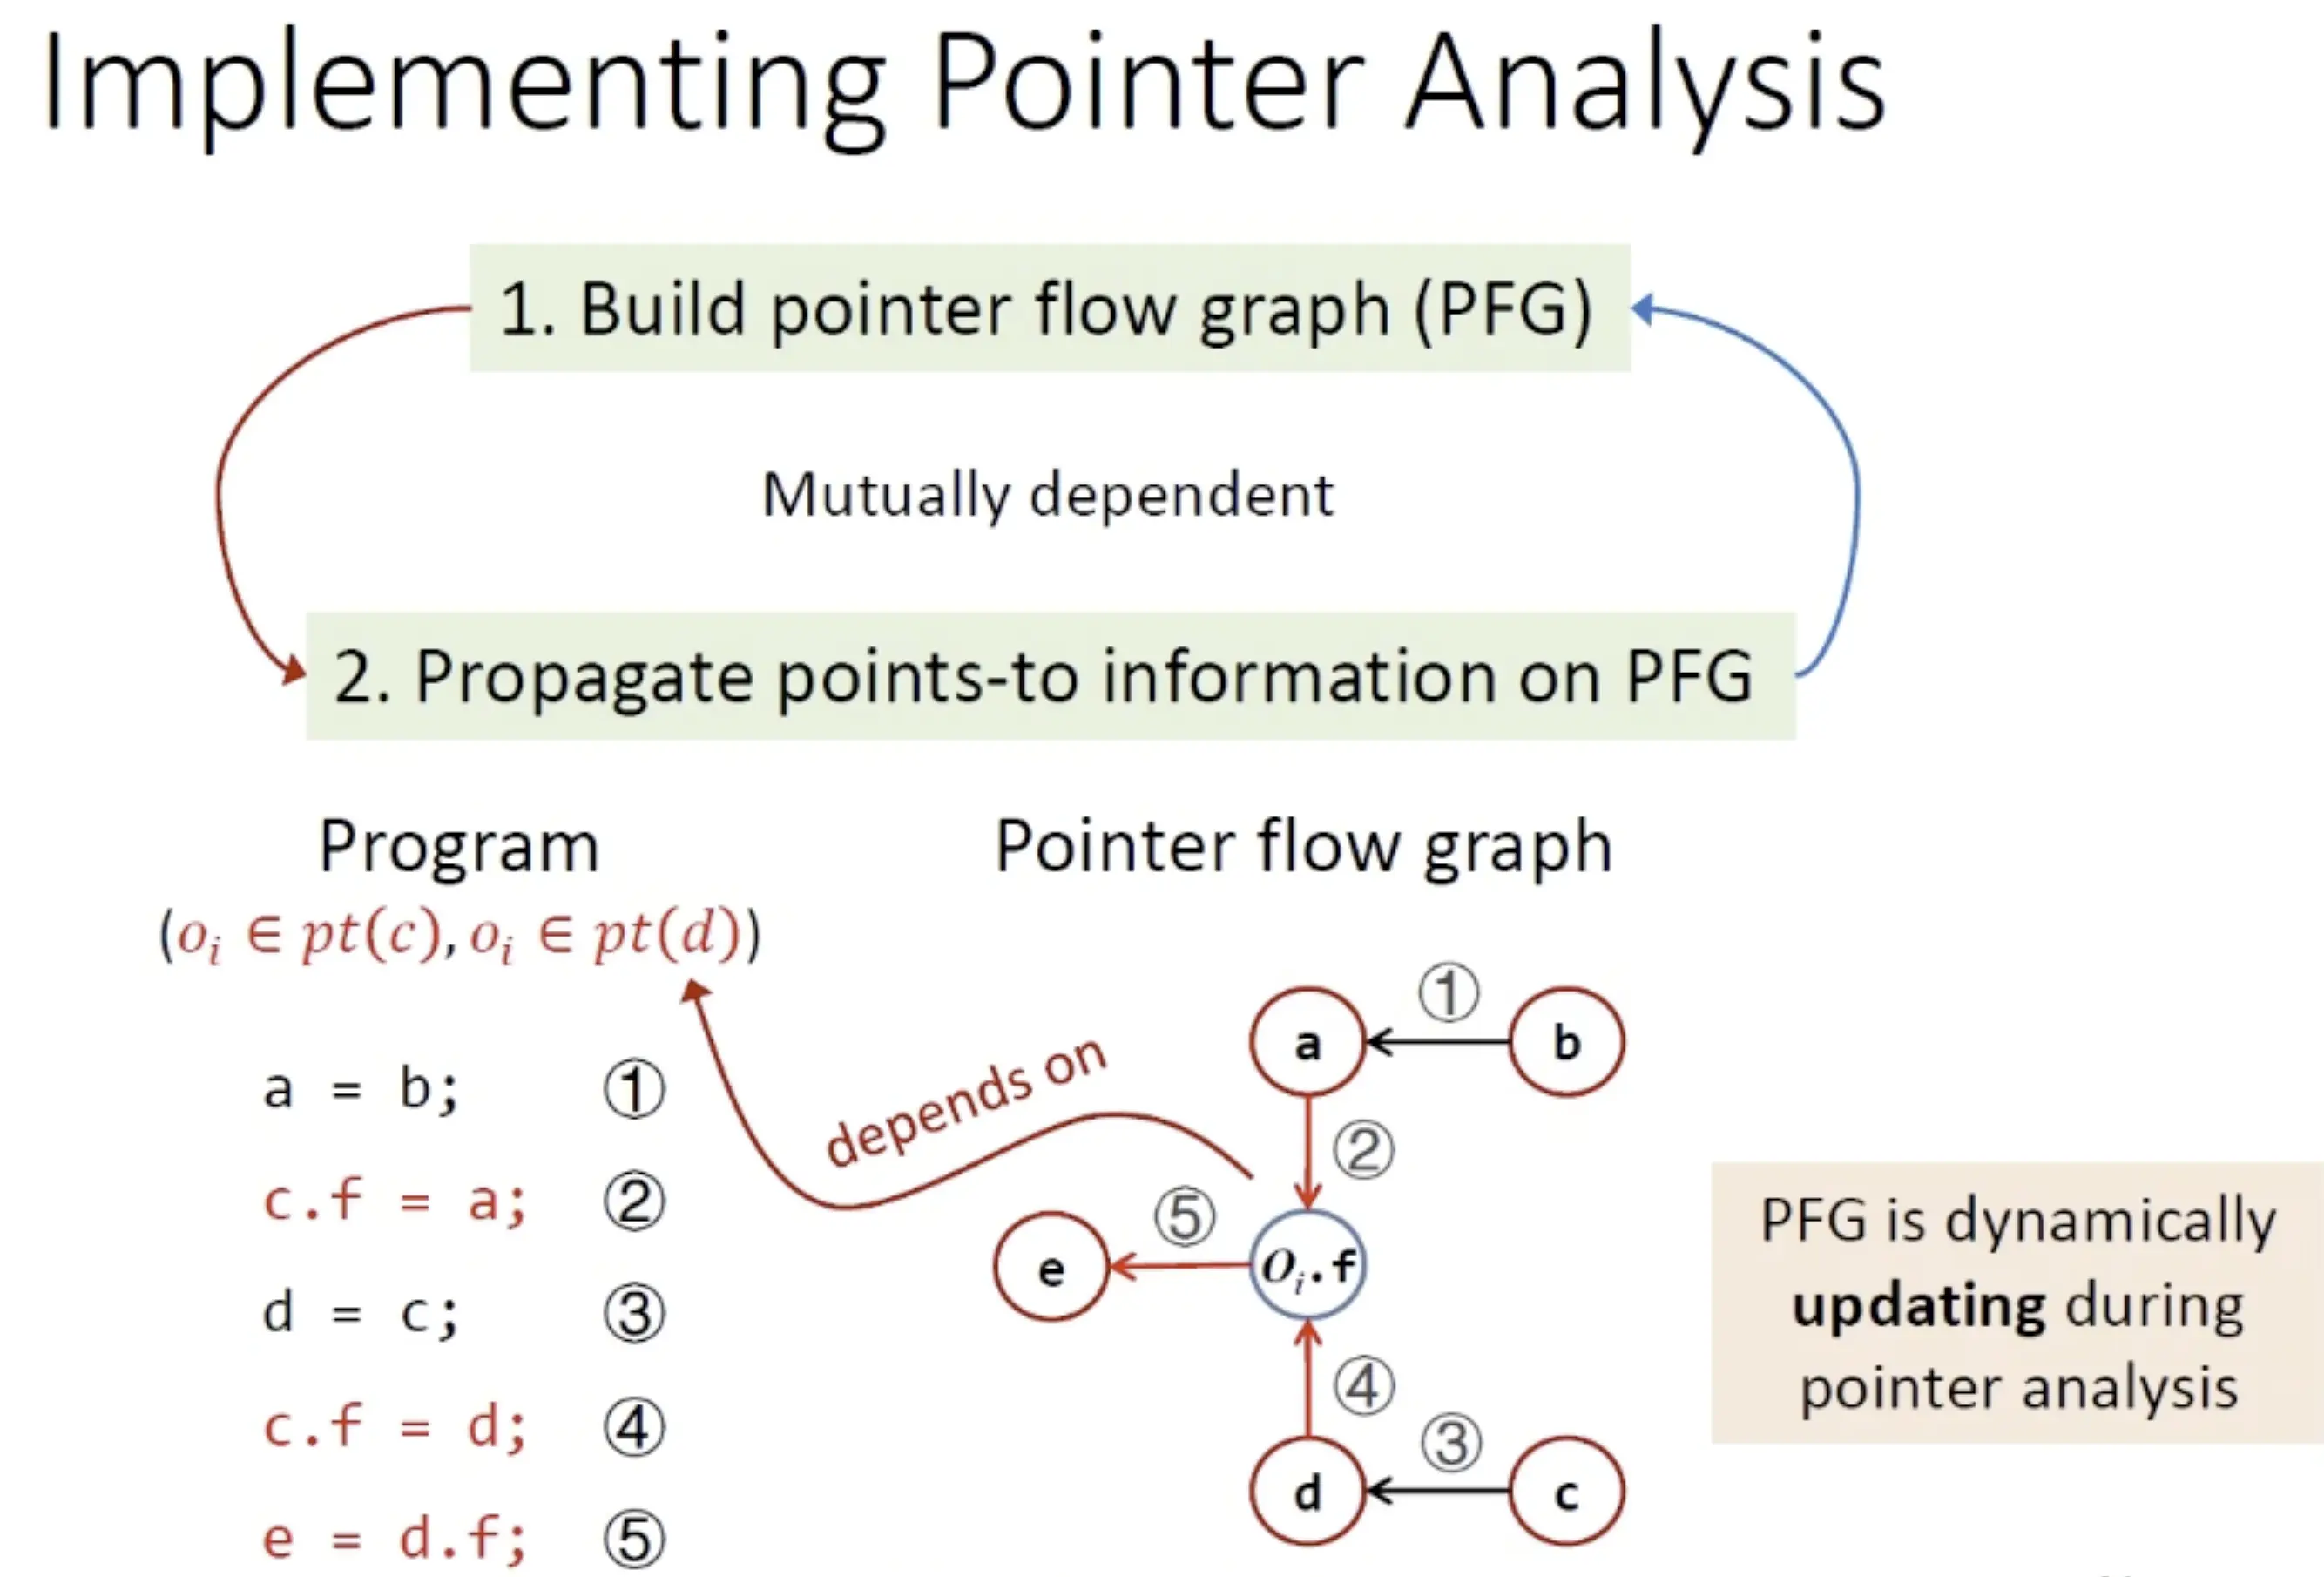
然而这又不是简单的一个 建图->分析 的过程
因为建图和图上的传播信息是一个互相依赖的关系,因为涉及到Instance field的节点依赖于filed的指针信息
所以,PFG是在指针分析过程中动态更新的
指针分析越多,PFG的边越多,又会导致指针分析的关系会更多
1 | // 算法:Solve(S) - 字段敏感的指针分析 |
这里要稍微讲两句WL这个数据结构,和之前数据流分析里的WL有些许不一样,其中每个WL对,前者是指针,后者是需要加到该指针可指向的对象集合的对象集合(有点抽象但可以理解)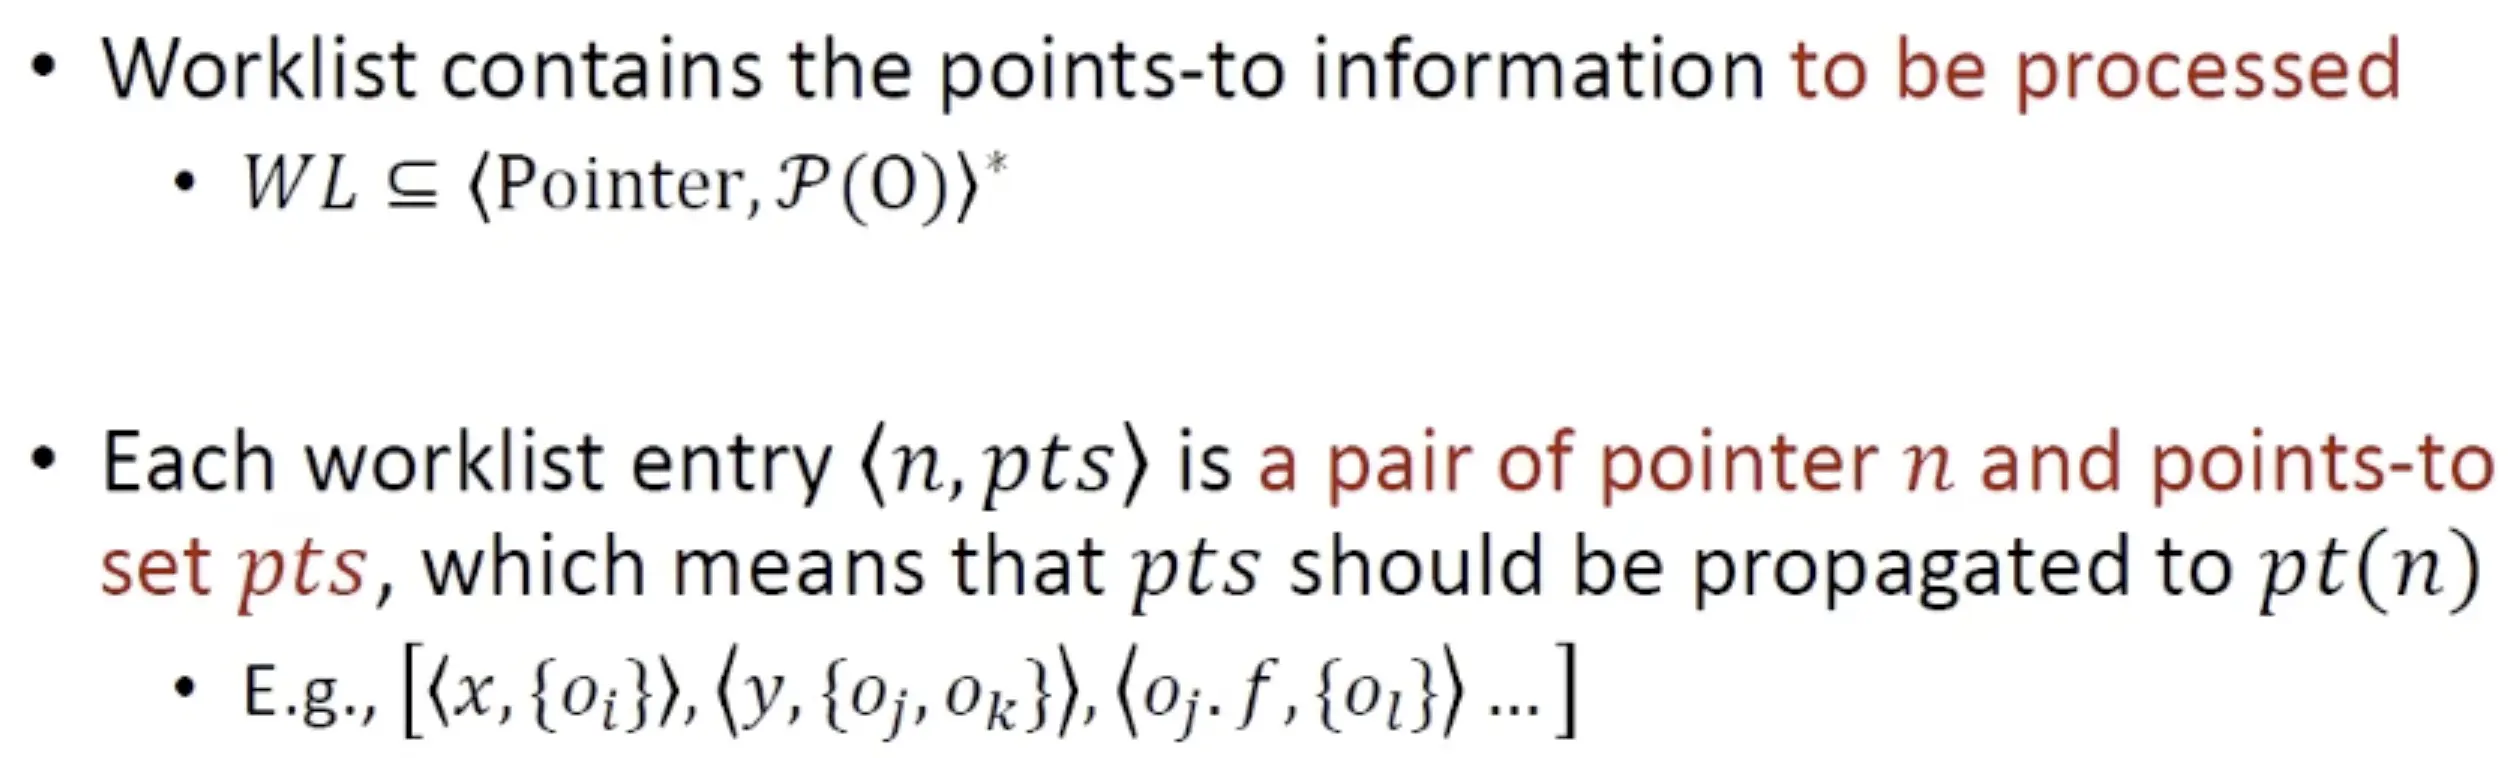
然后这里给出一个简化的算法(只考虑New 和Assign)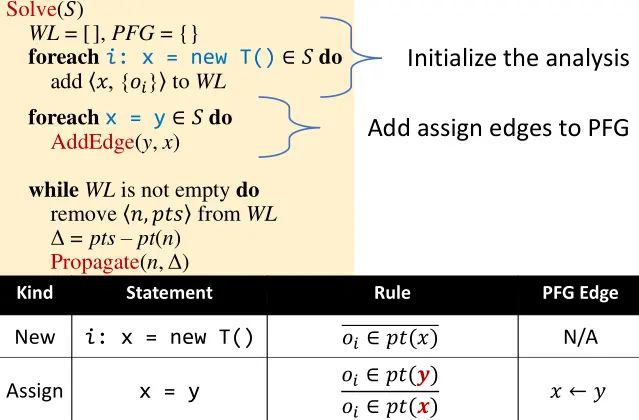
- 前三行代码做初始化的工作,并针对所有的New语句,将所有的初始指向关系加入WorkList
- pt(n)初始化为空集{},随着算法的迭代会增加元素
- 之后的两行代码处理Assign语句,添加
y->x的边到PFG中,添加边的具体算法如下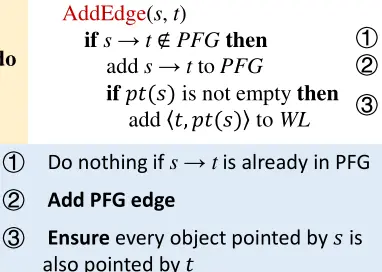
1 如果 s → t 已经存在于 PFG 中,则无需操作
2 添加 PFG 边
3 确保每个被 s 指向的对象也被 t 指向
具体的传播算法实现如下,首先从WL中取出并取出一个pair,然后做一个pts-pt(n)的操作,这部实际上就是得到真正的增量集,将需要添加的pts中减去n节点本来就有指向的pt(n),剩下的就是增量了,右边也有个小例子来具体说明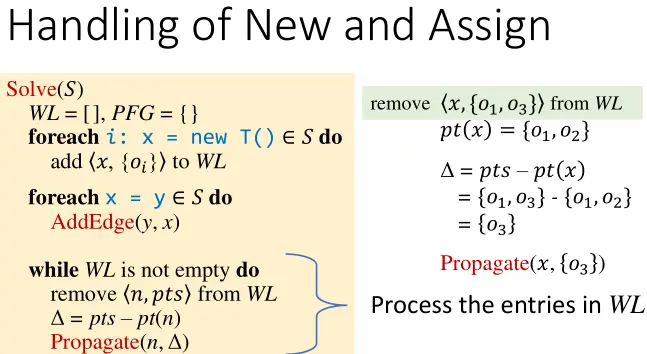
具体的传播算法Propagate,标号为2的语句是整个算法中唯一执行后改变指向关系的语句,真正将pts并到pt(n)当中去
第三句是将n的每一个后继和pts组合成一个pair加入到WL中,这样就可以将整条链路上的节点都更新pts中新增的指向对象集合了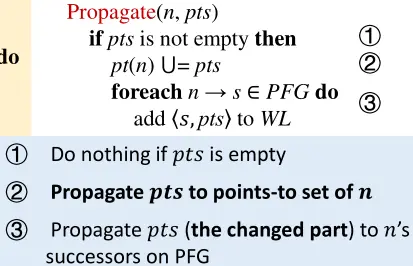
Detial-Differential Propagation
在真实的指针分析中,对象的数量非常巨大(上亿),我们通过Differential Propagation(增量分析)来消除冗余
1 | Solve(𝑆) |
首先我们考虑不使用Differential Propagation的情况,首先是a->c->d的传递路线。

然后是b->c->d的传递路线,虽然 {o1,o3}{o1,o3}之前已经在c所指向的集合中了,但依然需要参与传播,这是冗余的。

我们再来看使用Differential Propagation的情况,只需要传播{o5}{o5}一项即可。在实际应用中这能够大大减小开销。

In practice, Δ is usually small compared with the original set, so propagating only the new points-to information (Δ)
Besides, Δ is also important for efficiency when handling stores, loads, and method calls, as explained later
前面我们讲了new 和assign在指针分析中如何处理,下面处理store跟load,稍微复杂一些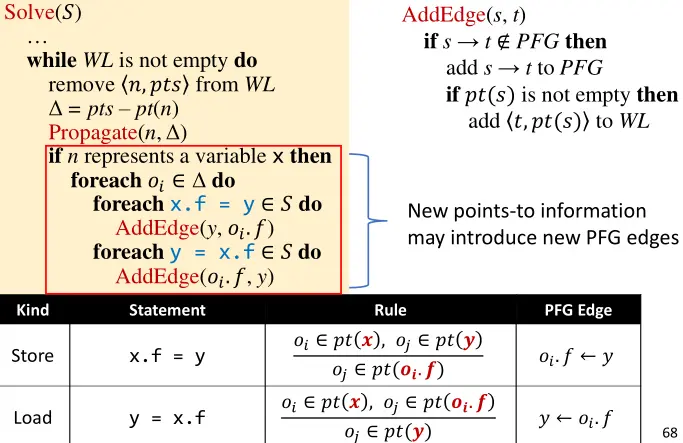
1 | // 传播点集到节点及其后继 |
Example
尝试用上述算法,计算以下代码的PFG
1 | b = new C(); |
初始时,WL里并没有内容,所以由第一个foreach语句将整个语句集合中的new声明加入到WL中来启动算法,所以这可以视作整个指针分析的起始部分,这让WL里有最初的信息
- WL: [<b, {o1)>, <c, {o3}>]
new处理完后,此时第二个foreach语句将处理assignment,给他们从等号右边向左边加一条边(a = b, d = c)
此时PFG中各元素的指针都是空的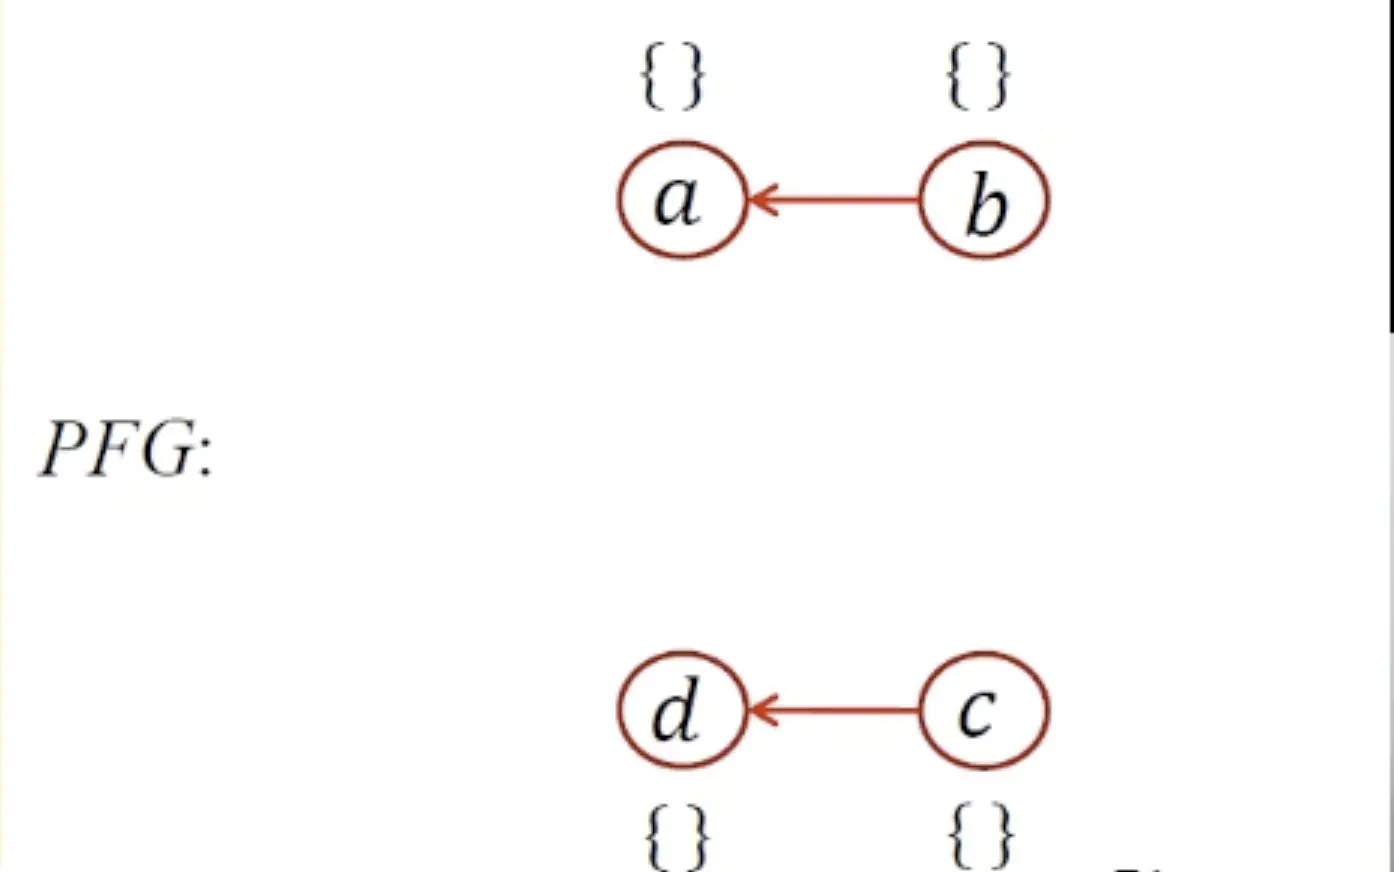
然后进入WL循环,首先取出<b, {o1)>这个pair - WL: [<c, {o3}>]
然后进行一个Propagate(b,{o1}),将b指向的对象集的增量(直接就是o1了,因为初始空)添加到b的指针集上,然后将b可达路径上的节点(也就是a)和这个增量添加到WL
那么将<a, {o1)>加入WL - WL: [<c, {o3}>,<a, {o1)>]
然后取出<c, {o3}> - WL: [<a, {o1)>]
将o3加到c的指针集,然后将<d,{o3}>加到WL - WL: [<a, {o1)>,<d,{o3}>]
接下来要处理的是c.f = a, d.f = d这两条store语句
根据算法
1 | if n represents a variable (e.g., x) then |
这里c指向o3,等号右边分别是a和d 那么要给PFG中a和d的节点都添加一条指向o3.f的边,
1 | // 添加边并触发传播 |
而这里因为pt(a)和pt(d)暂时还是空的,所以不需要更新WL
然后继续从WL取出<a, {o1)>
- WL: [<d,{o3}>]
这时将o1加到a的指针集,然后因为a有了指向o3.f的边,所以o1也要传到o3.f,所以将<o3.f,{o1}>加到WL - WL:[<d,{o3}>,<o3.f,{o1}>]
然后取出<d,{o3}>,同理,因为d有了指向o3.f的边,将<o3.f,{o3}>加到WL - WL:[<o3.f,{o1}>,<o3.f,{o3}>]
下一步轮到处理最后一个语句e = d.f 这个load语句,那么添加o3.f到e的边,这时,我们才完成对<d,{o3}>的处理
然后从WL取出<o3.f,{o1}>处理 - WL:[<o3.f,{o3}>]
首先将o3.f的指针集中添加o1,然后将他的后继e与这个增量{o1}添加到WL - WL:[<o3.f,{o3}>,<e,{o1}>]
下面处理<o3.f,{o3}> - WL:[<e,{o1}>]
如法炮制 - WL:[<e,{o1}>,<e,{o3}>]
这两个处理很简单就不写了,都是直接简单的把o1o3加到e的指针集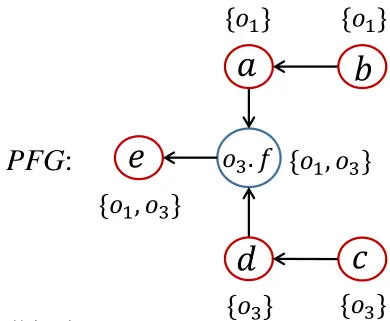
这是最终的结果
这里就结束了指针分析(上)的学习
主要学了
Key points
- Rules for pointer analysis
指针分析的规则 - PFG(Pointer flow graph)
什么事指针流图 - Algorithm for pointer analysis
指针分析算法是什么样的
这里我们用到的都是流不敏感的指针分析,因为在java这种oo语言中,流敏感的分析开销很大而且精度提升没有明显提升,但是上下文敏感又明确研究表明可以获得明显提升,并且维持较好的运行效率
Foundations-2
本课将给出一个包含函数间分析的适用于全程序的算法
主要关注与在指针分析中如何处理方法调用
考虑下面这样一小段代码,显然,我们必须要有过程间的分析,才能有更准确的分析结果
1 | void foo(A a) { |
比如如果我们不知道前面a对象调用过哪些方法,就不知道a的指针集pt(a),而且如果a.bar()不知道具体调用的是哪个方法,也就不知道给b传哪些指针集了
所以指针分析在过程间的情况下,它也需要call_graph
我们之前学习的建call_graph用的是CHA,但是这种方法的精度太低了,会建出很多虚假的边
CHA只考虑调用者的类型,而根据指针分析计算出来pt(a)实际所指的对象,可以得到比CHA更准的结果
老师这里提到,我们靠指针分析能够建出更准的callGraph,反过来又能进行更准的指针分析(因为虚假的callgraph 会引入很多多余的子项关系)
这我最近自己写sast的尝试得出的经验一致,当前期建的图有细微的准确度丧失时,会影响后续流程很多,无论是额外的分析时间,还是误报的结果
这节课将学习具体地如何做过程间的指针分析
首先我们要先知道当一个方法调用发生时,发生了哪些事情?
- Dispatch
- 传receive Object
- 传参数
- 传返回值
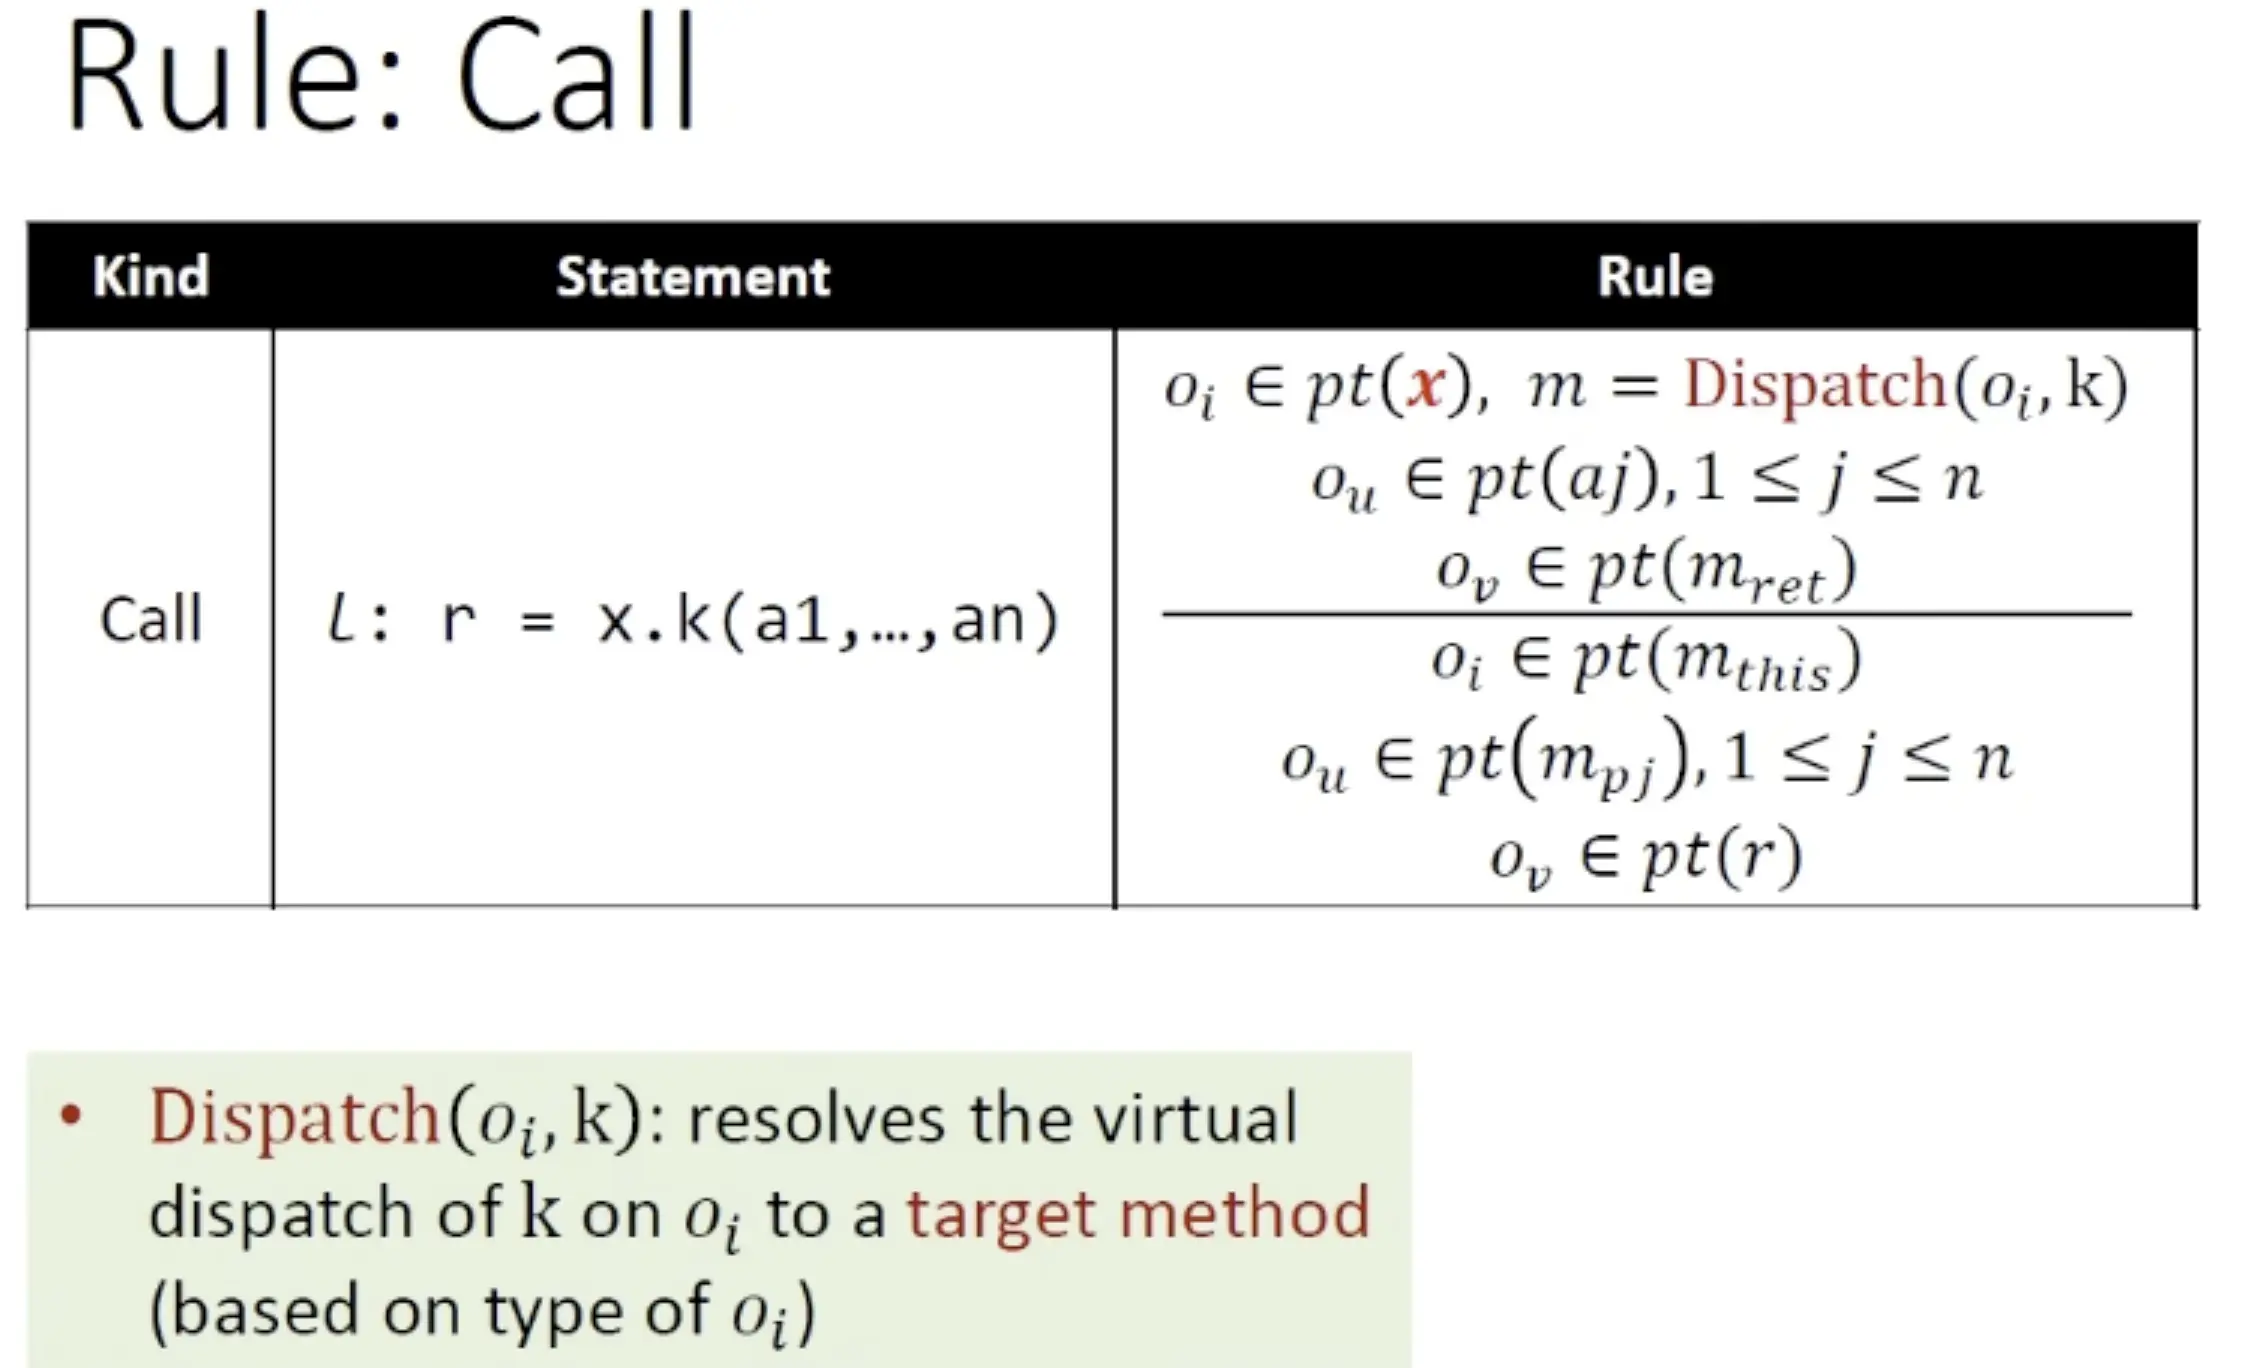
1.首先取出了pt(x)里的对象Oi,然后拿Oi和k去调用了Dispatch,找到实际调用的目标方法
2.然后要将x这个变量指向的对象传到目标方法的this variable,记作m.this
3.然后传参数,用aj来表示第j个实参,mpj表示第j个形参,然后我们在指针分析时,在PFG中构建起实参到形参的边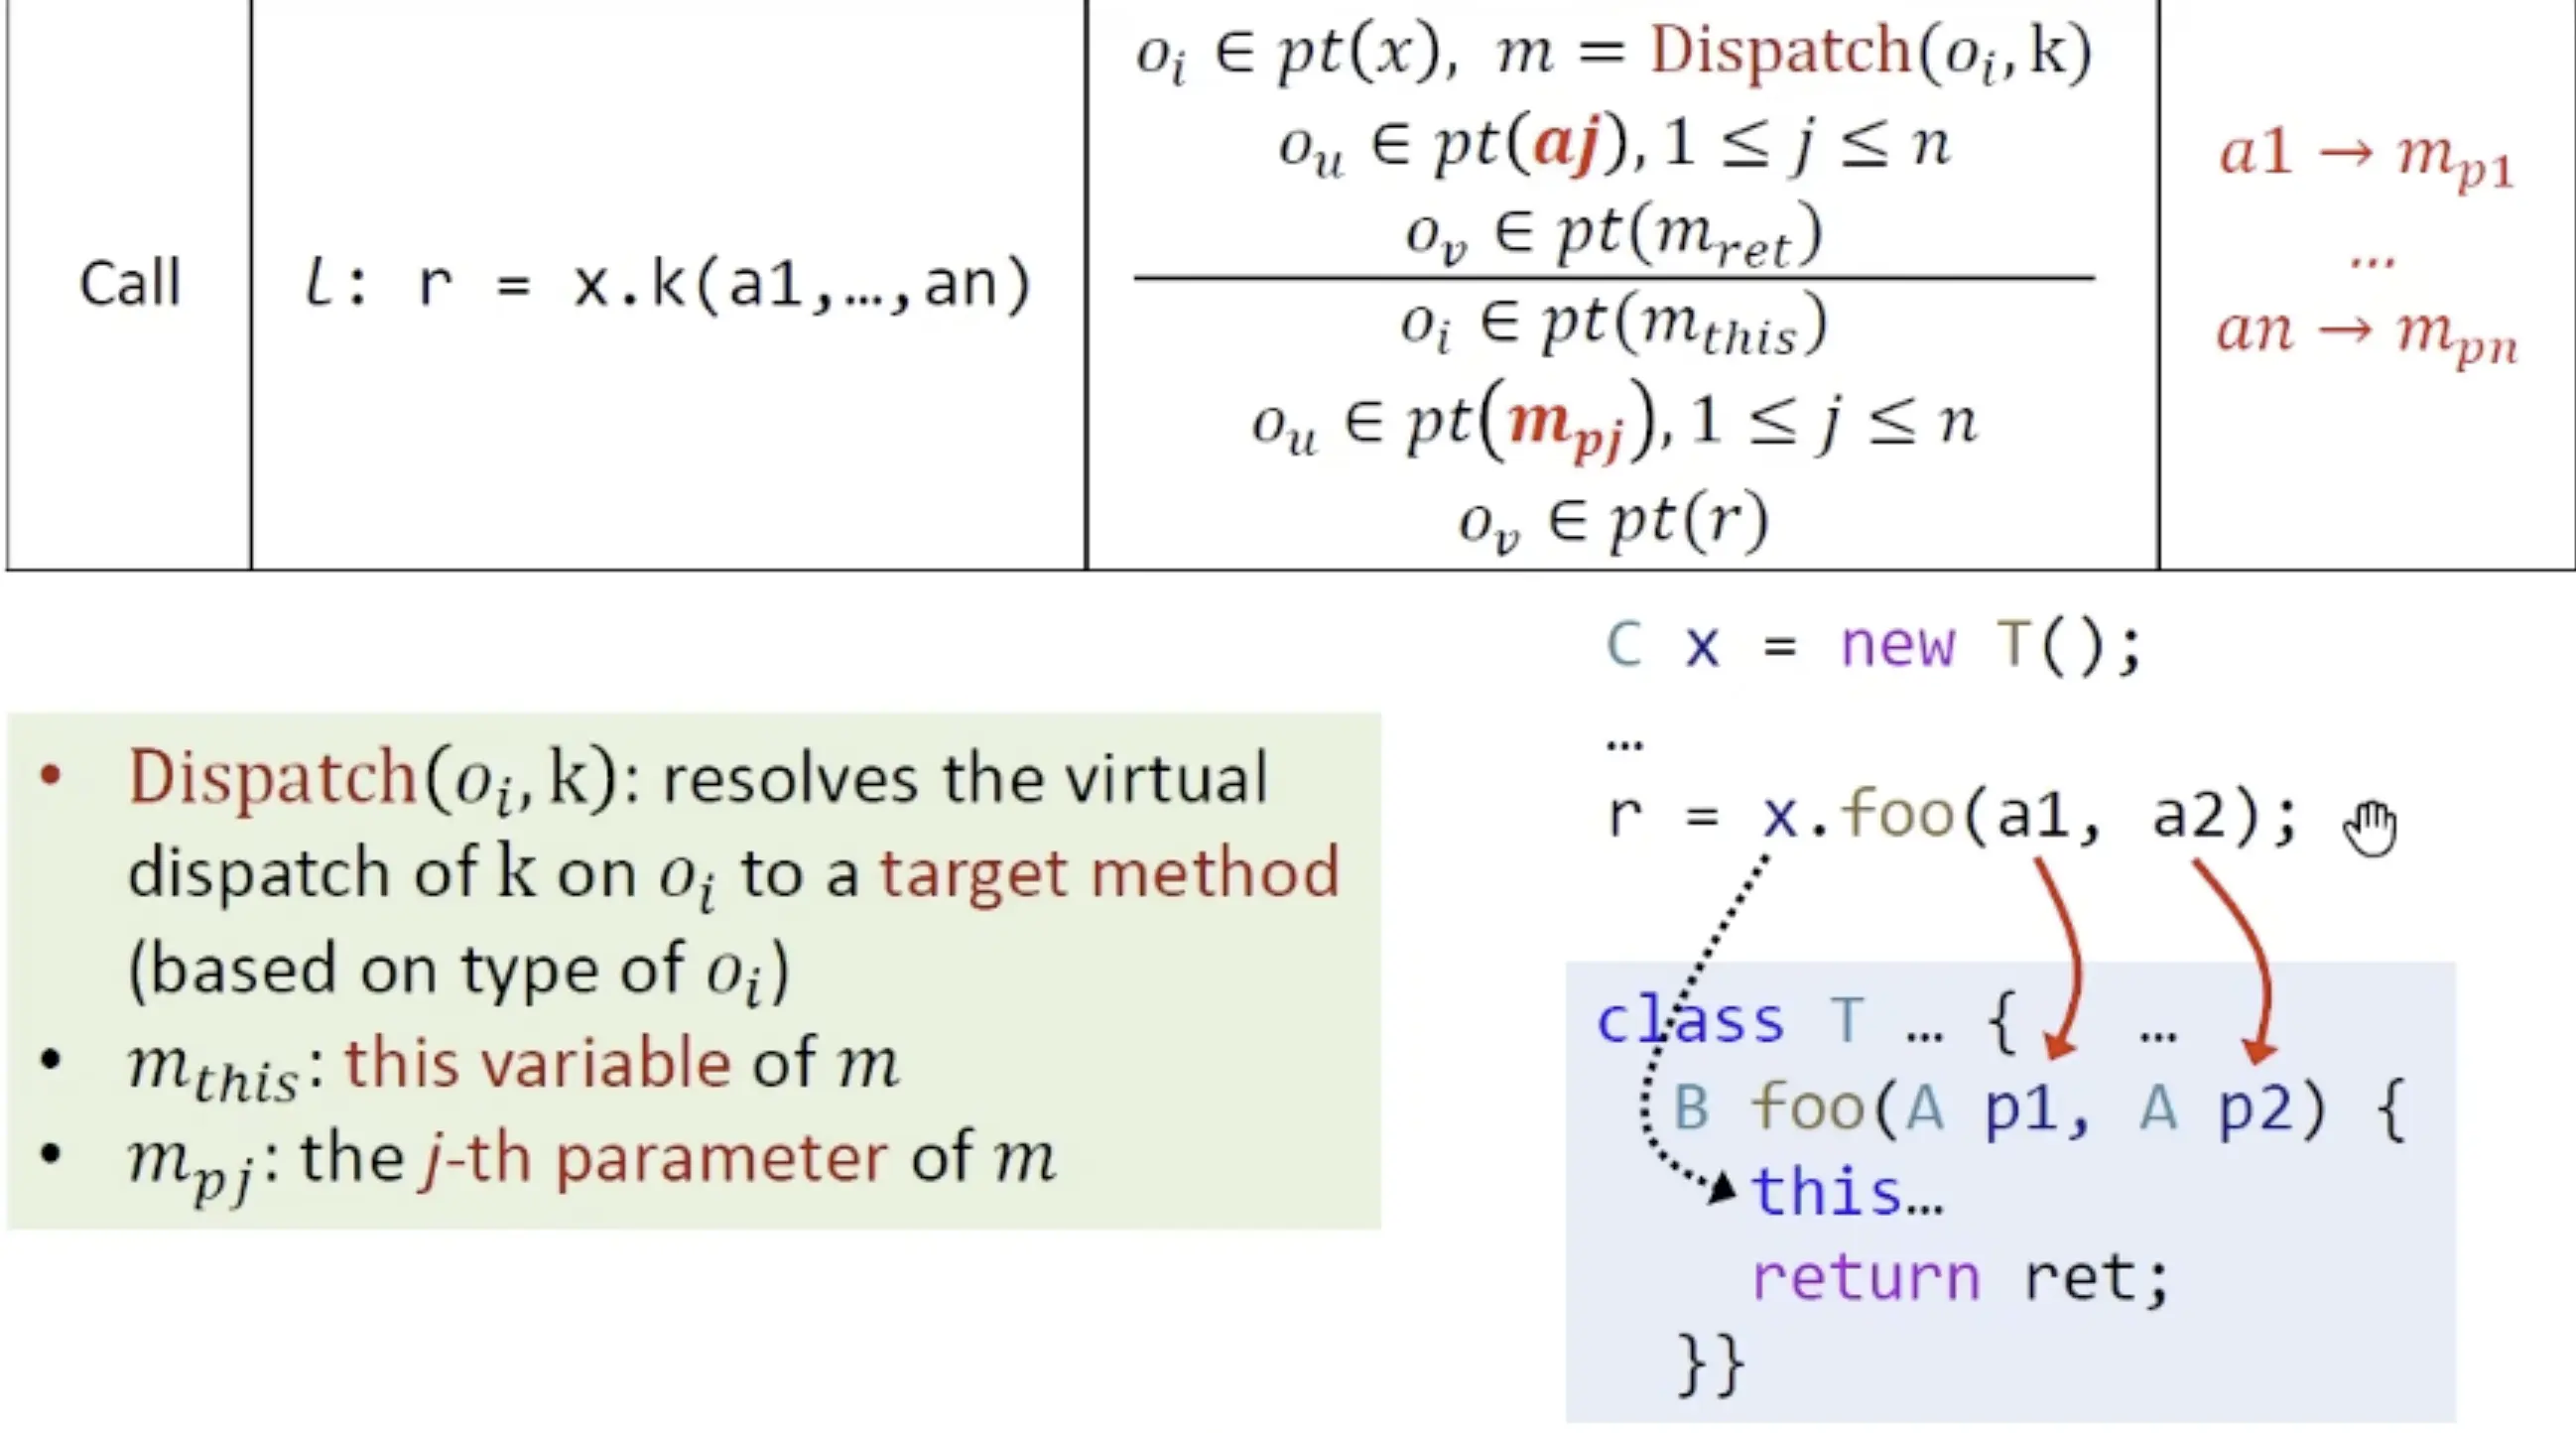
4.传返回值 就是将调用方法的返回值所指向的对象传给调用这个方法的对象,让他也指向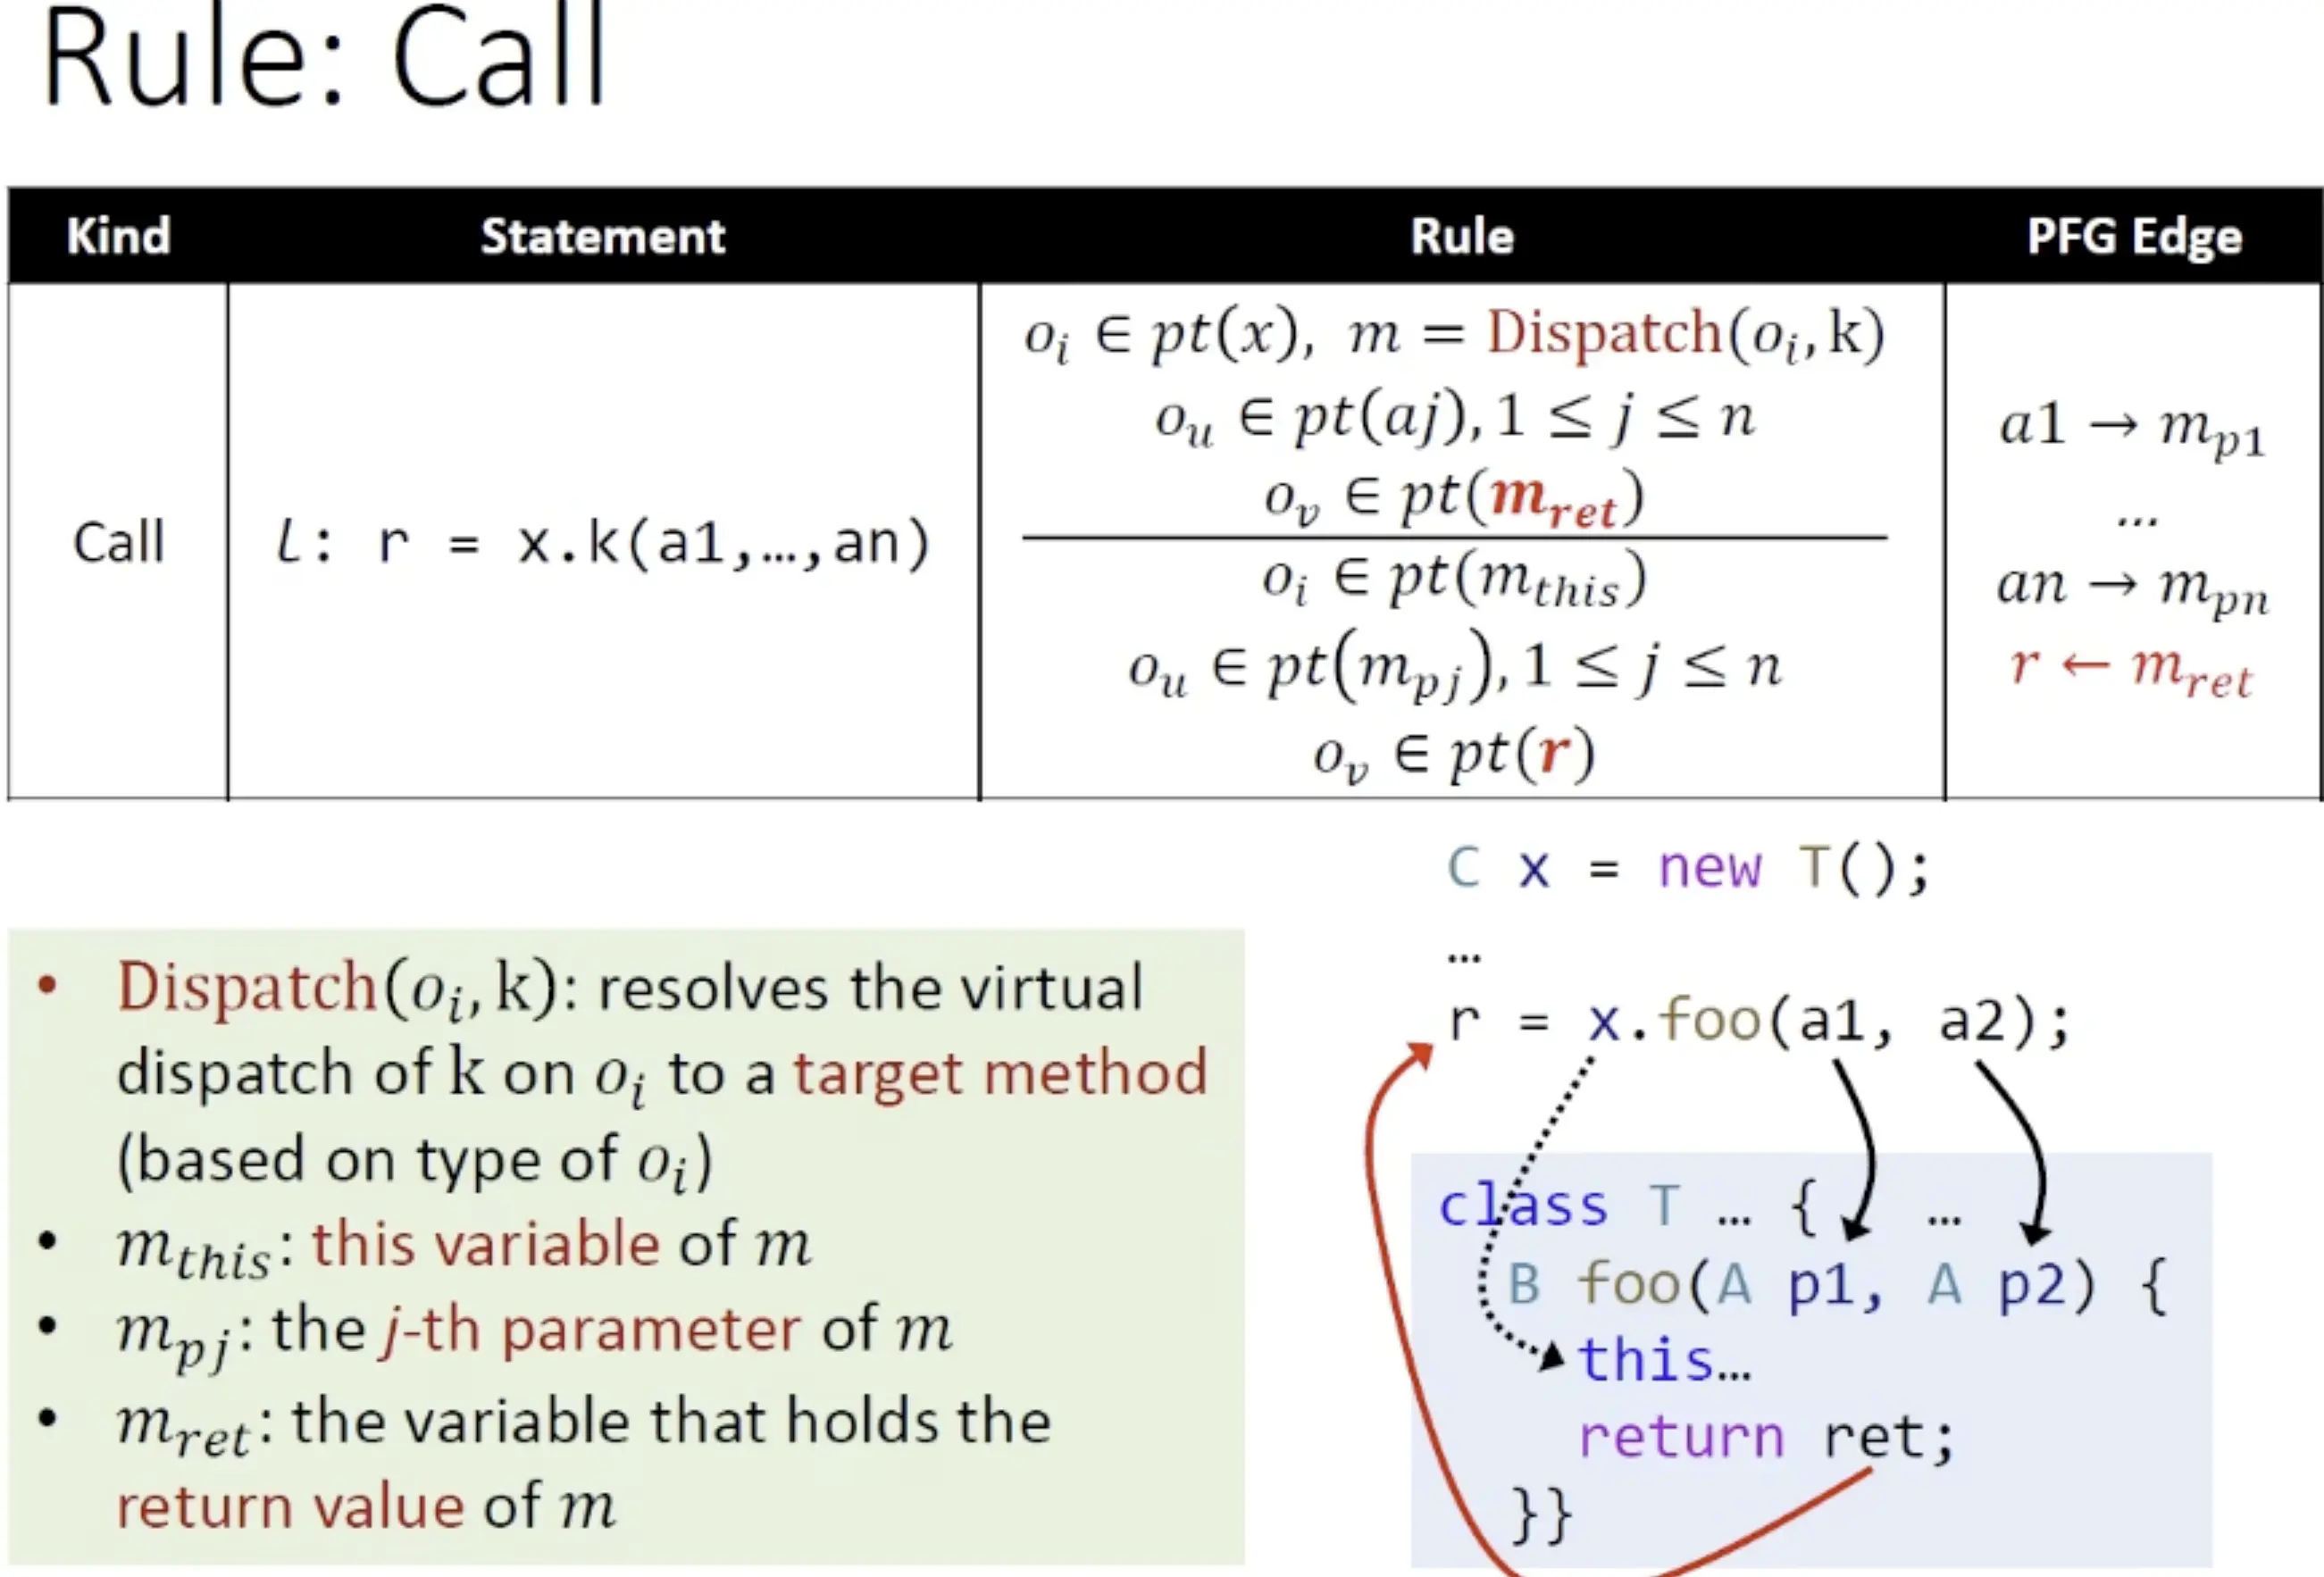
注意到,这里的x->this没有在PFG连上边,