前面的分析中我们都是在过程内分析,也就是不处理方法调用的
过程内分析时,我们通常对调用作最保守估计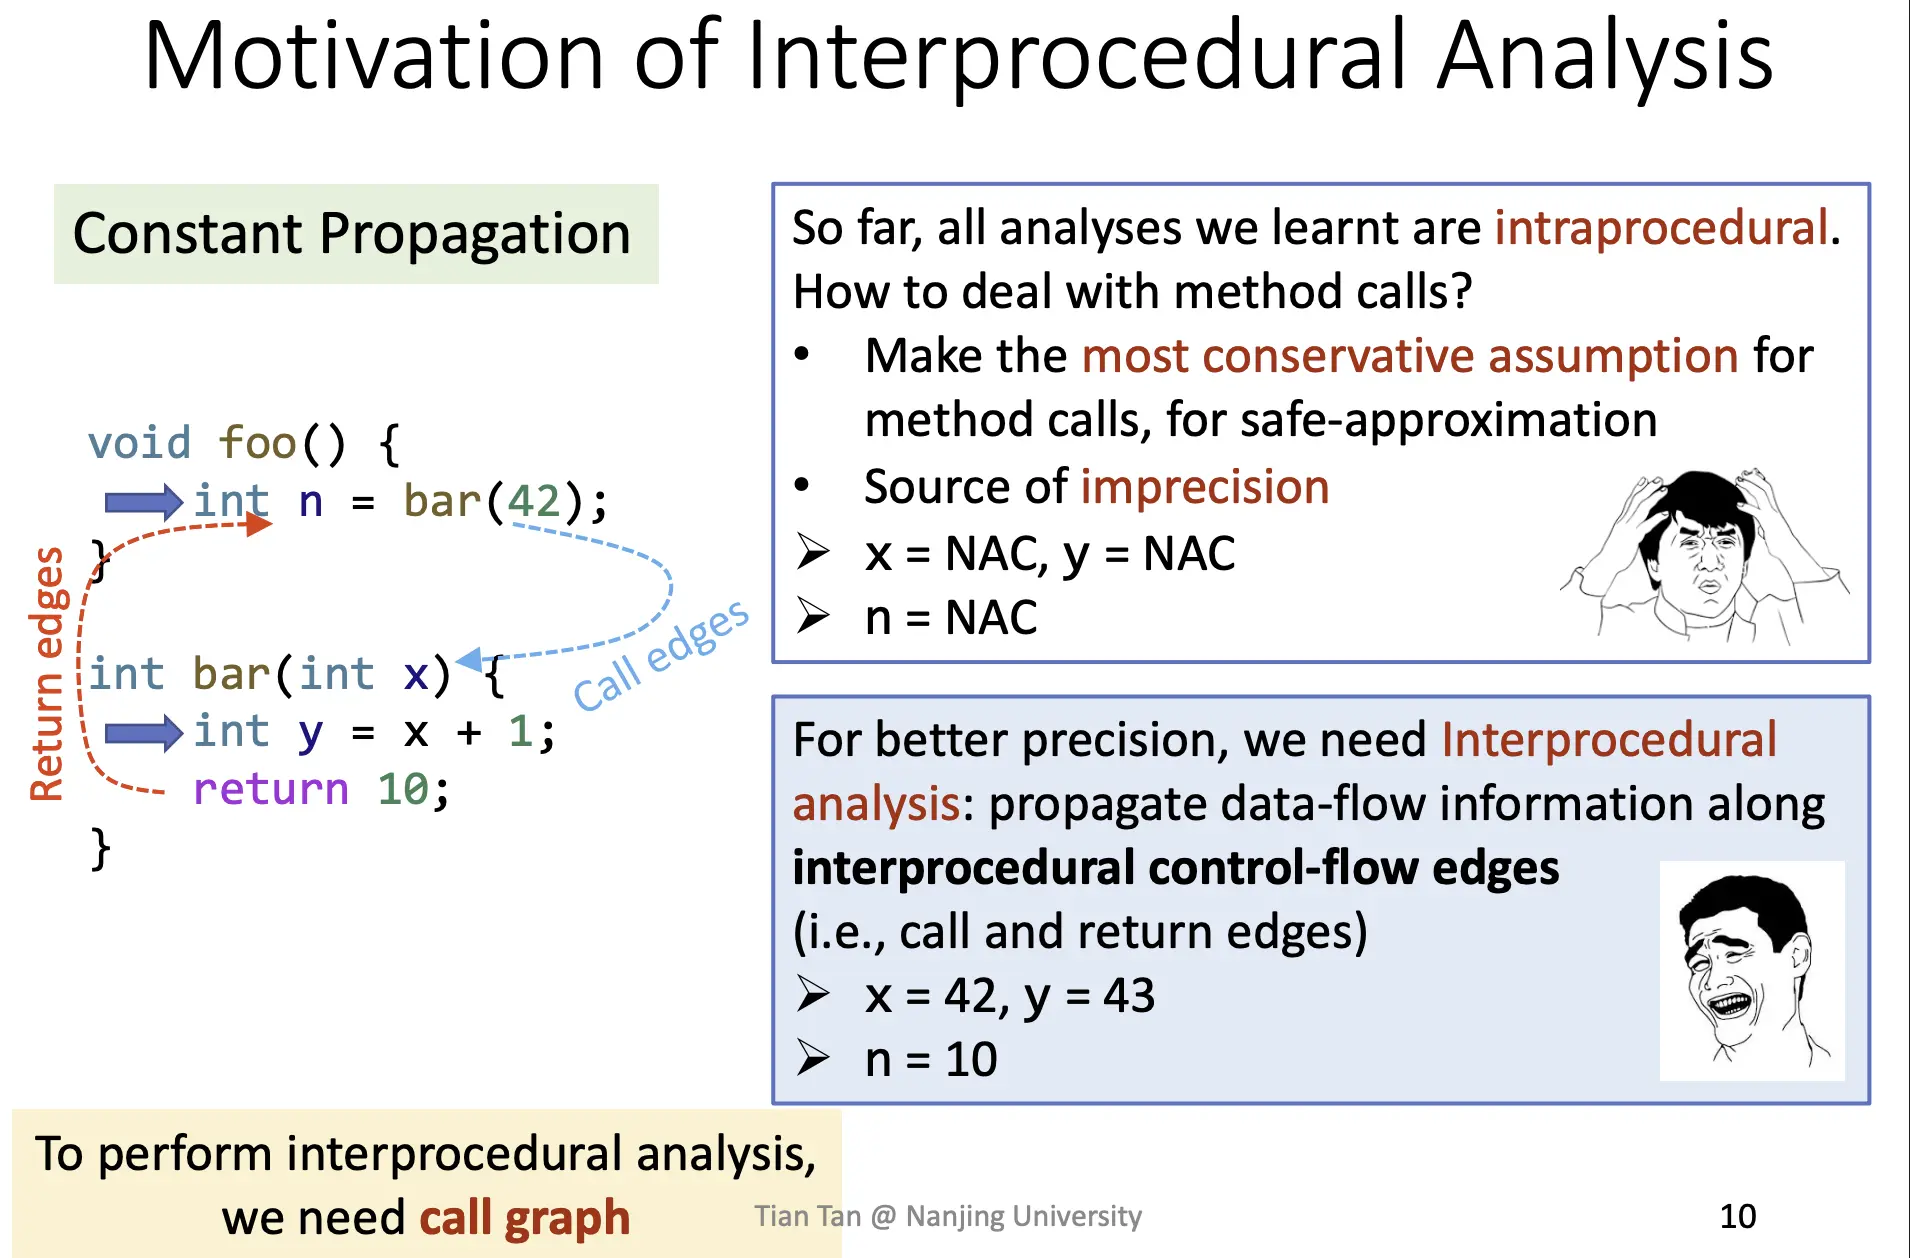
那上节课最后引入的常量传播分析举例,比如图中这个程序,显然n=10,x=42,y=43都是常量,但是因为我们不处理调用且作最保守估计(为了safe),只能把他们都是为NAC也就是非常量
这就是要做过程间分析的必要性,为了更高的精度
而做过程间分析的基础是知道整个程序中的各种调用关系,这就需要我们构建一个Call Graph调用图
Call Graph
调用图可以视作一系列调用点和调用边的集合,每个调用点通过调用边连接到调用方法
而我们这们课的call graph主要是针对oo(面向对象)语言也就是java的
这里列出4种方法中的Class hierarchy analysis (CHA)和Pointer analysis (k-CFA)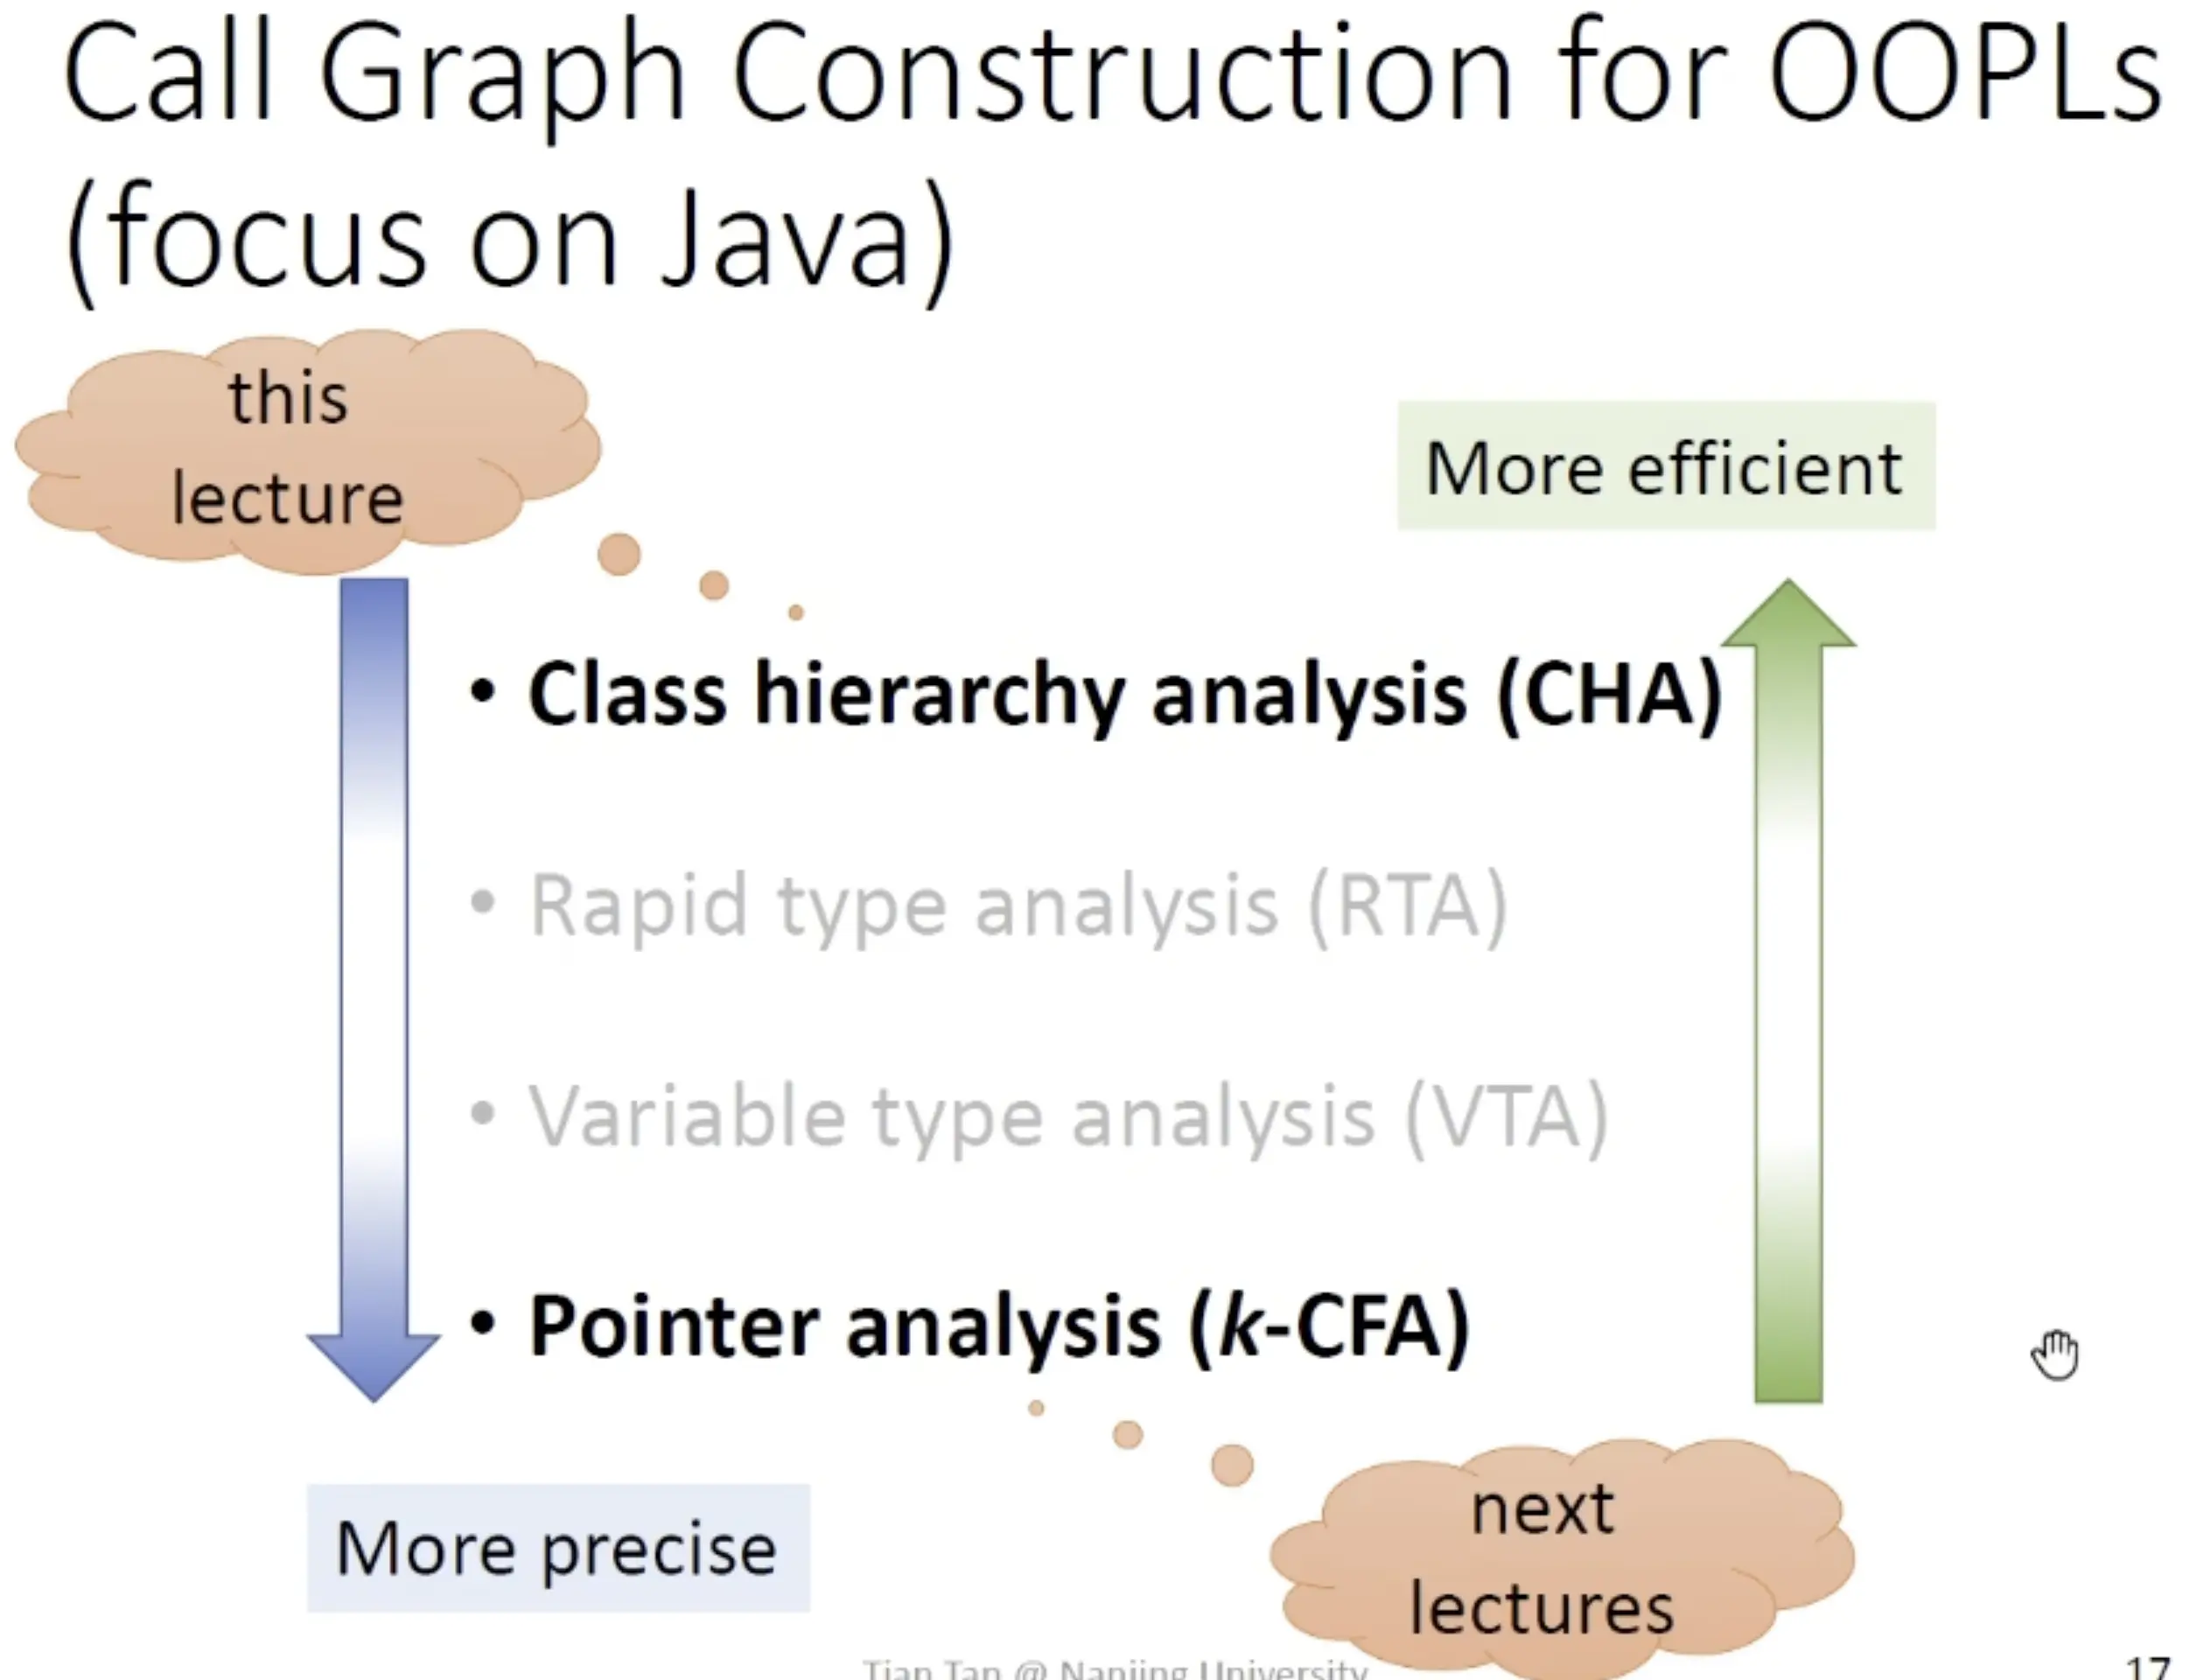
越往上越不精确但是越快,越往下越精确速度也最慢
java里的调用主要分三种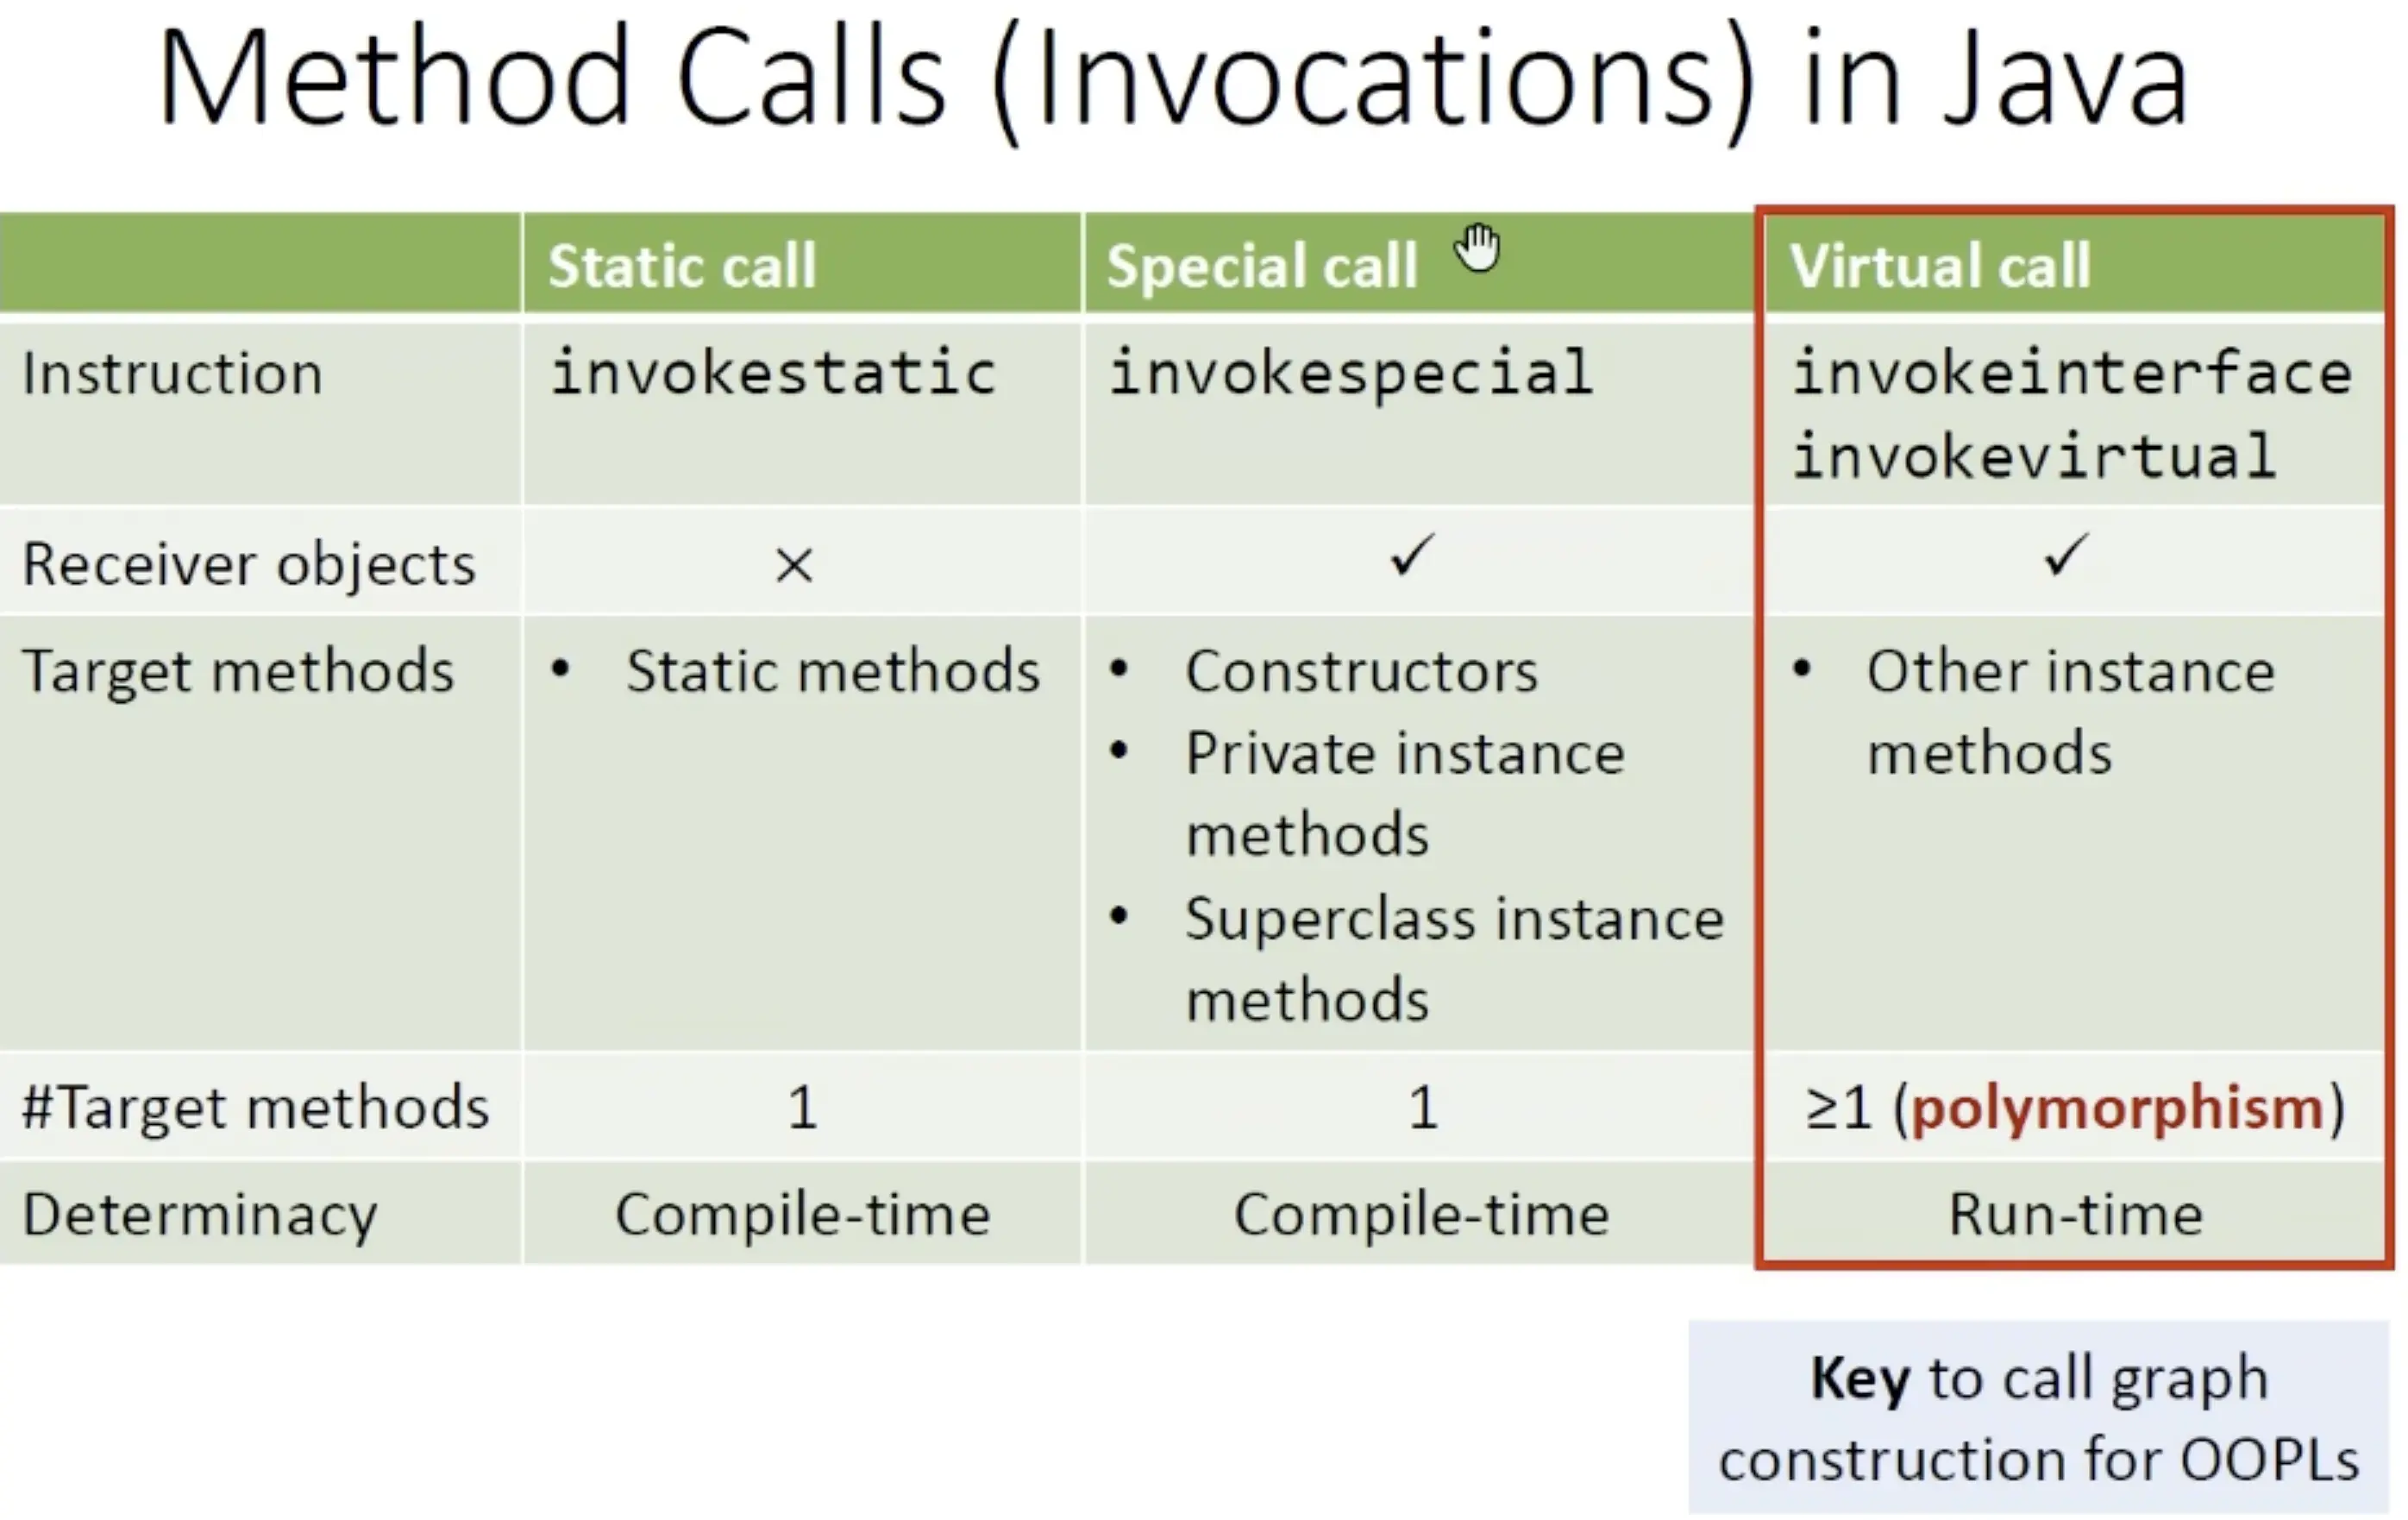
而其中对构建调用图最难也是最关键的就是virtual call
先了解下method call中的关键步骤 method dispatch
在程序运行时 一个virtual call是需要在动态运行时去动态的解它的目标方法的,这个过程中涉及到两个要素,第一个要素就是receive object的具体类型(如下图的o指向的对象的类型),第二个就是call set这个方法的签名(如下图foo方法),求解调用目标过程我们就叫做method dispatch
signature签名在这门课中的定义如图,通过这个签名可以唯一地确定一个方法
第一个部分表示定义在哪个类,第二个是方法名字,第三个是descriptor包括返回类型和参数类型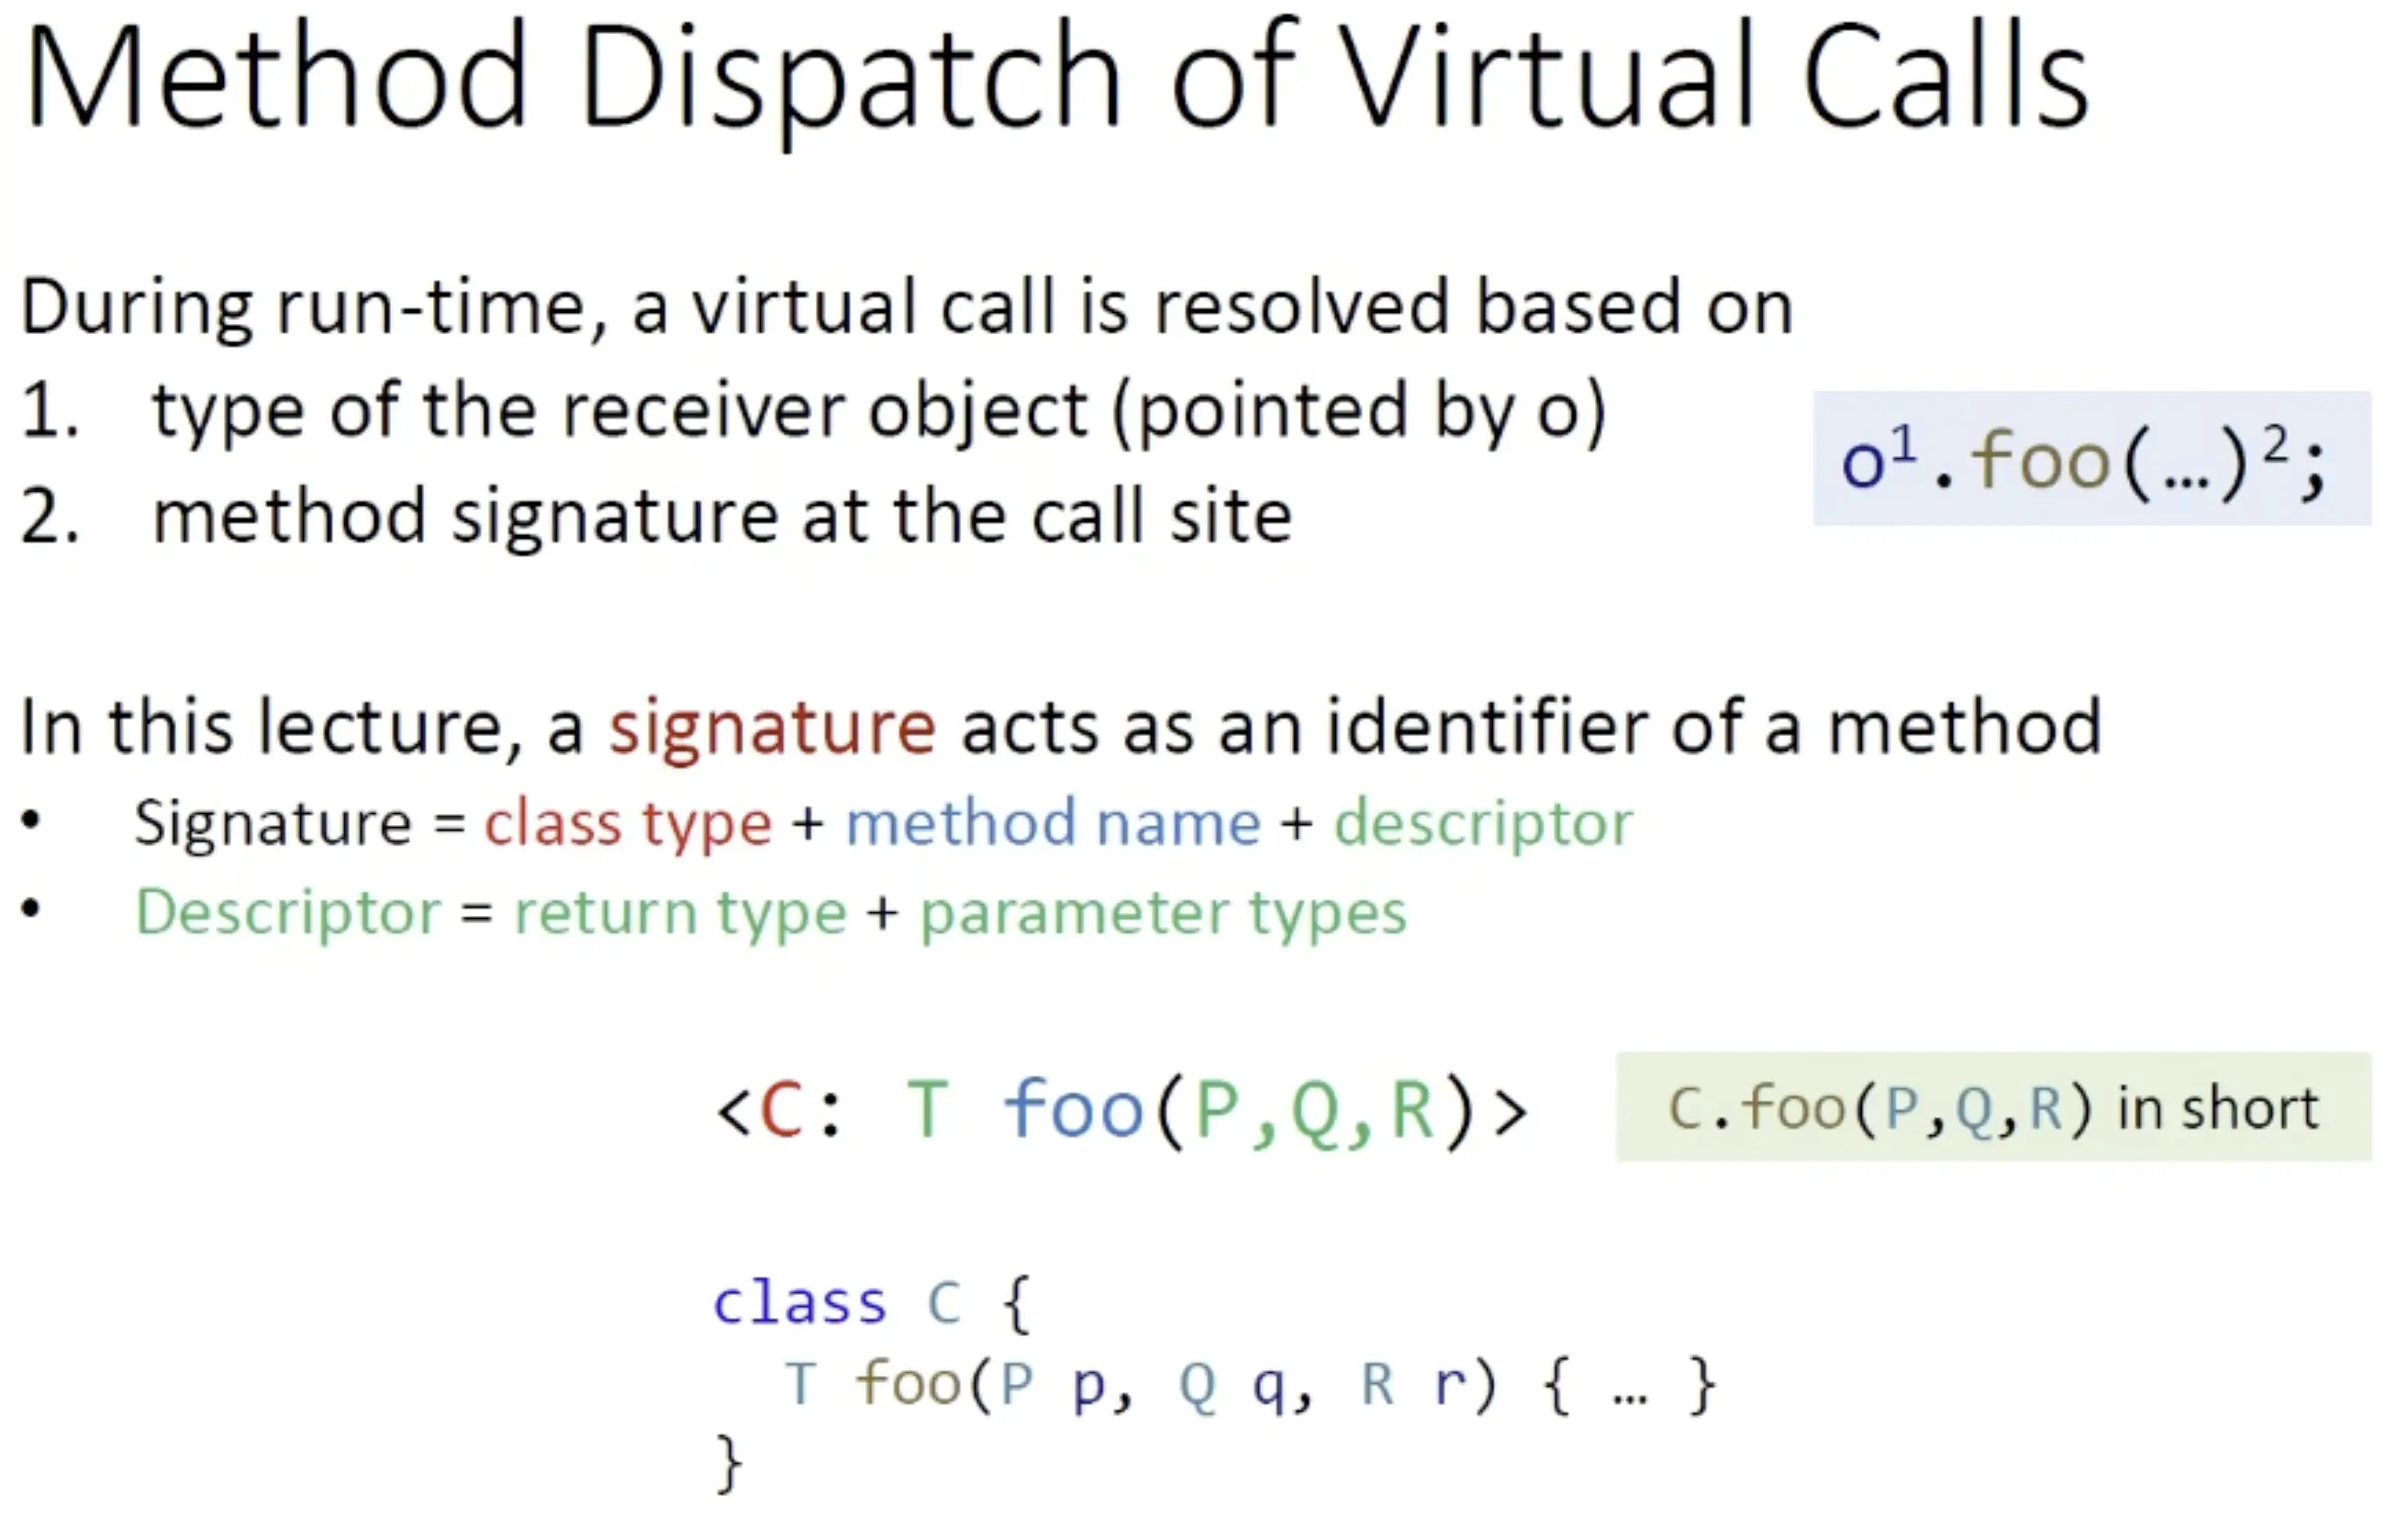
这个签名的格式也是soot中使用的类型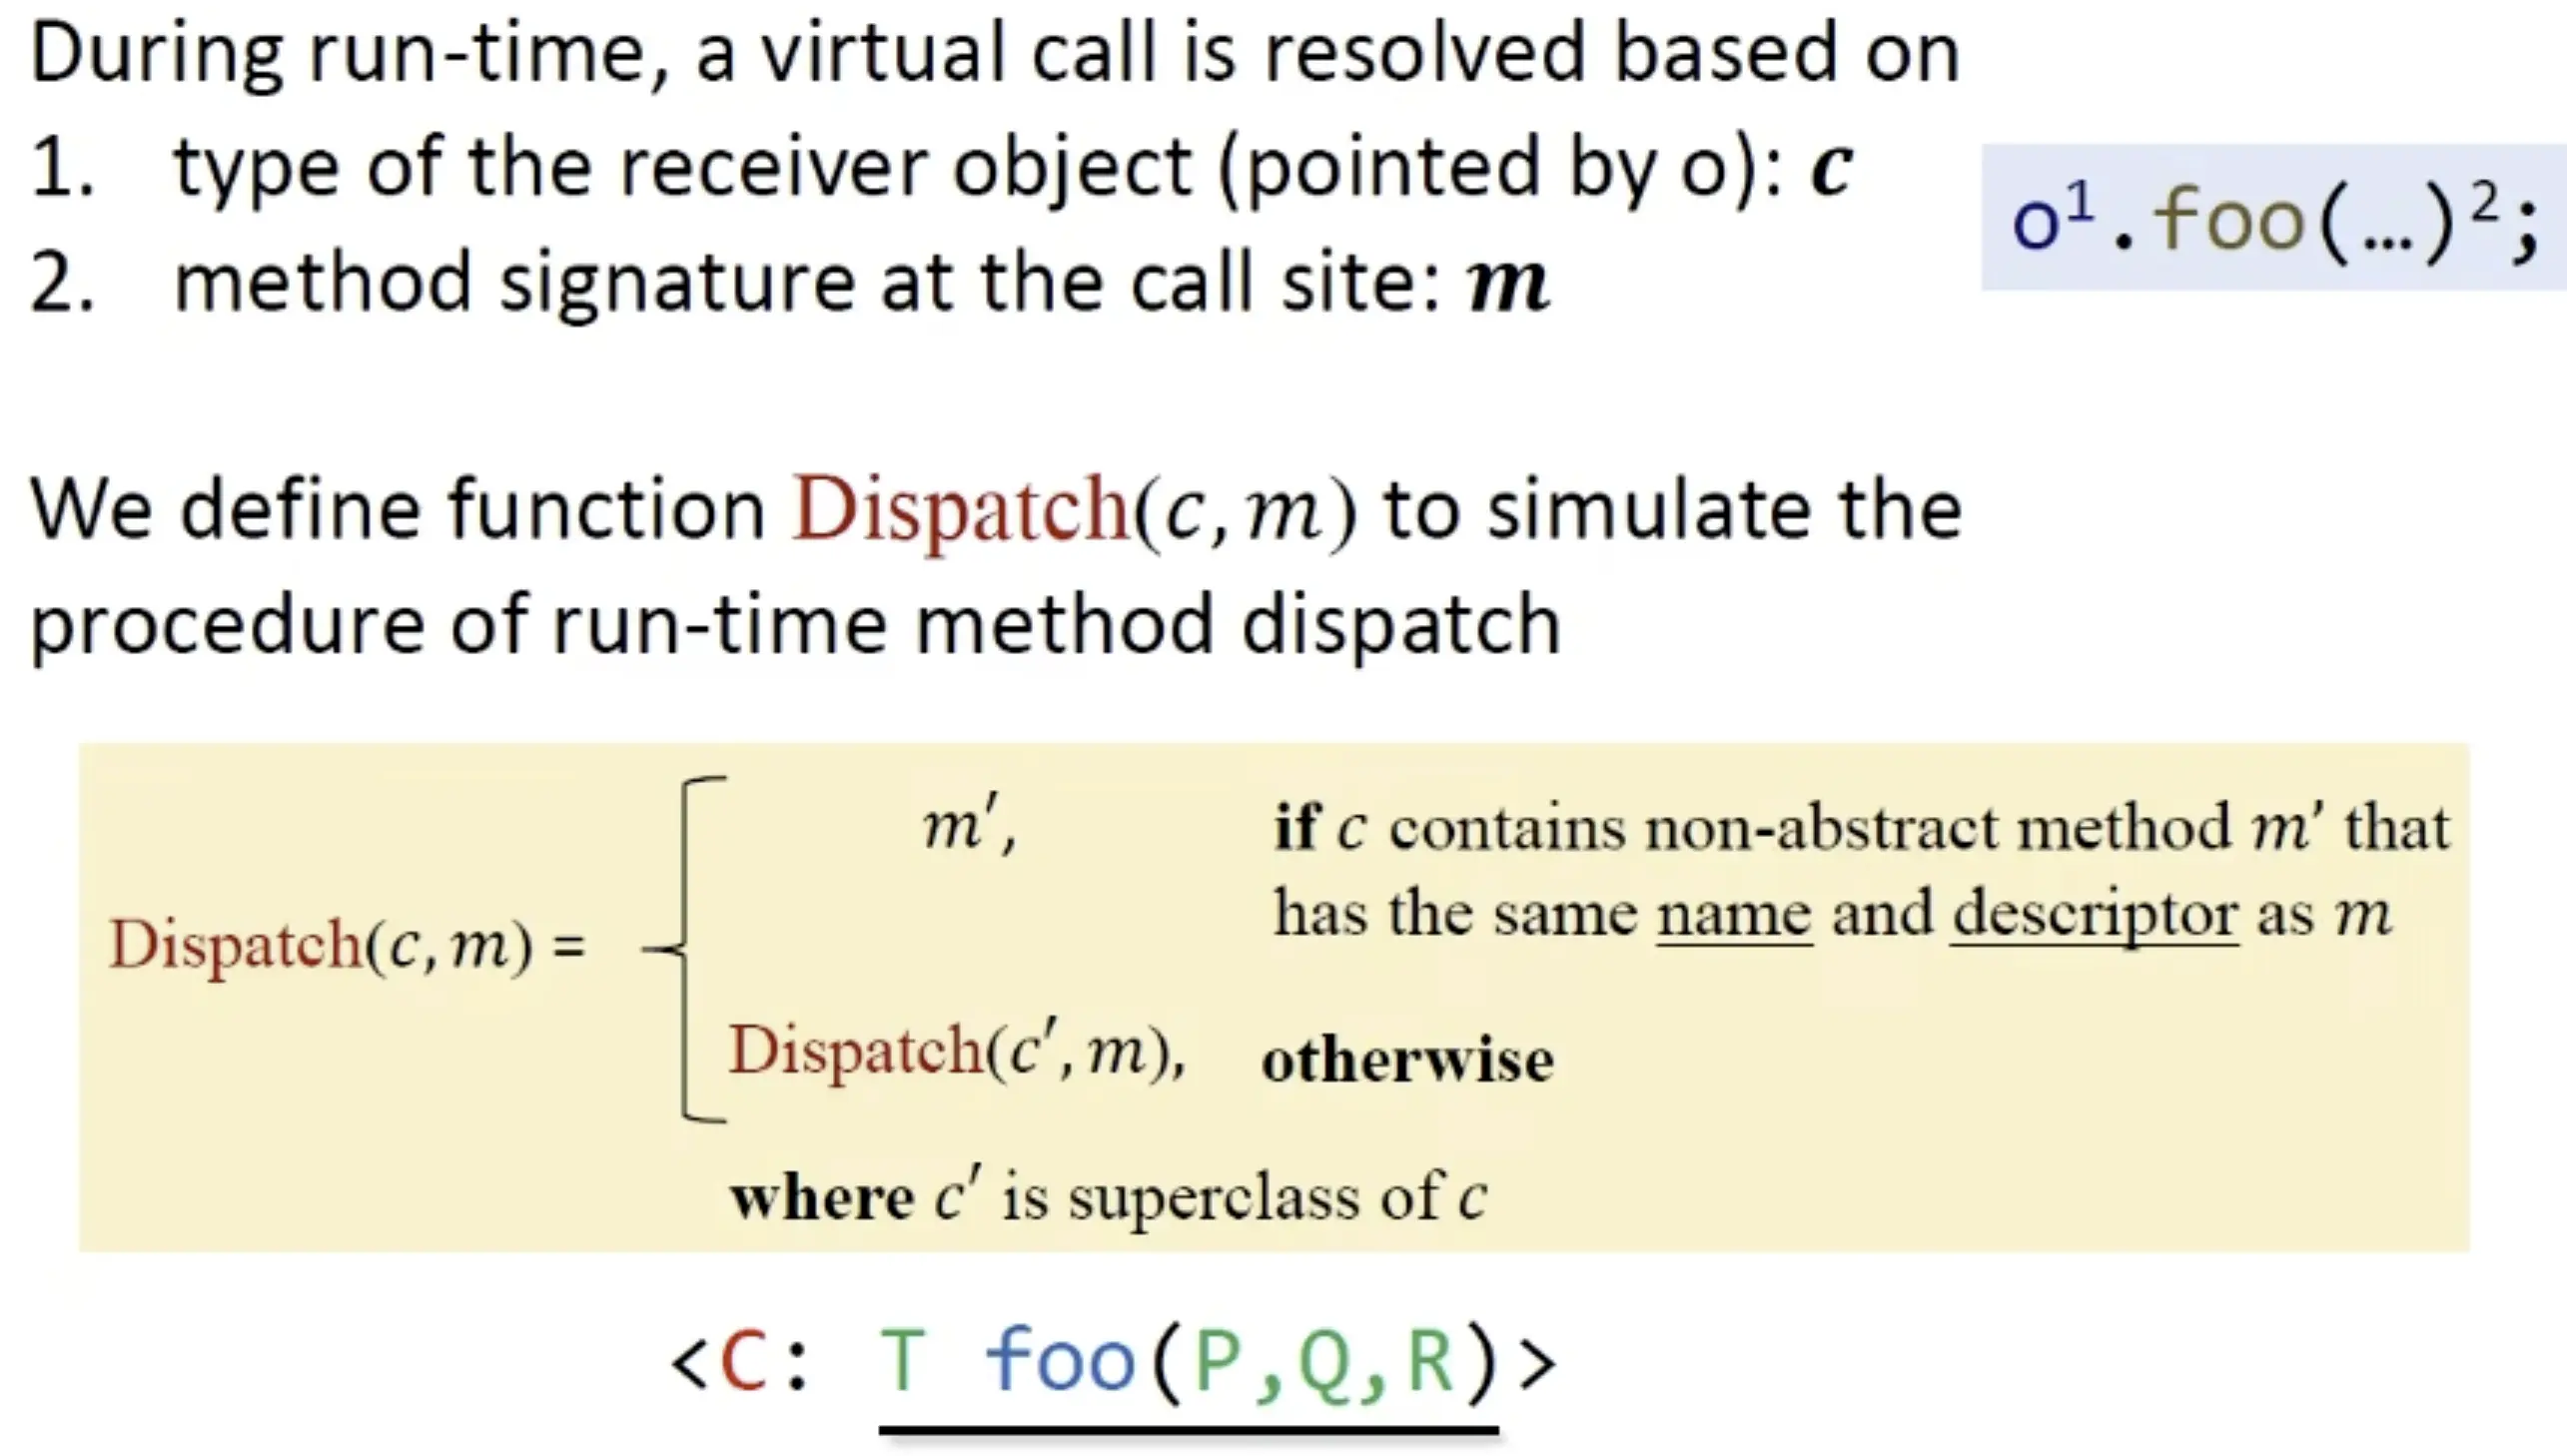
而dispatch求解目标方法的过程可以抽象为上述公式,其中c是接受方法返回的对象,m是方法签名,这个公式的意思是,如果对(c,m)进行求解,得到了一个非抽象(有具体方法体的)方法m‘并且这个方法也有和m一样的名字和descriptor,那么就将m’方法作为求解结果
反之没有找到这样的一个m‘方法的话,那么就将c的父类c’替换c进行求解,换句话说就是在c的父类的方法中寻找m‘方法
示例如下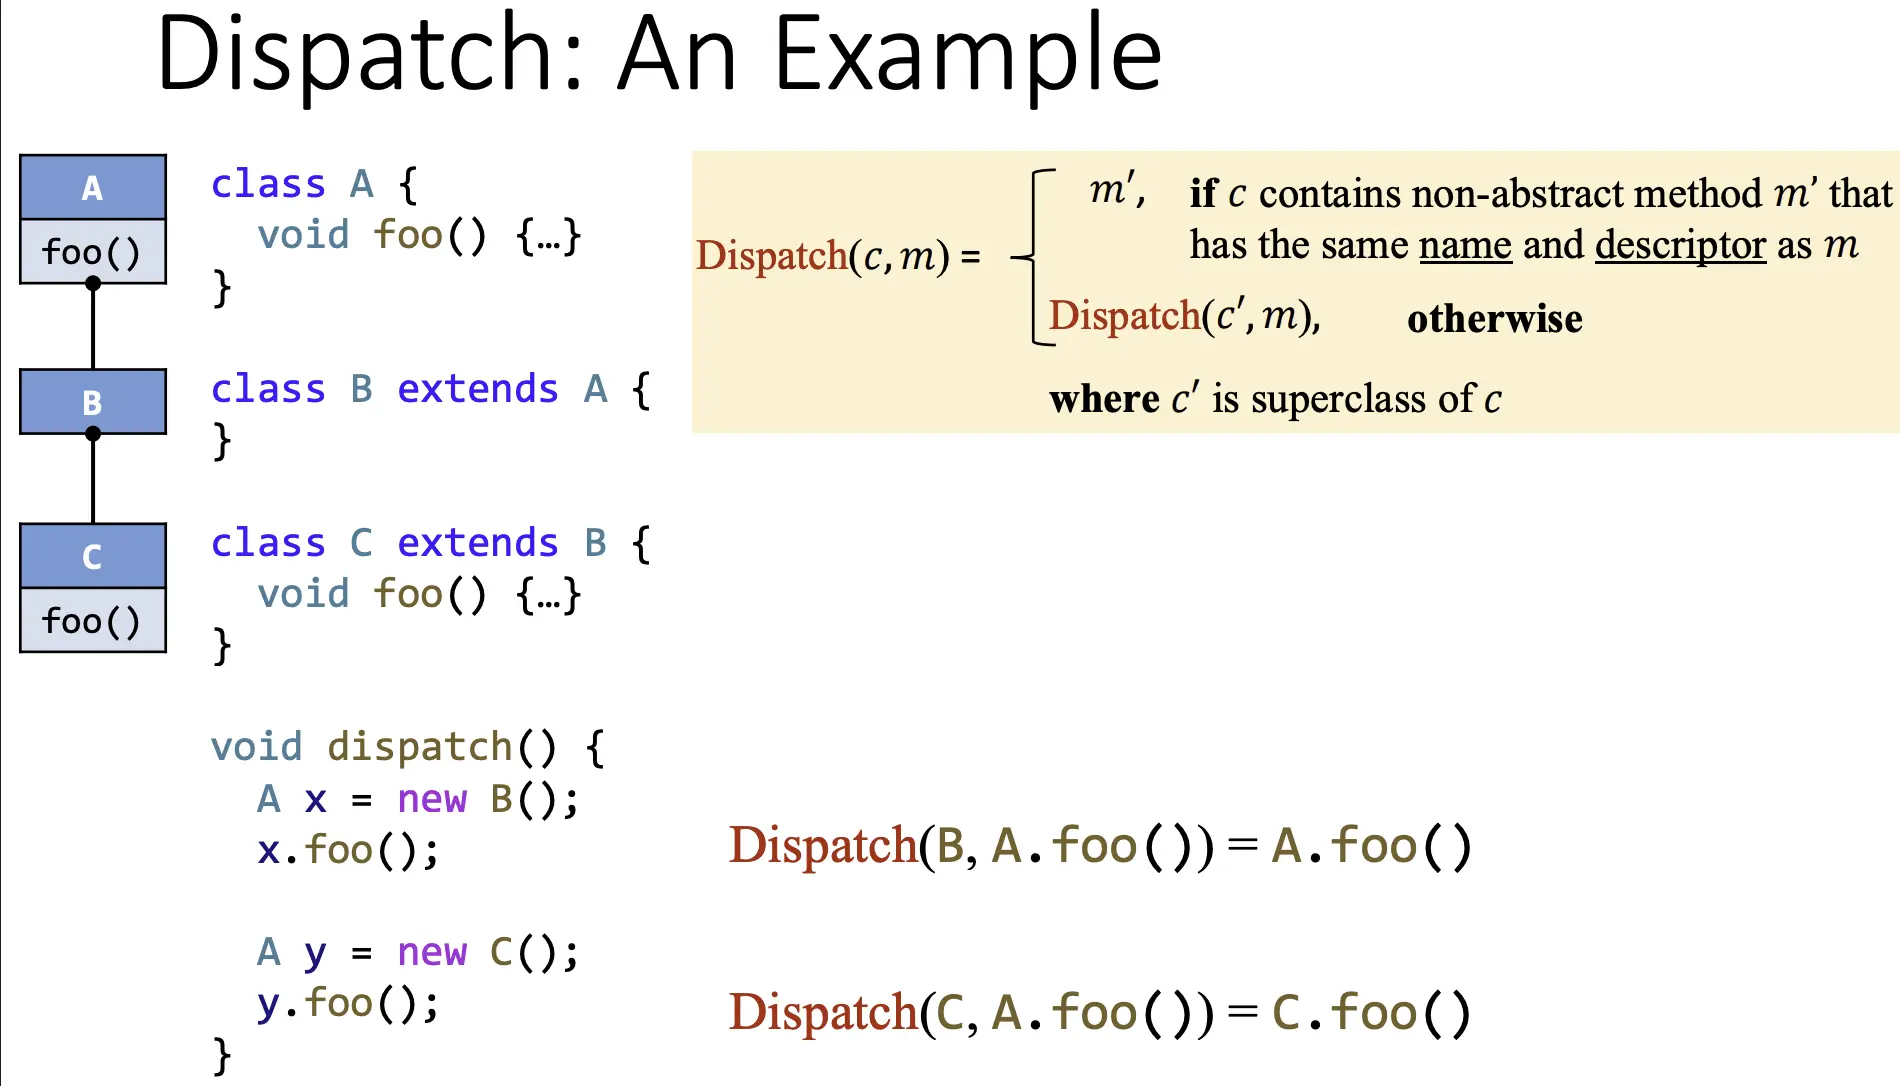
Class Hierarchy Analysis* (CHA)
这是解程序的call graph的一个方法,它需要程序的class hierarchy information信息,也就是程序中类的信息,类之间继承的信息
1 | A a = ... |
如这个例子,a这个变量的declared type是A,那么CHA就会根据A的方式去算目标方法
CHA的思想是
• 假设接收变量 a 可能指向A类 的对象或所有 A 的子类
• 通过查找类 A 的继承层次结构来解析目标方法
我们定义Resolve(cs)表示用CHA去求解cs可能的目标方法
首先取出这个方法的签名,因为要根据这个签名来找到目标方法
1 | Resolve(cs) |
这个算法分为三个分支,static call, special call, virtual call
static call
1 | class C { |
那么cs直接就是 C.foo(x, y); m是 <C: T foo(P, Q)>
这是最简单的调用类型
special call
special需要处理三种情况,构造函数,私有方法,父类方法,这里以父类方法为例
1 | class C extends B { |
可以看到C类中用的是super调用,因为C继承自B类,所以实际继承的是B类的签名
cs super.foo(p, q);
m ‹B: T foo(P,Q) >
c^m B
而看到算法里为什么已经知道是继承自B,却不直接将B类的方法作为目标方法,而要进行DIspatch(c^m, m)呢,这是因为我们不知道B是否有这个方法,可能B也是继承自A或者其他什么类的
1 | class C extends B { |
而special call的其余两类,似有方法和构造函数,都可以直接找到目标方法
所以直接用Dispatch(c^m, m)可以囊括这3种情况
virtual call
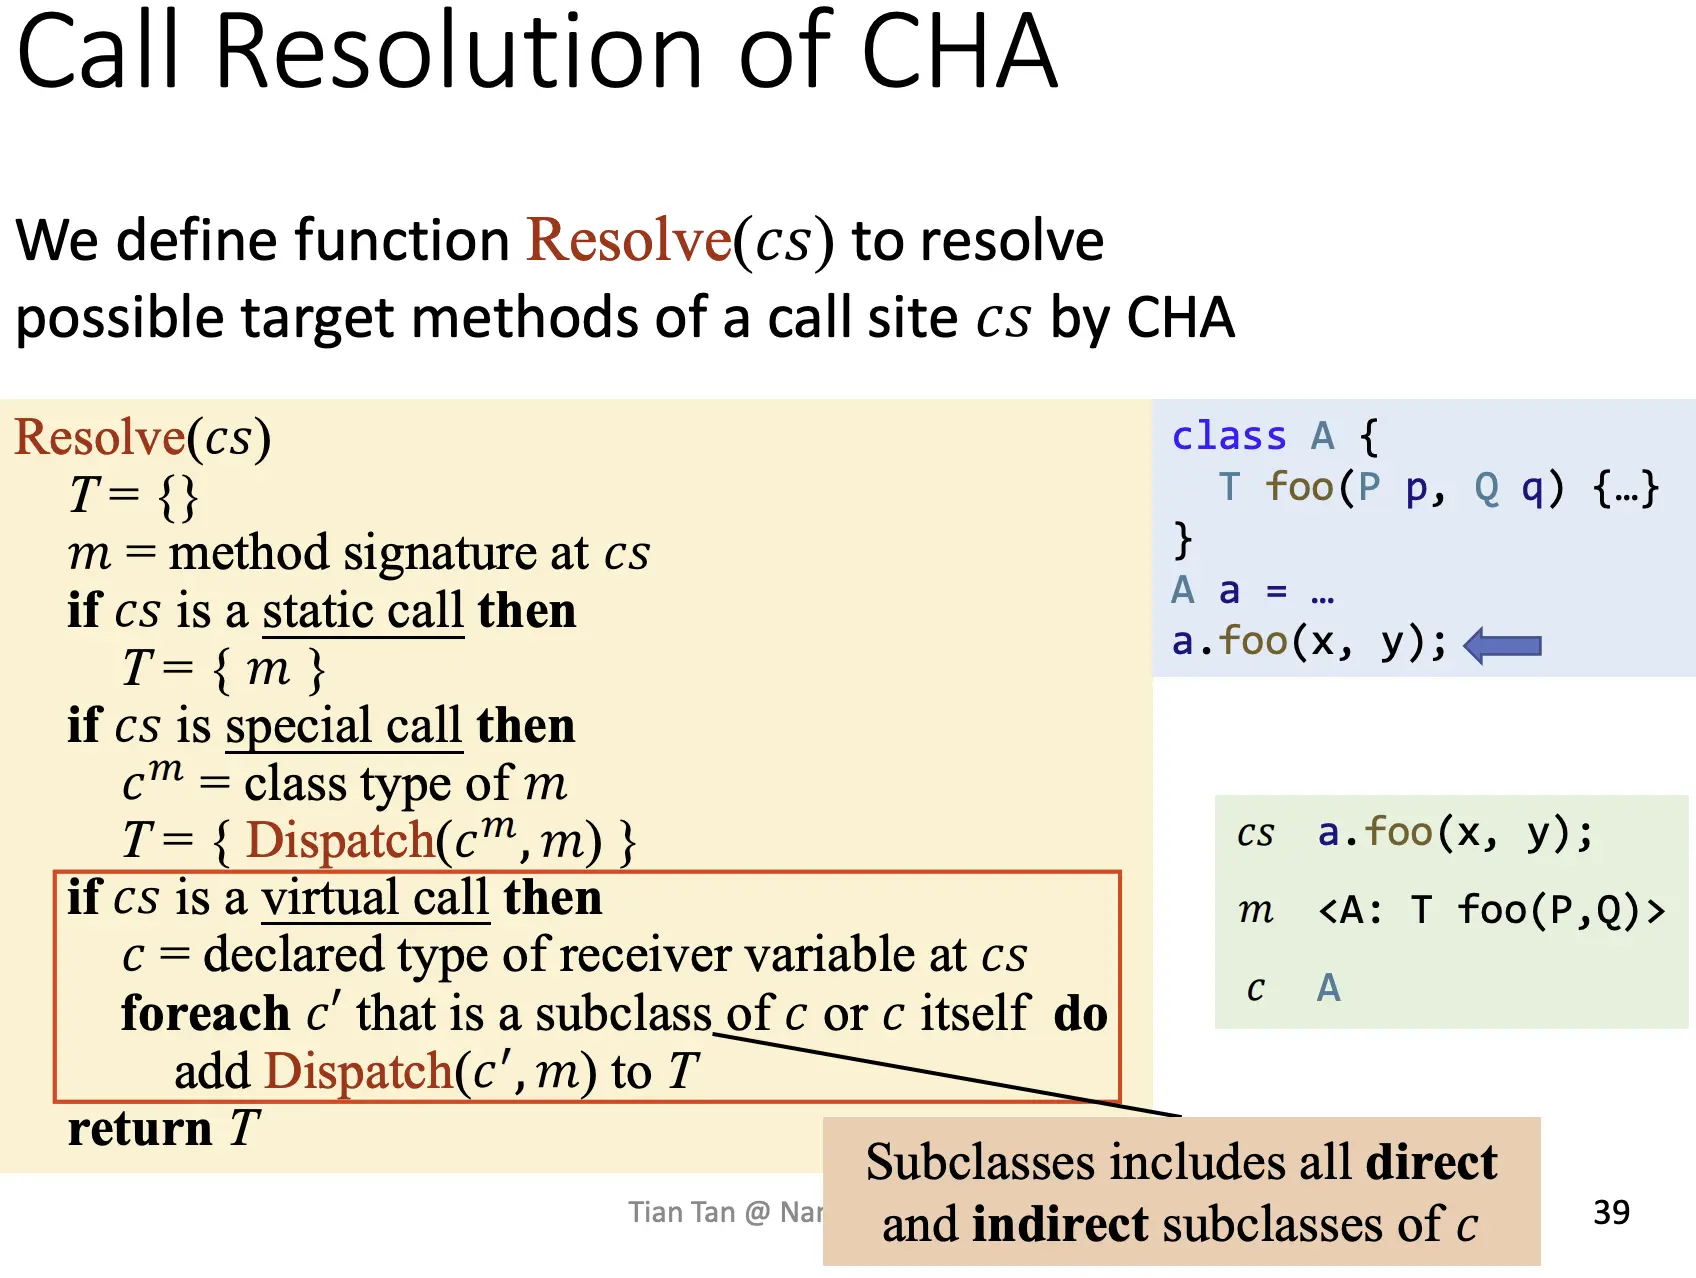 这是最tricky的一个处理方式
首先取出receiver变量的声明类型,也就是C,然后会对c自己和c所有的子类(包括所有继承树上的子类)都调用Dispatch(c‘,m)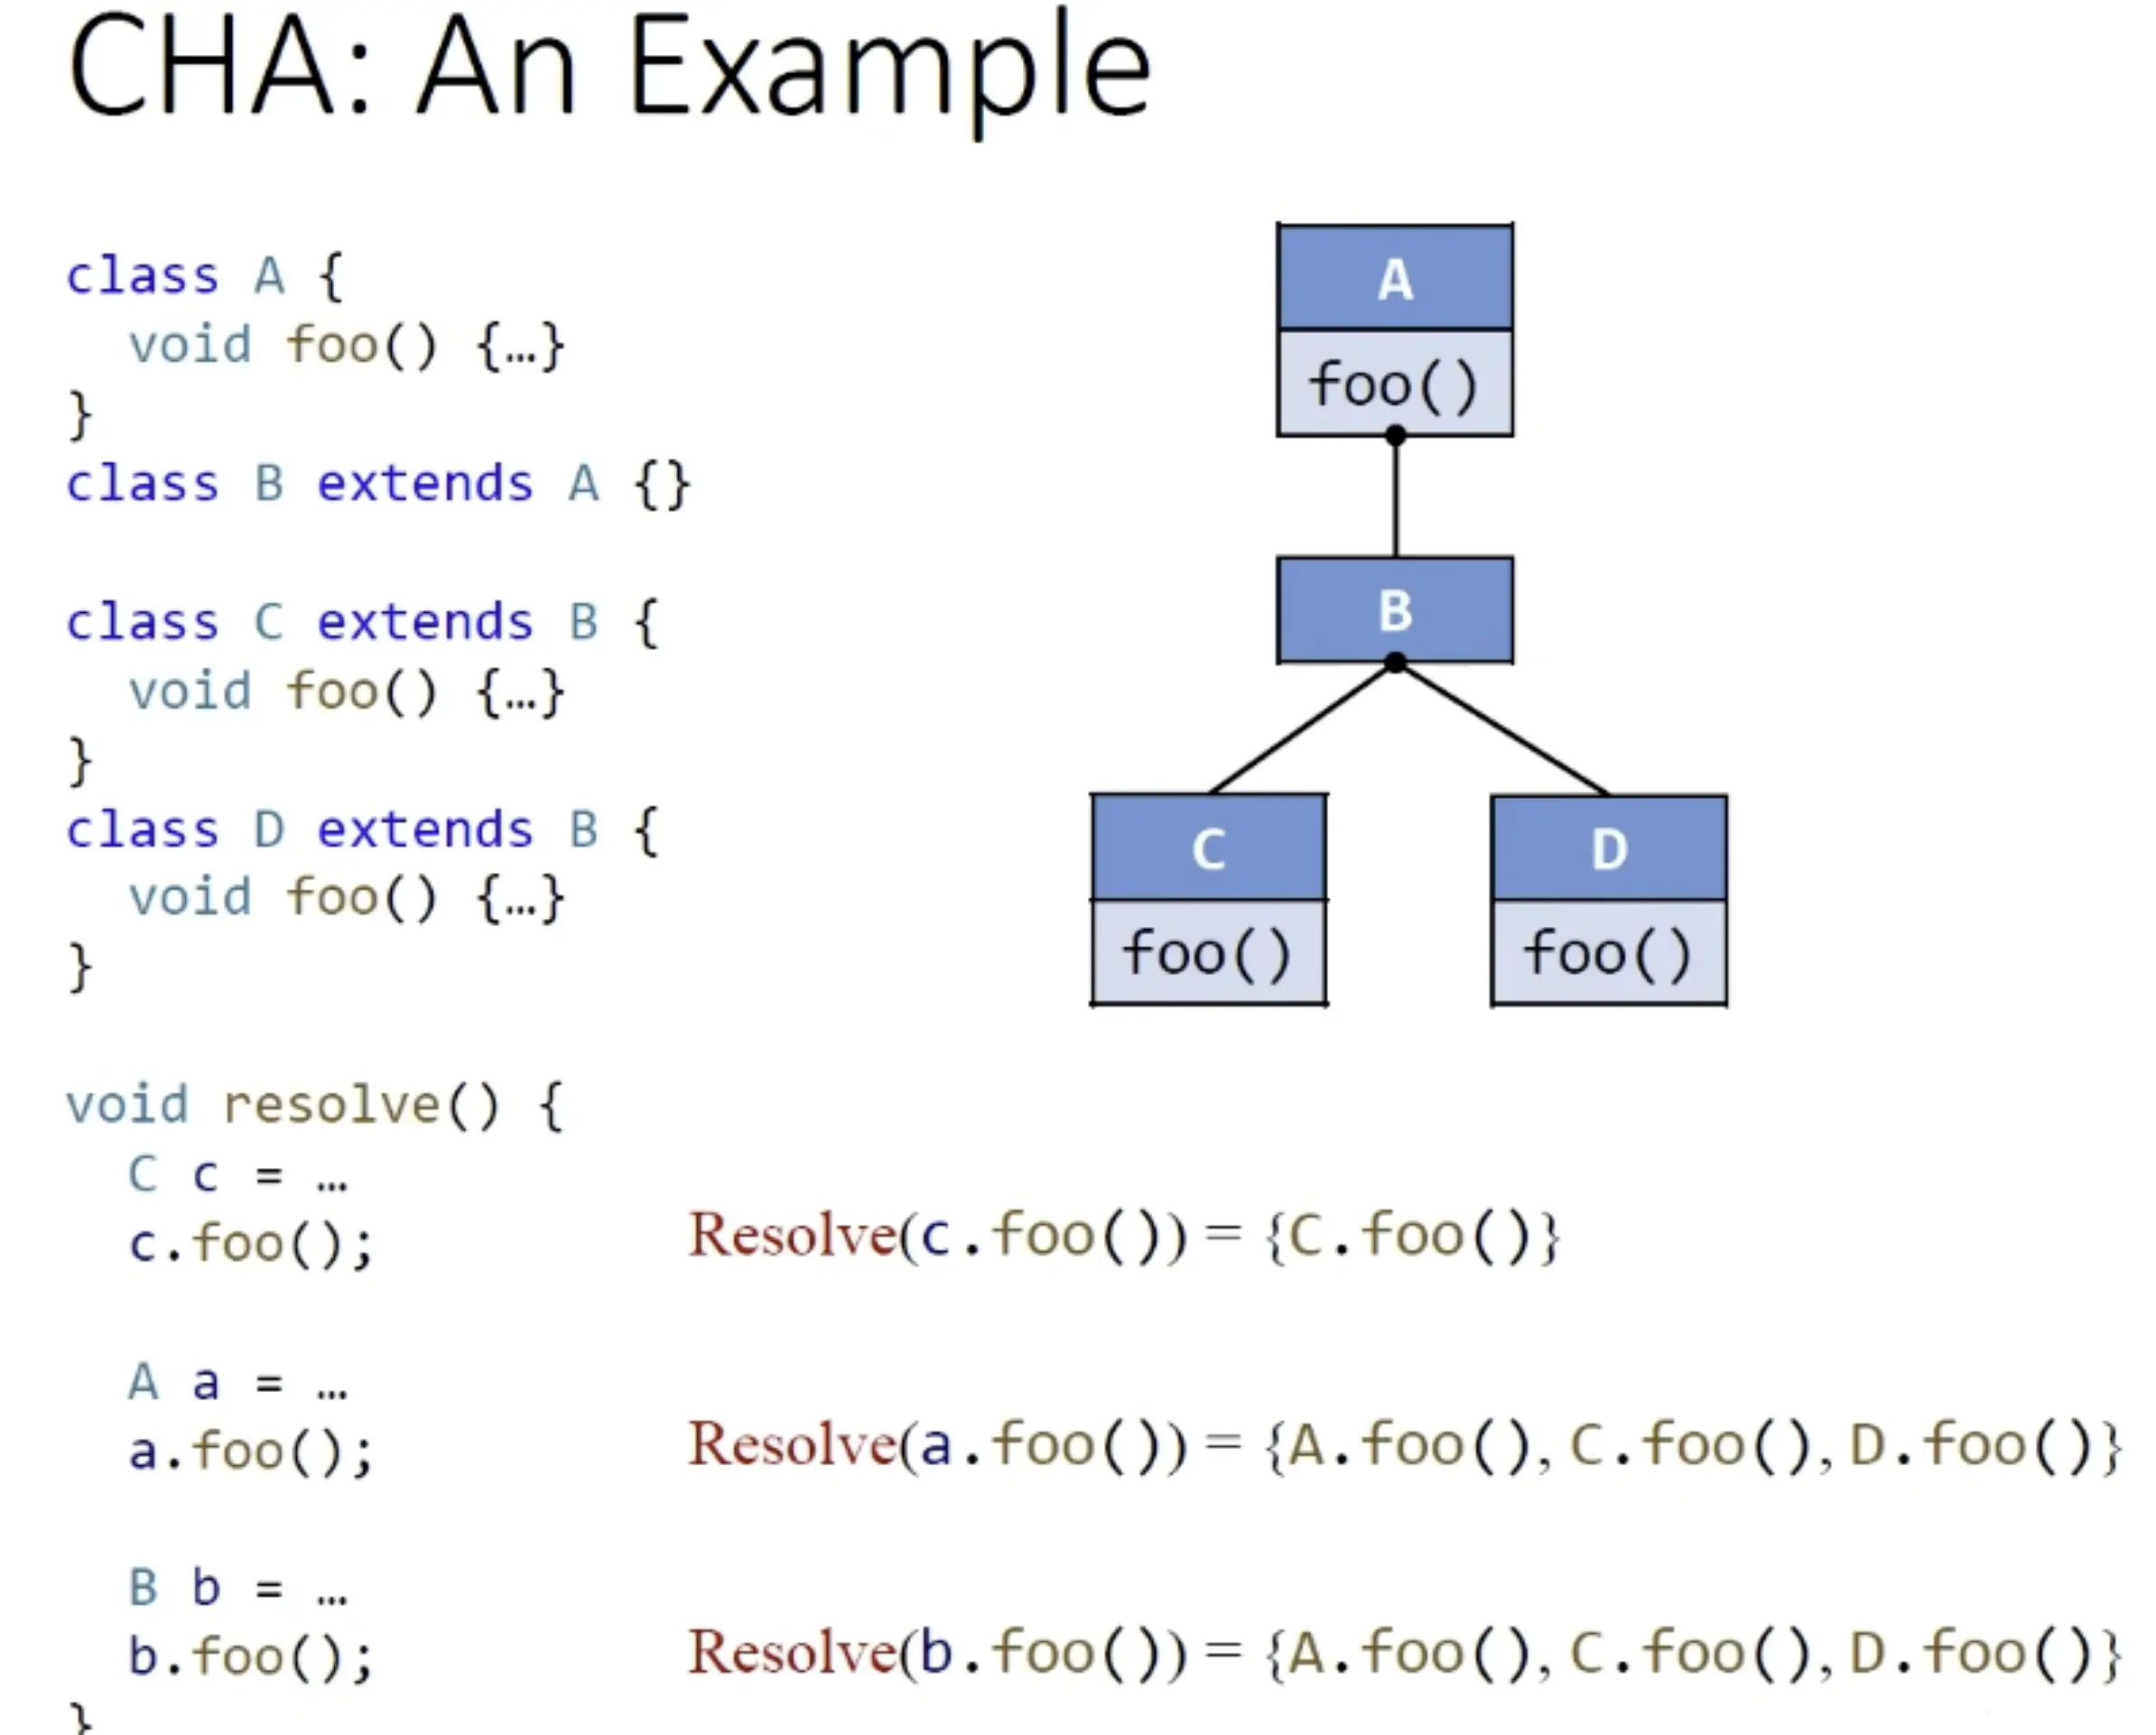
上边是3个运用CHA查找virtual call目标方法的例子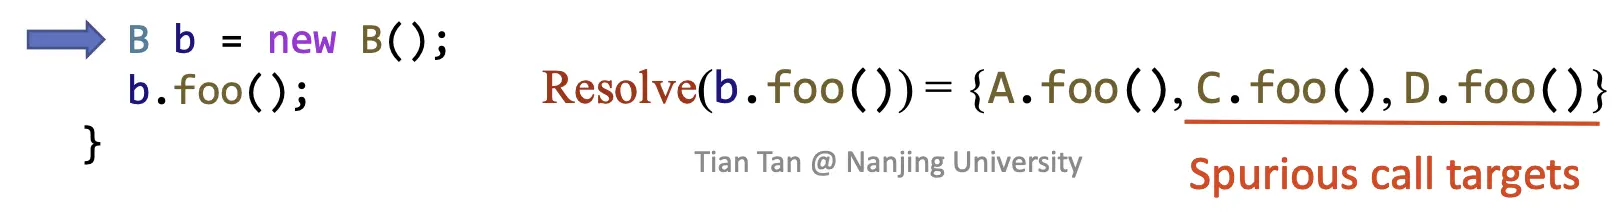
但值得注意的是,即使我们吧b实例化,CHA仍然会找到A.foo(),C.foo(),D.foo()
这是因为,CHA仅仅根据call site的receiver变量类型来查找,这就暴露了CHA的问题,会找到程序实际运行时不会调用的目标方法
所以在前面,我们说CHA是速度最快,精度最低的算法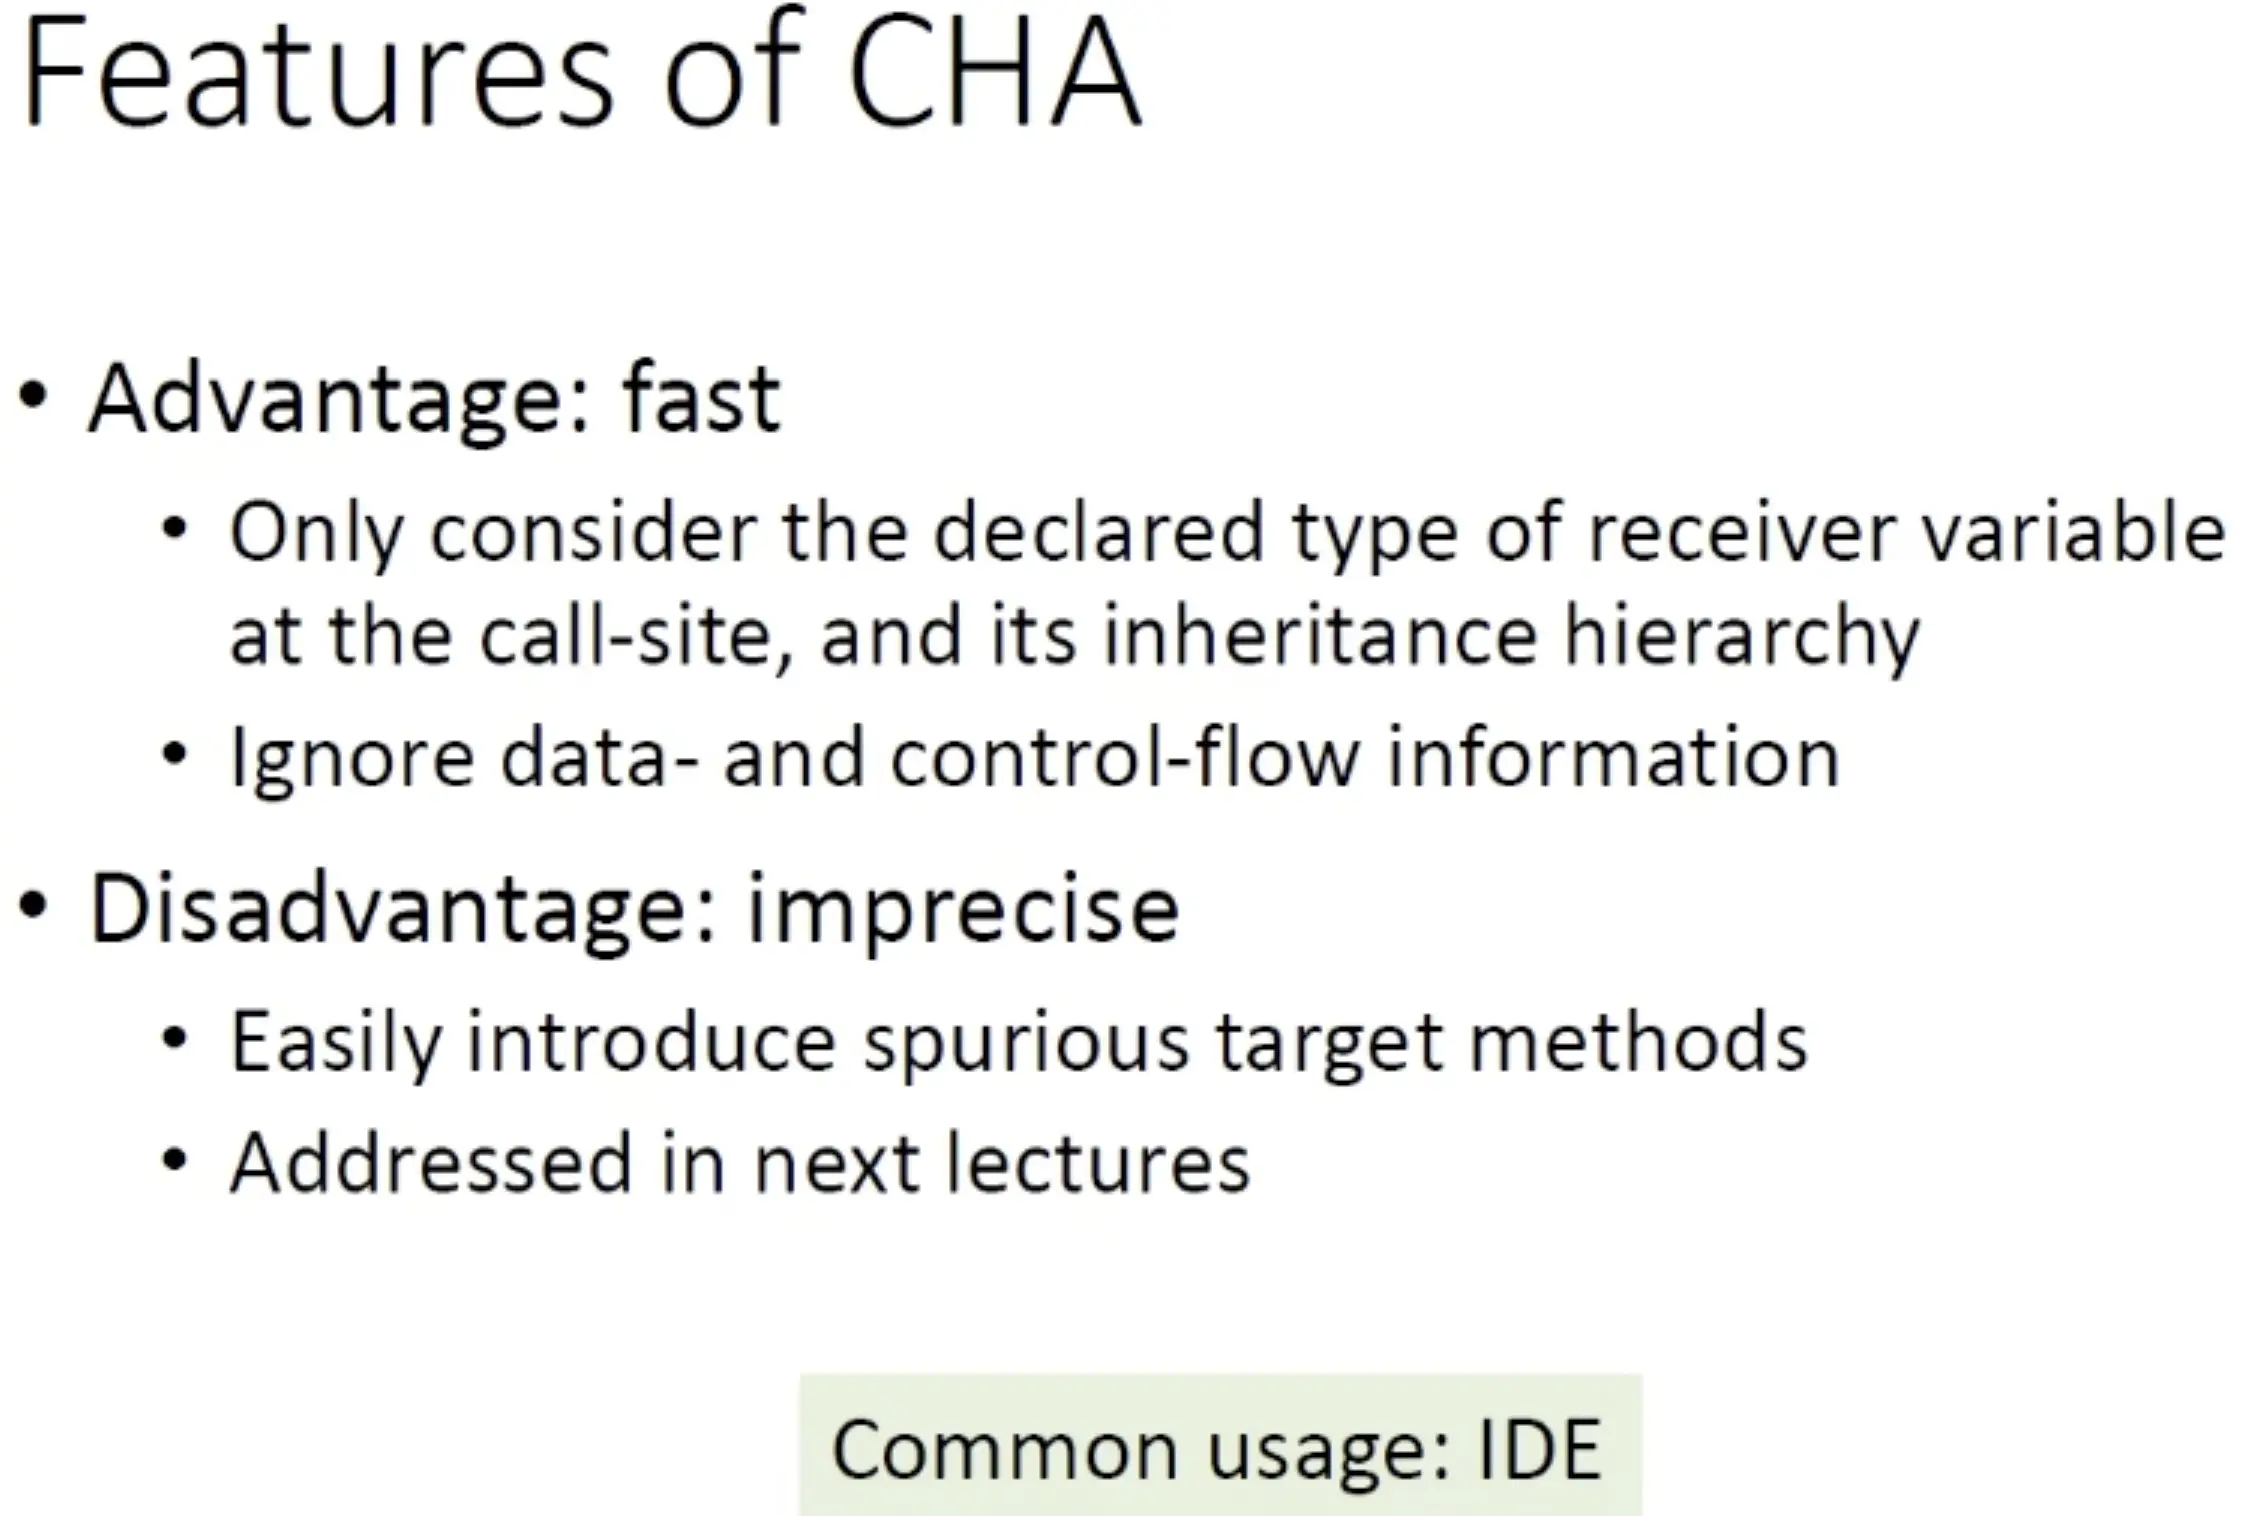
而这种特性正好特别适合在IDE这种场景使用
Call Graph Construction
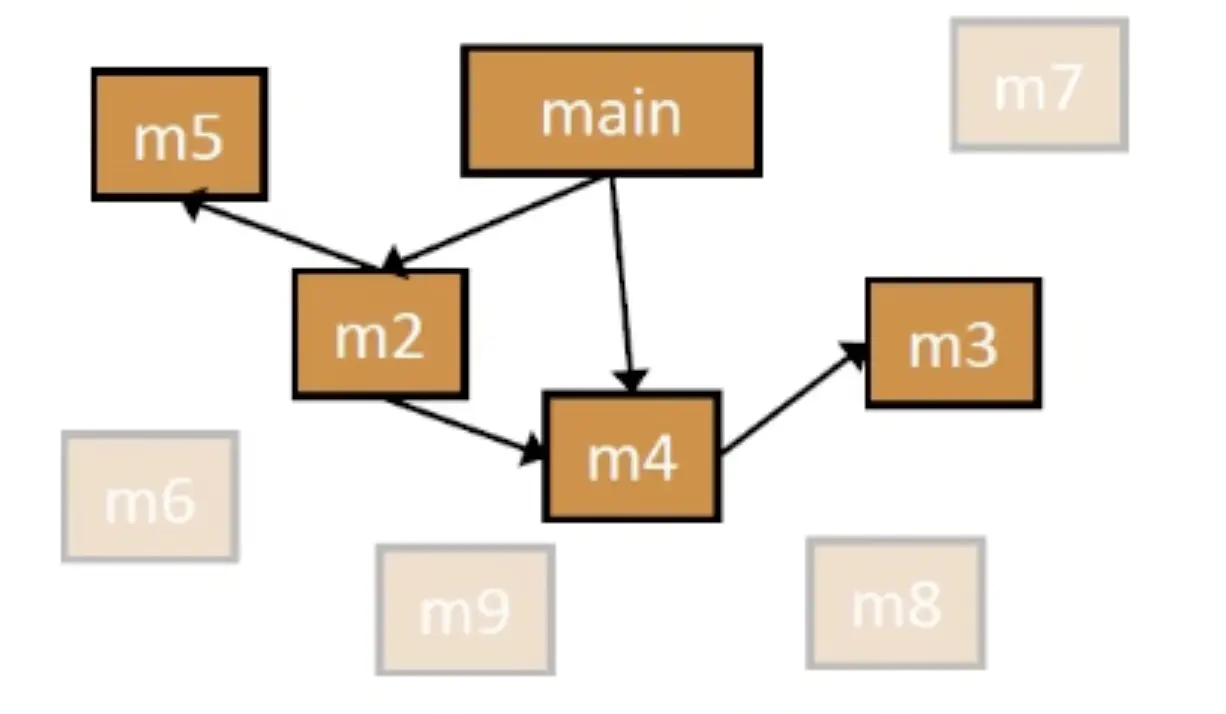
通过CHA构建整个程序的调用图
• 从入口方法开始(重点关注main方法)
• 对于每个可达的方法m,通过CHA解析m中的每个调用点cs的目标方法(Resolve(cs)) • 重复此过程直到不再发现新方法
具体的算法可以表示为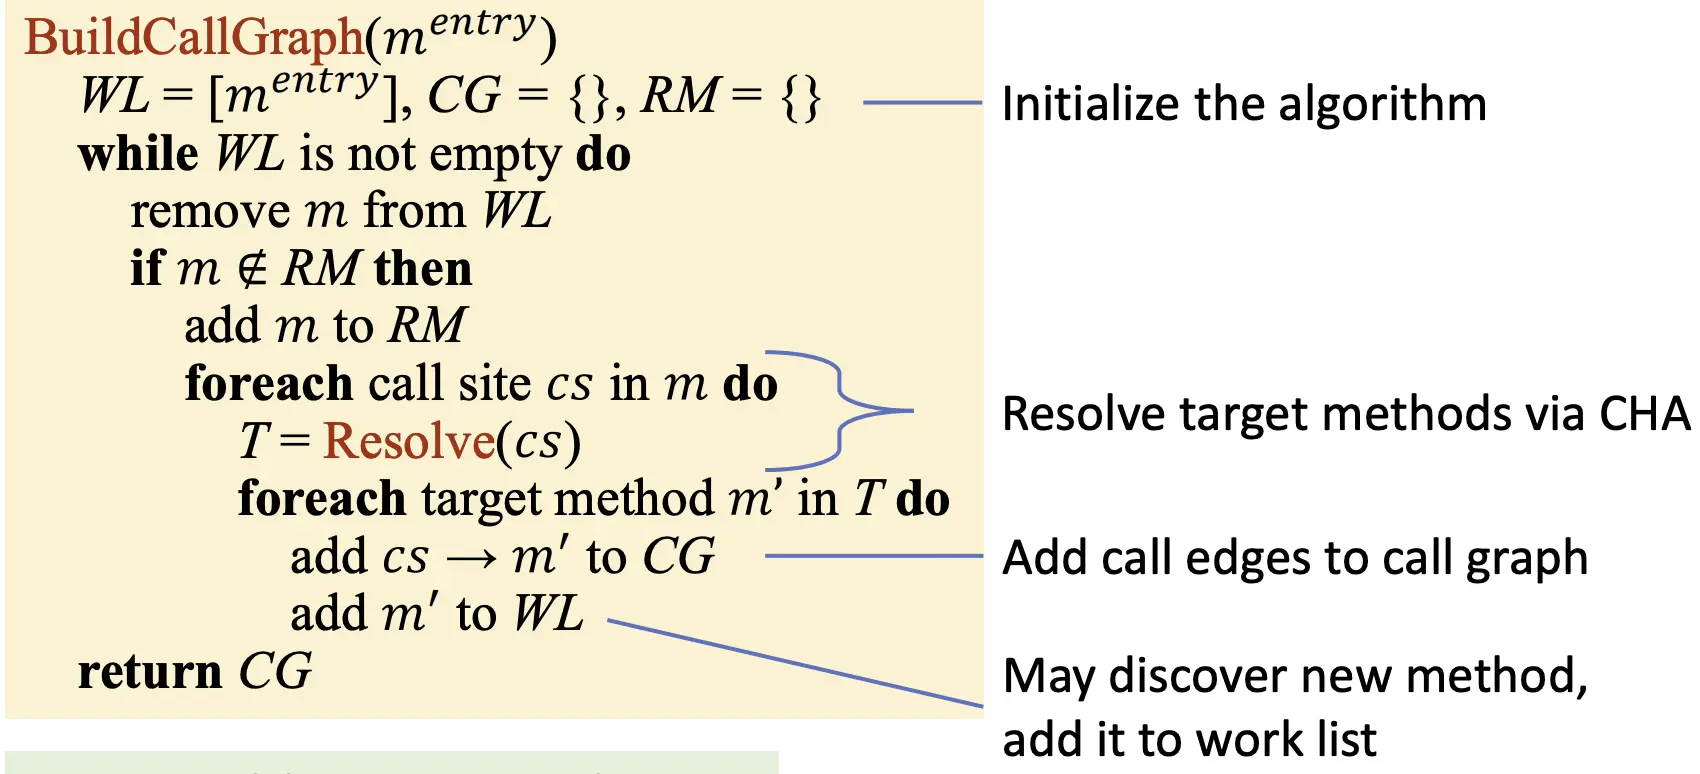
WL – Work list, containing the methods to be processed 存的就是需要被处理的方法,初始化为入口方法
CG – Call graph, a set of call edges 这个集合存的是调用边
RM – A set of reachable methods 可达方法的集合
这里简单解释一下,首先初始化WL为程序入口,CG,RM都为空,意为程序还未构建call graph,也没有方法被标记为可达方法,然后当WL不为空时进入循环,首先将当前方法从WL删除(先删除再处理,但是这样仍然可能重复处理方法,所以才要再维护一个RM集合),然后当m没有在可达方法RM中,那么将m加入,然后对m中每个cs(call site)进行Resolve求目标调用方法,将结果存储在T(target),将cs到T中每个m‘(目标方法)的调用边存入CG中,然后将m‘加入WL
接下来用一个例子演示怎么靠CHA一步步构建call graph
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20 class A {
static void main() {
A.foo();
}
static void foo() {
A a = new A();
a.bar();
}
void bar() {
C c = new C();
c.bar();
}
class B extends A {
void bar() {} }
class C extends A {
void bar() {
if (...) A.foo();
}
void m() {}
}
- WL[A.main]
Resolve(A.foo()) = {A.bar()} - WL[A.bar()]
Resolve(a.bar()) = {A.bar(), B.bar(), C.bar()} - WL[A.bar(), B.bar(), C.bar()]
Resolve(c.bar()) = {C.bar} - WL[B.bar(), C.bar(), C.bar]
B.bar()为空 - WL[C.bar(), C.bar]
Resolve(A.foo()) = {A.foo()} - WL[C.bar(), A.foo()]
C.bar处理过 - WL[A.foo()]
A.foo()处理过 - WL[]
结束
(学习中…)