这节课理论知识非常多,刚好8月底事情比较多,看课程看得断断续续的,连贯不起来导致也没有特别消化完所有内容,好在对于基础的应用来说暂时不会出现困难(比较多的是理论上的证明,直接运用结论也可)
复习
先复习一下May&Forward Analysis的迭代算法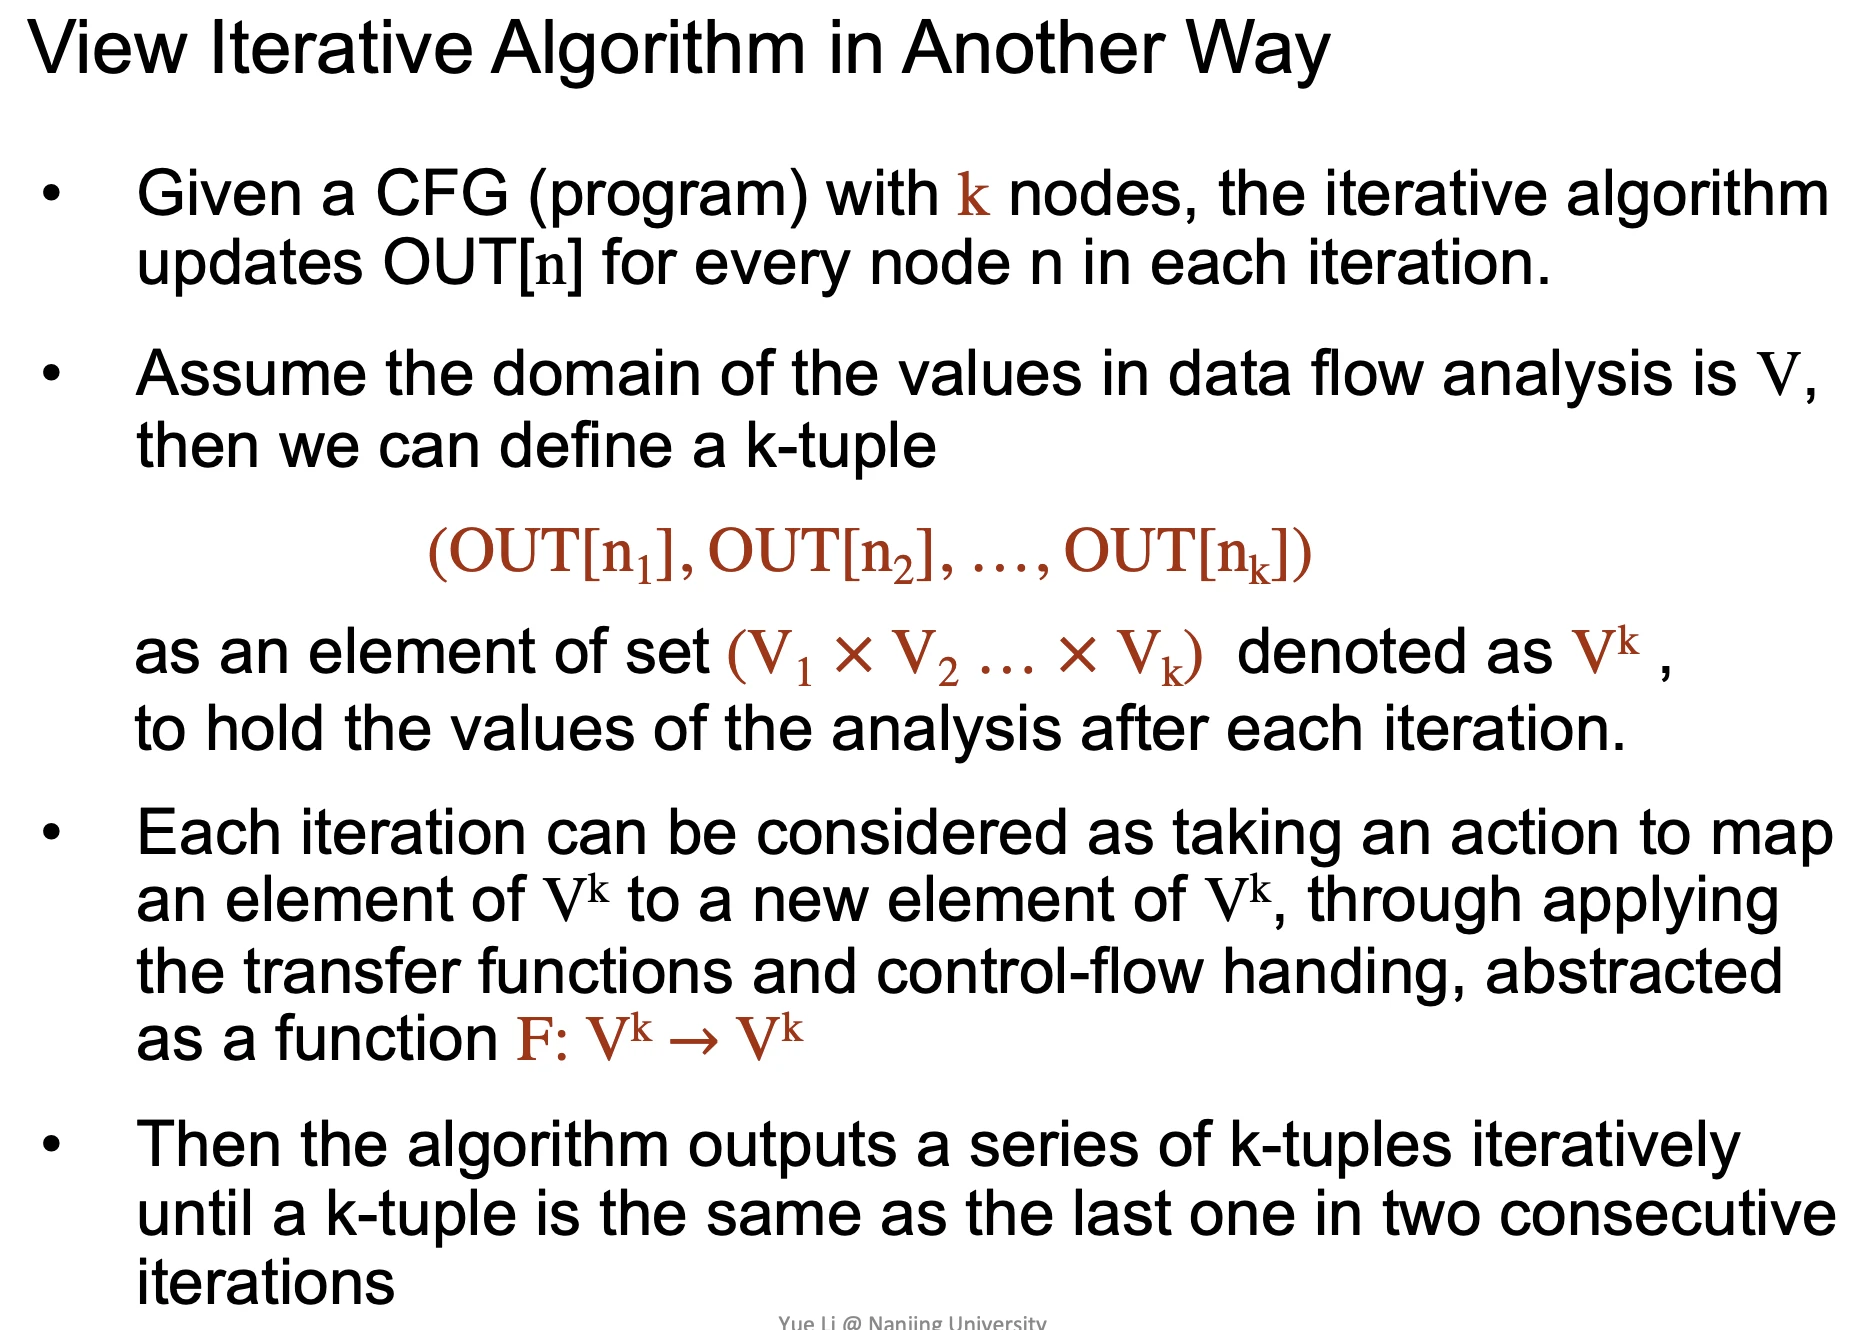
如果以另一个角度来看我们的迭代算法
给定一个有k个节点的CFG(程序),迭代算法在每次迭代中更新每个节点n的OUT[n]。
假设数据流分析中值的域为V,那么我们可以定义一个k元组
(OUT[n1], OUT[n2], ..., OUT[nk])
作为集合(V1 x V2 … x Vk)的元素,记为Vk,以保存每次迭代后的分析值。
每次迭代可以看作是执行一个操作,将vk中的一个元素映射到Vk中的一个新元素,通过应用转移函数和控制流处理,抽象为一个函数F:Vk → Vk。
然后,算法迭代输出一系列k元组,直到连续两次迭代中的k元组相同。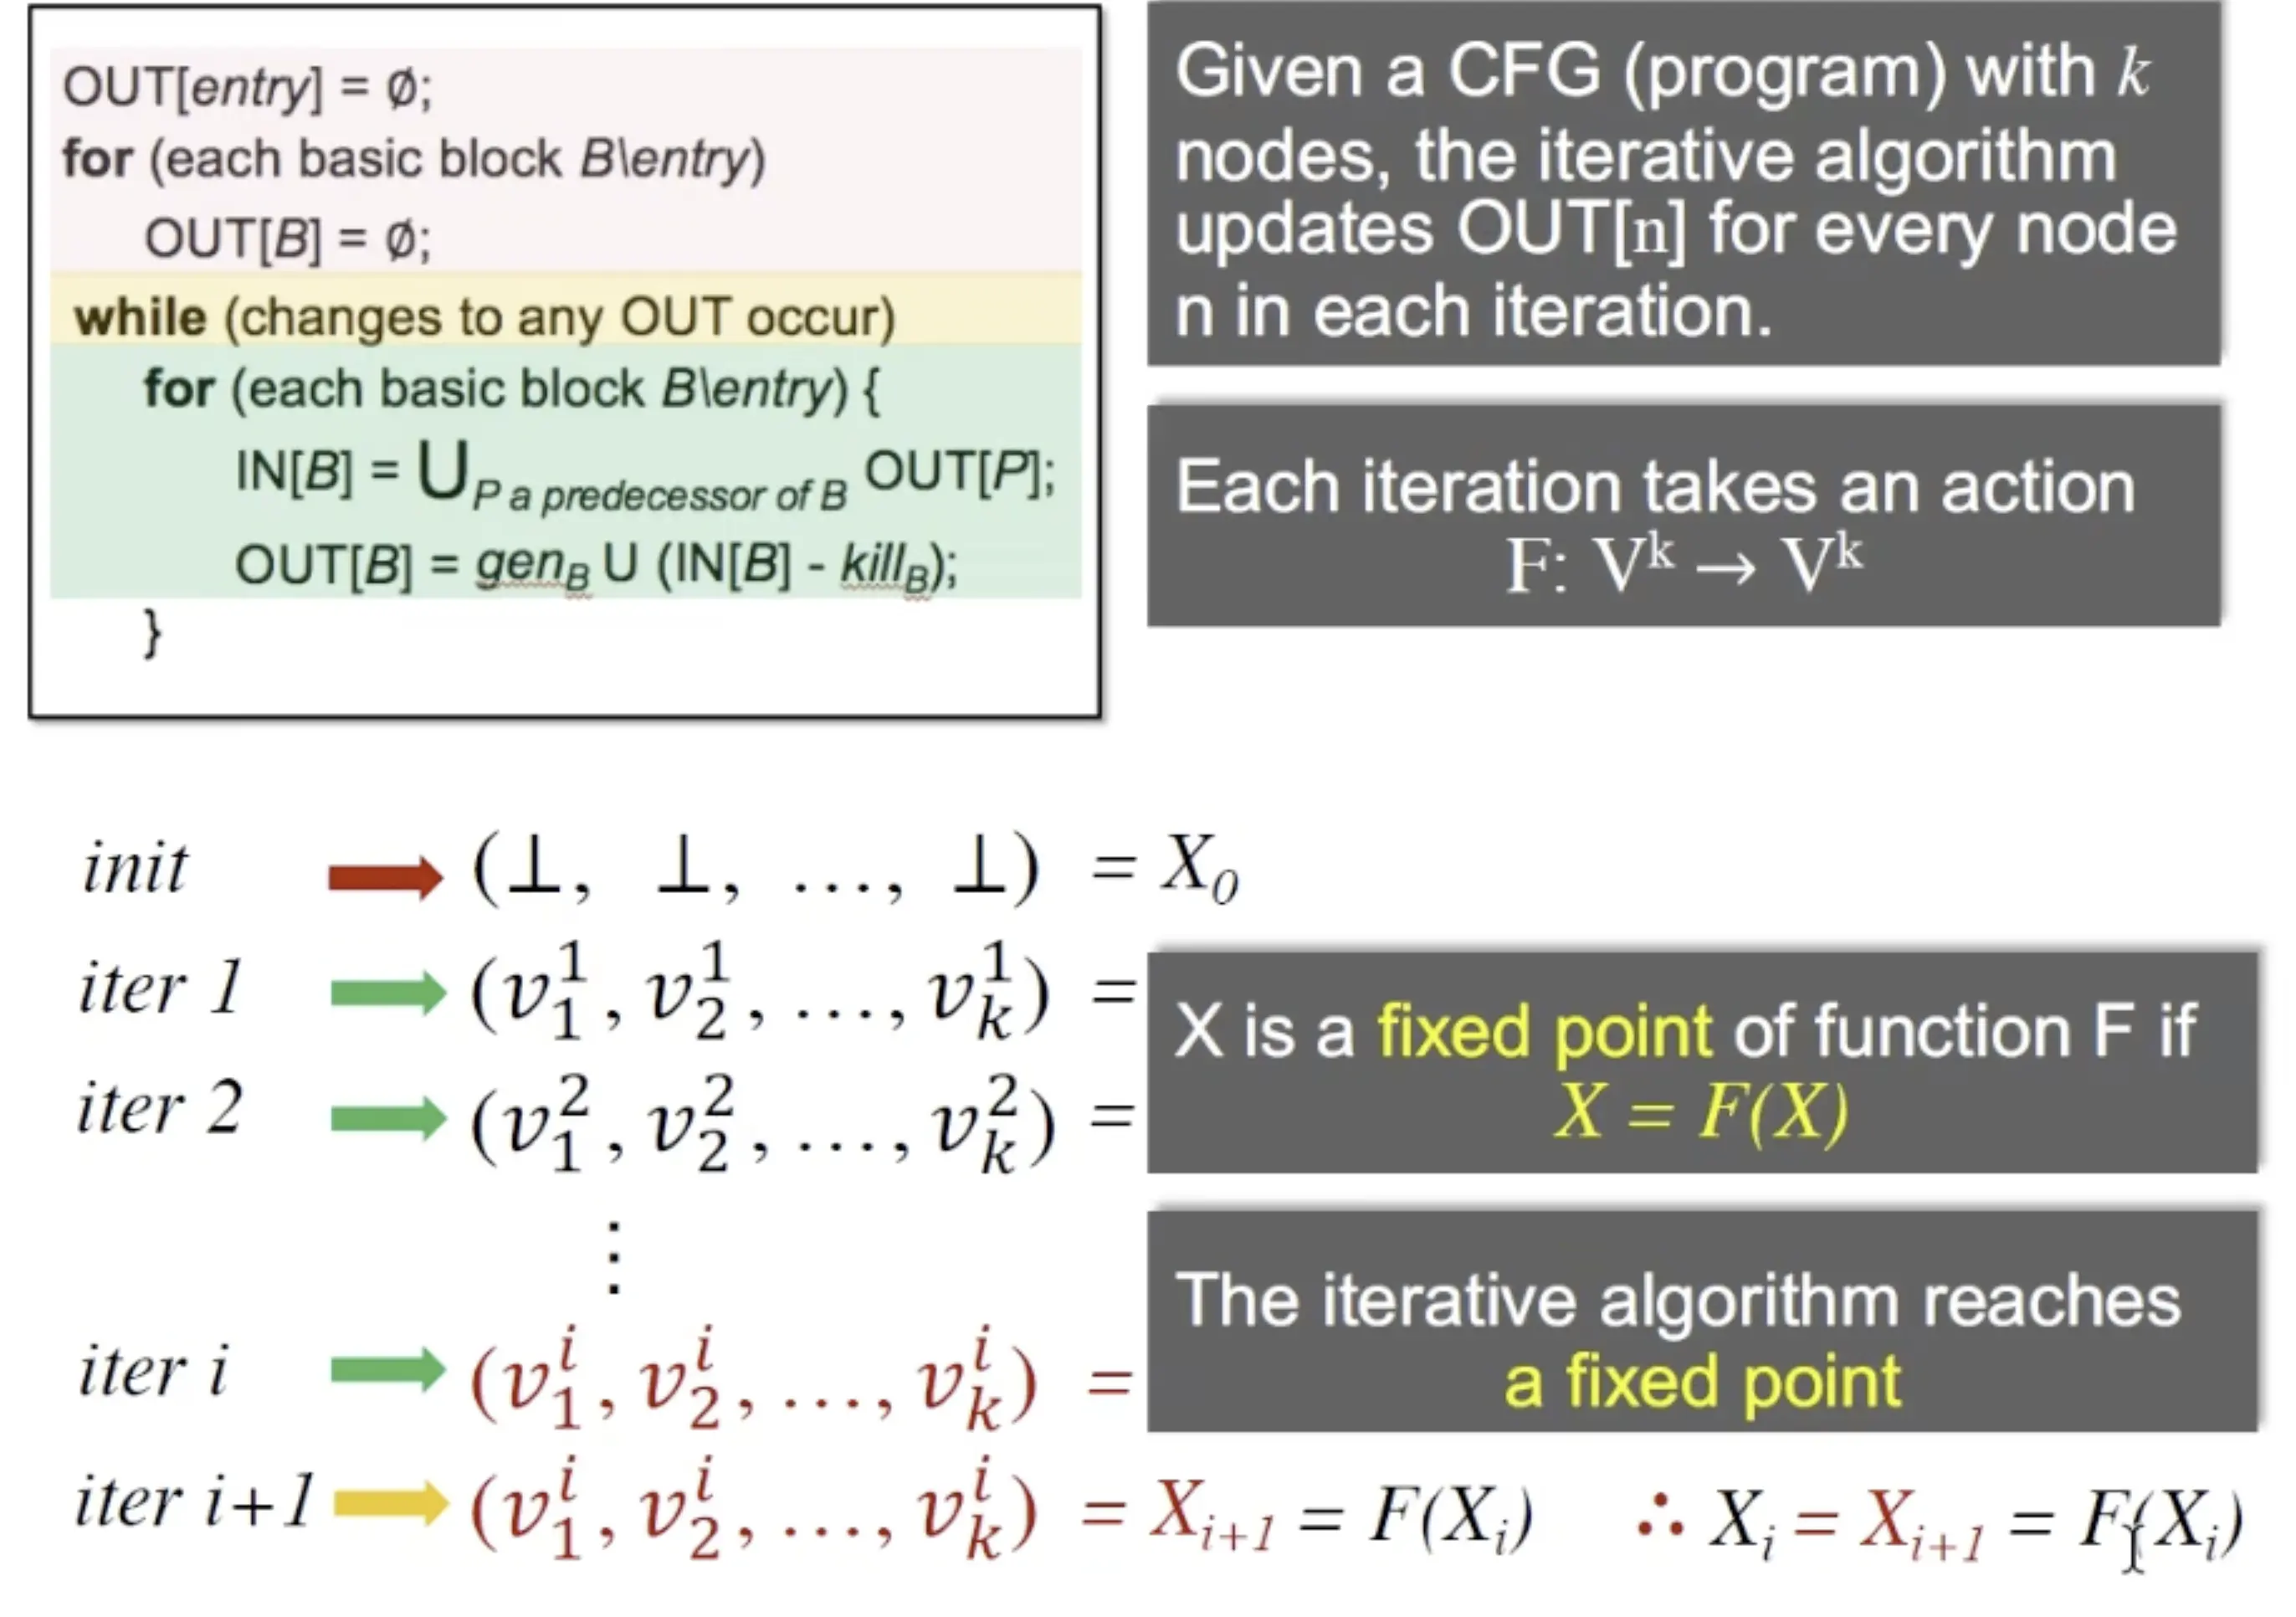
不动点的原理,当Xi = Xi+1 = F(X)时,到达数学定义上的不动点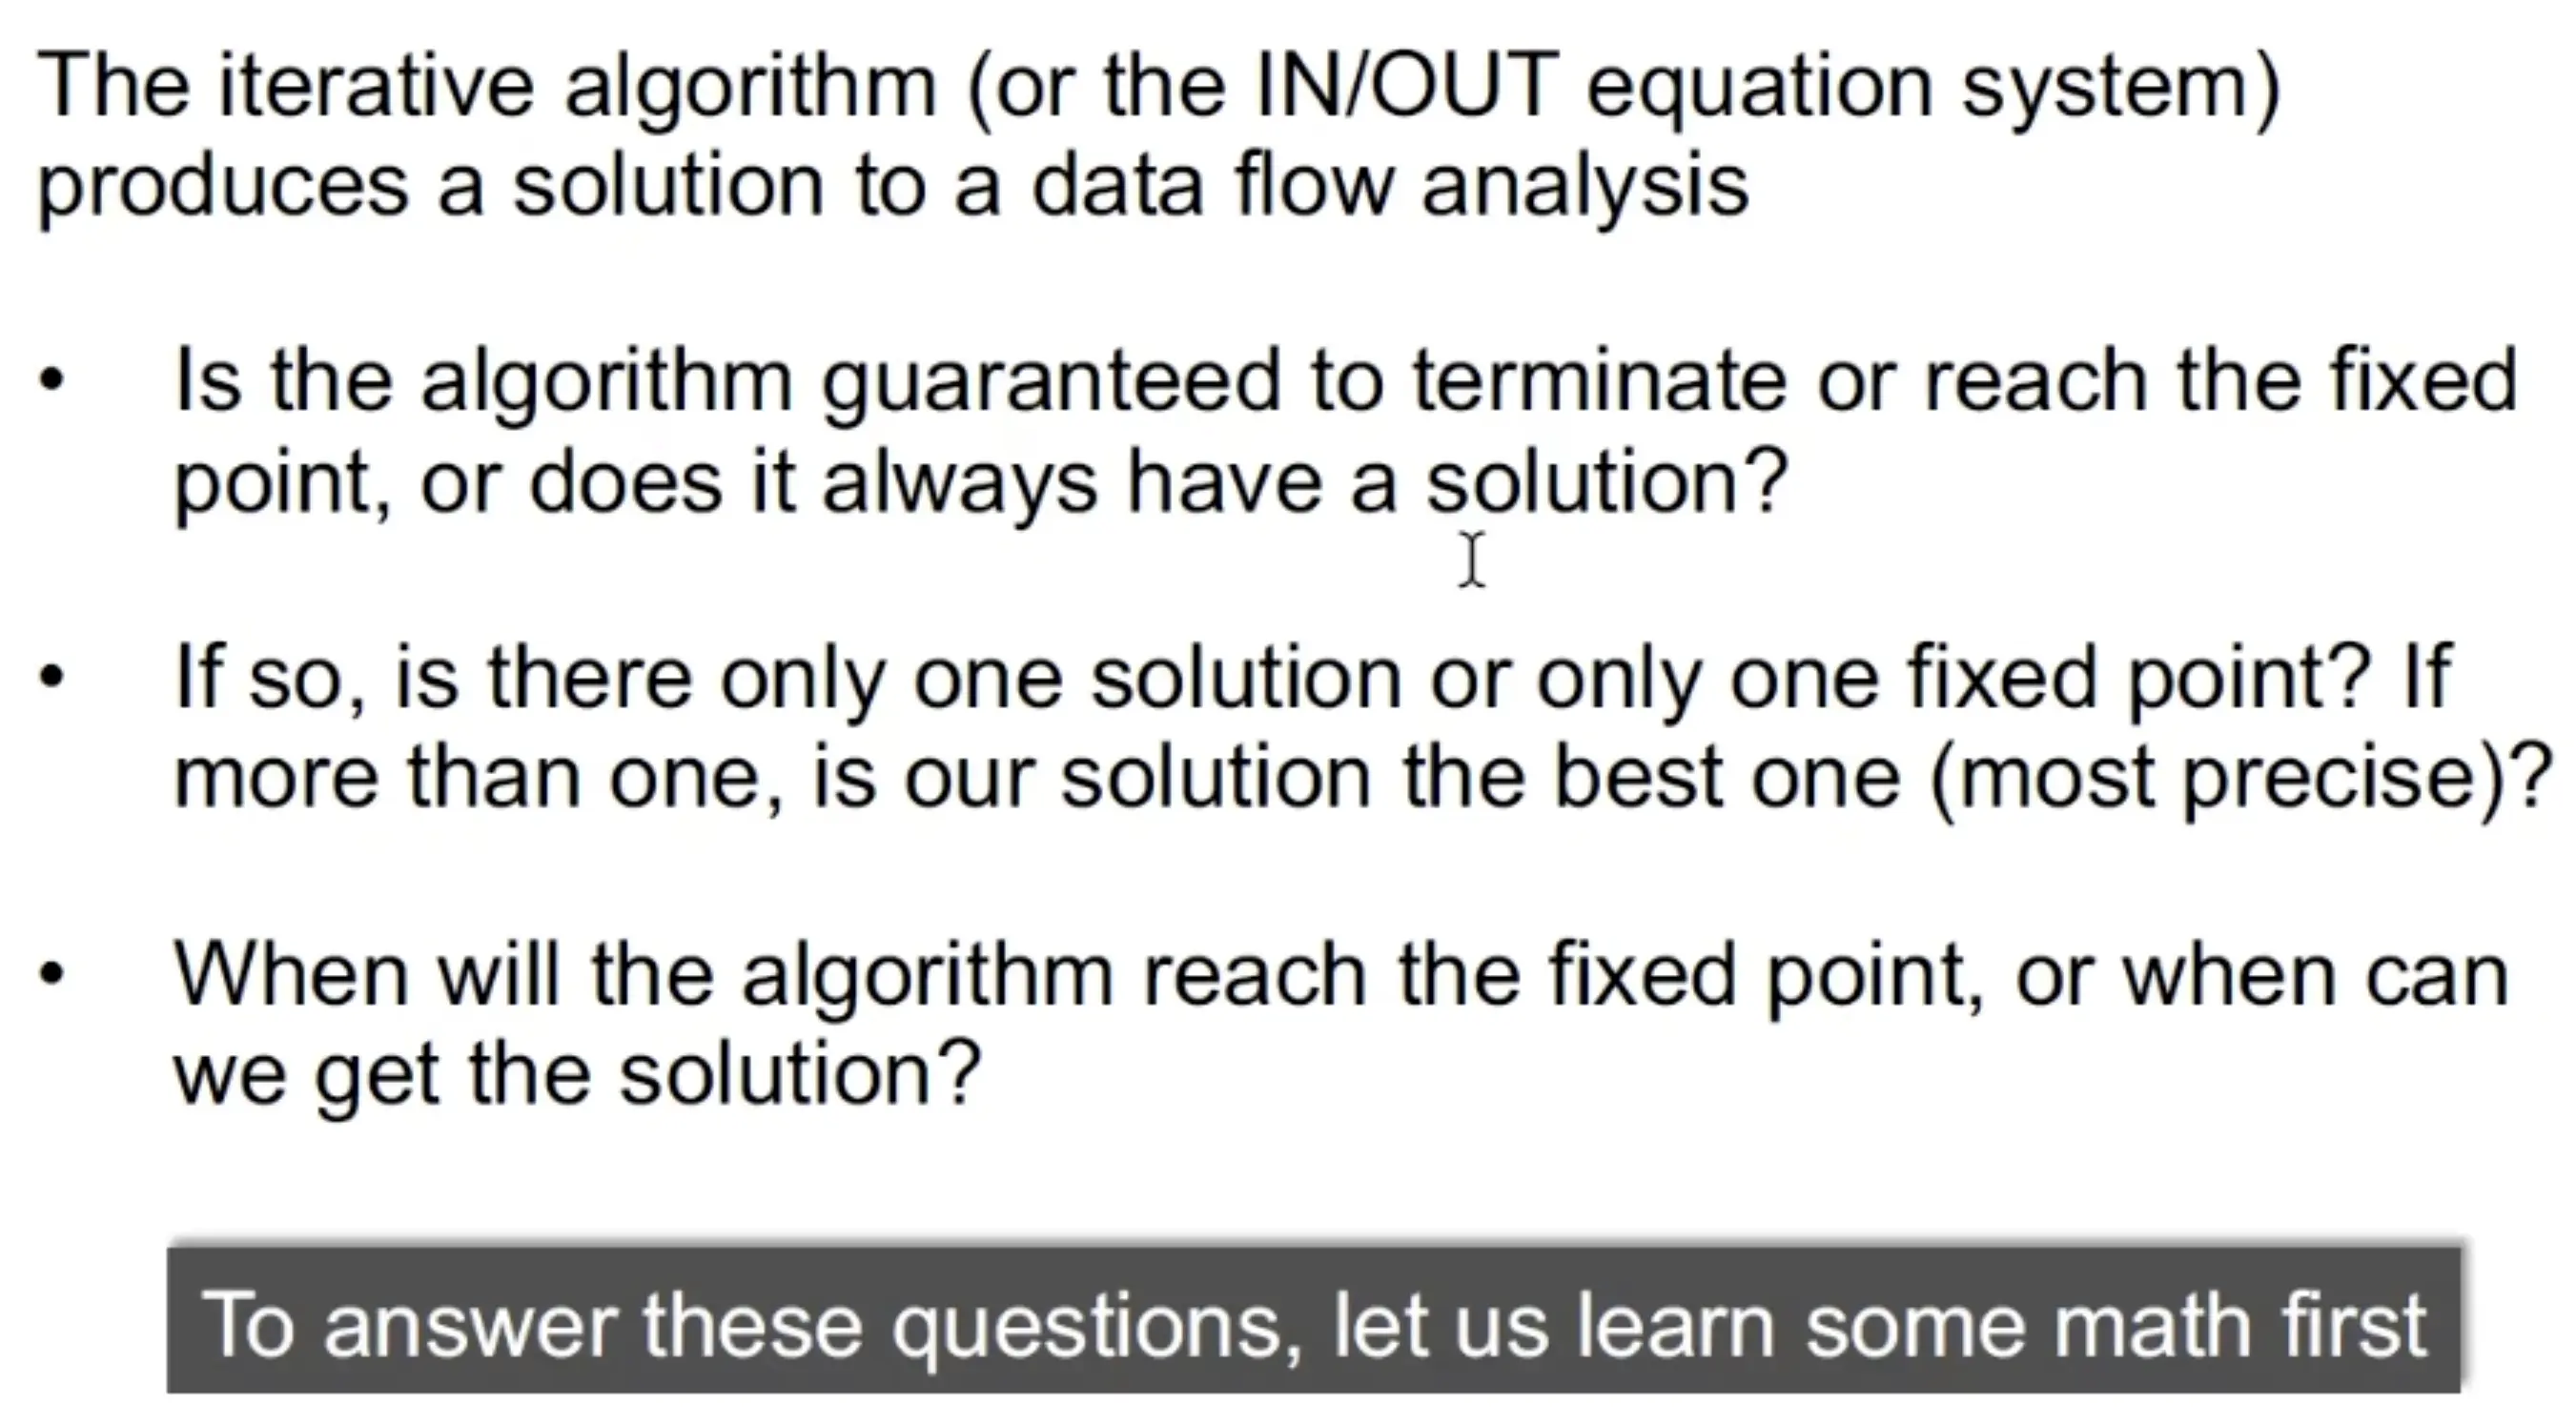
关于不动点,有几个基础的问题
该算法是否保证终止或达到定点,或者它总是有解?
如果是这样,是否只有一个解或只有一个定点?如果有多个,我们的解是否是最佳解(最精确的)?
算法何时达到定点,或者我们何时可以得到解?
关于这些问题在前面的教学中都暂时搁置了起来,由于主播没有把详细的理论证明过程都看懂消化,这里就不发表自己的理解了
并且省略关于lattice格和一些离散数学中学过的概念如最小上界和最大下界等等
总结
直接看我们在应用中需要也就是下面这张图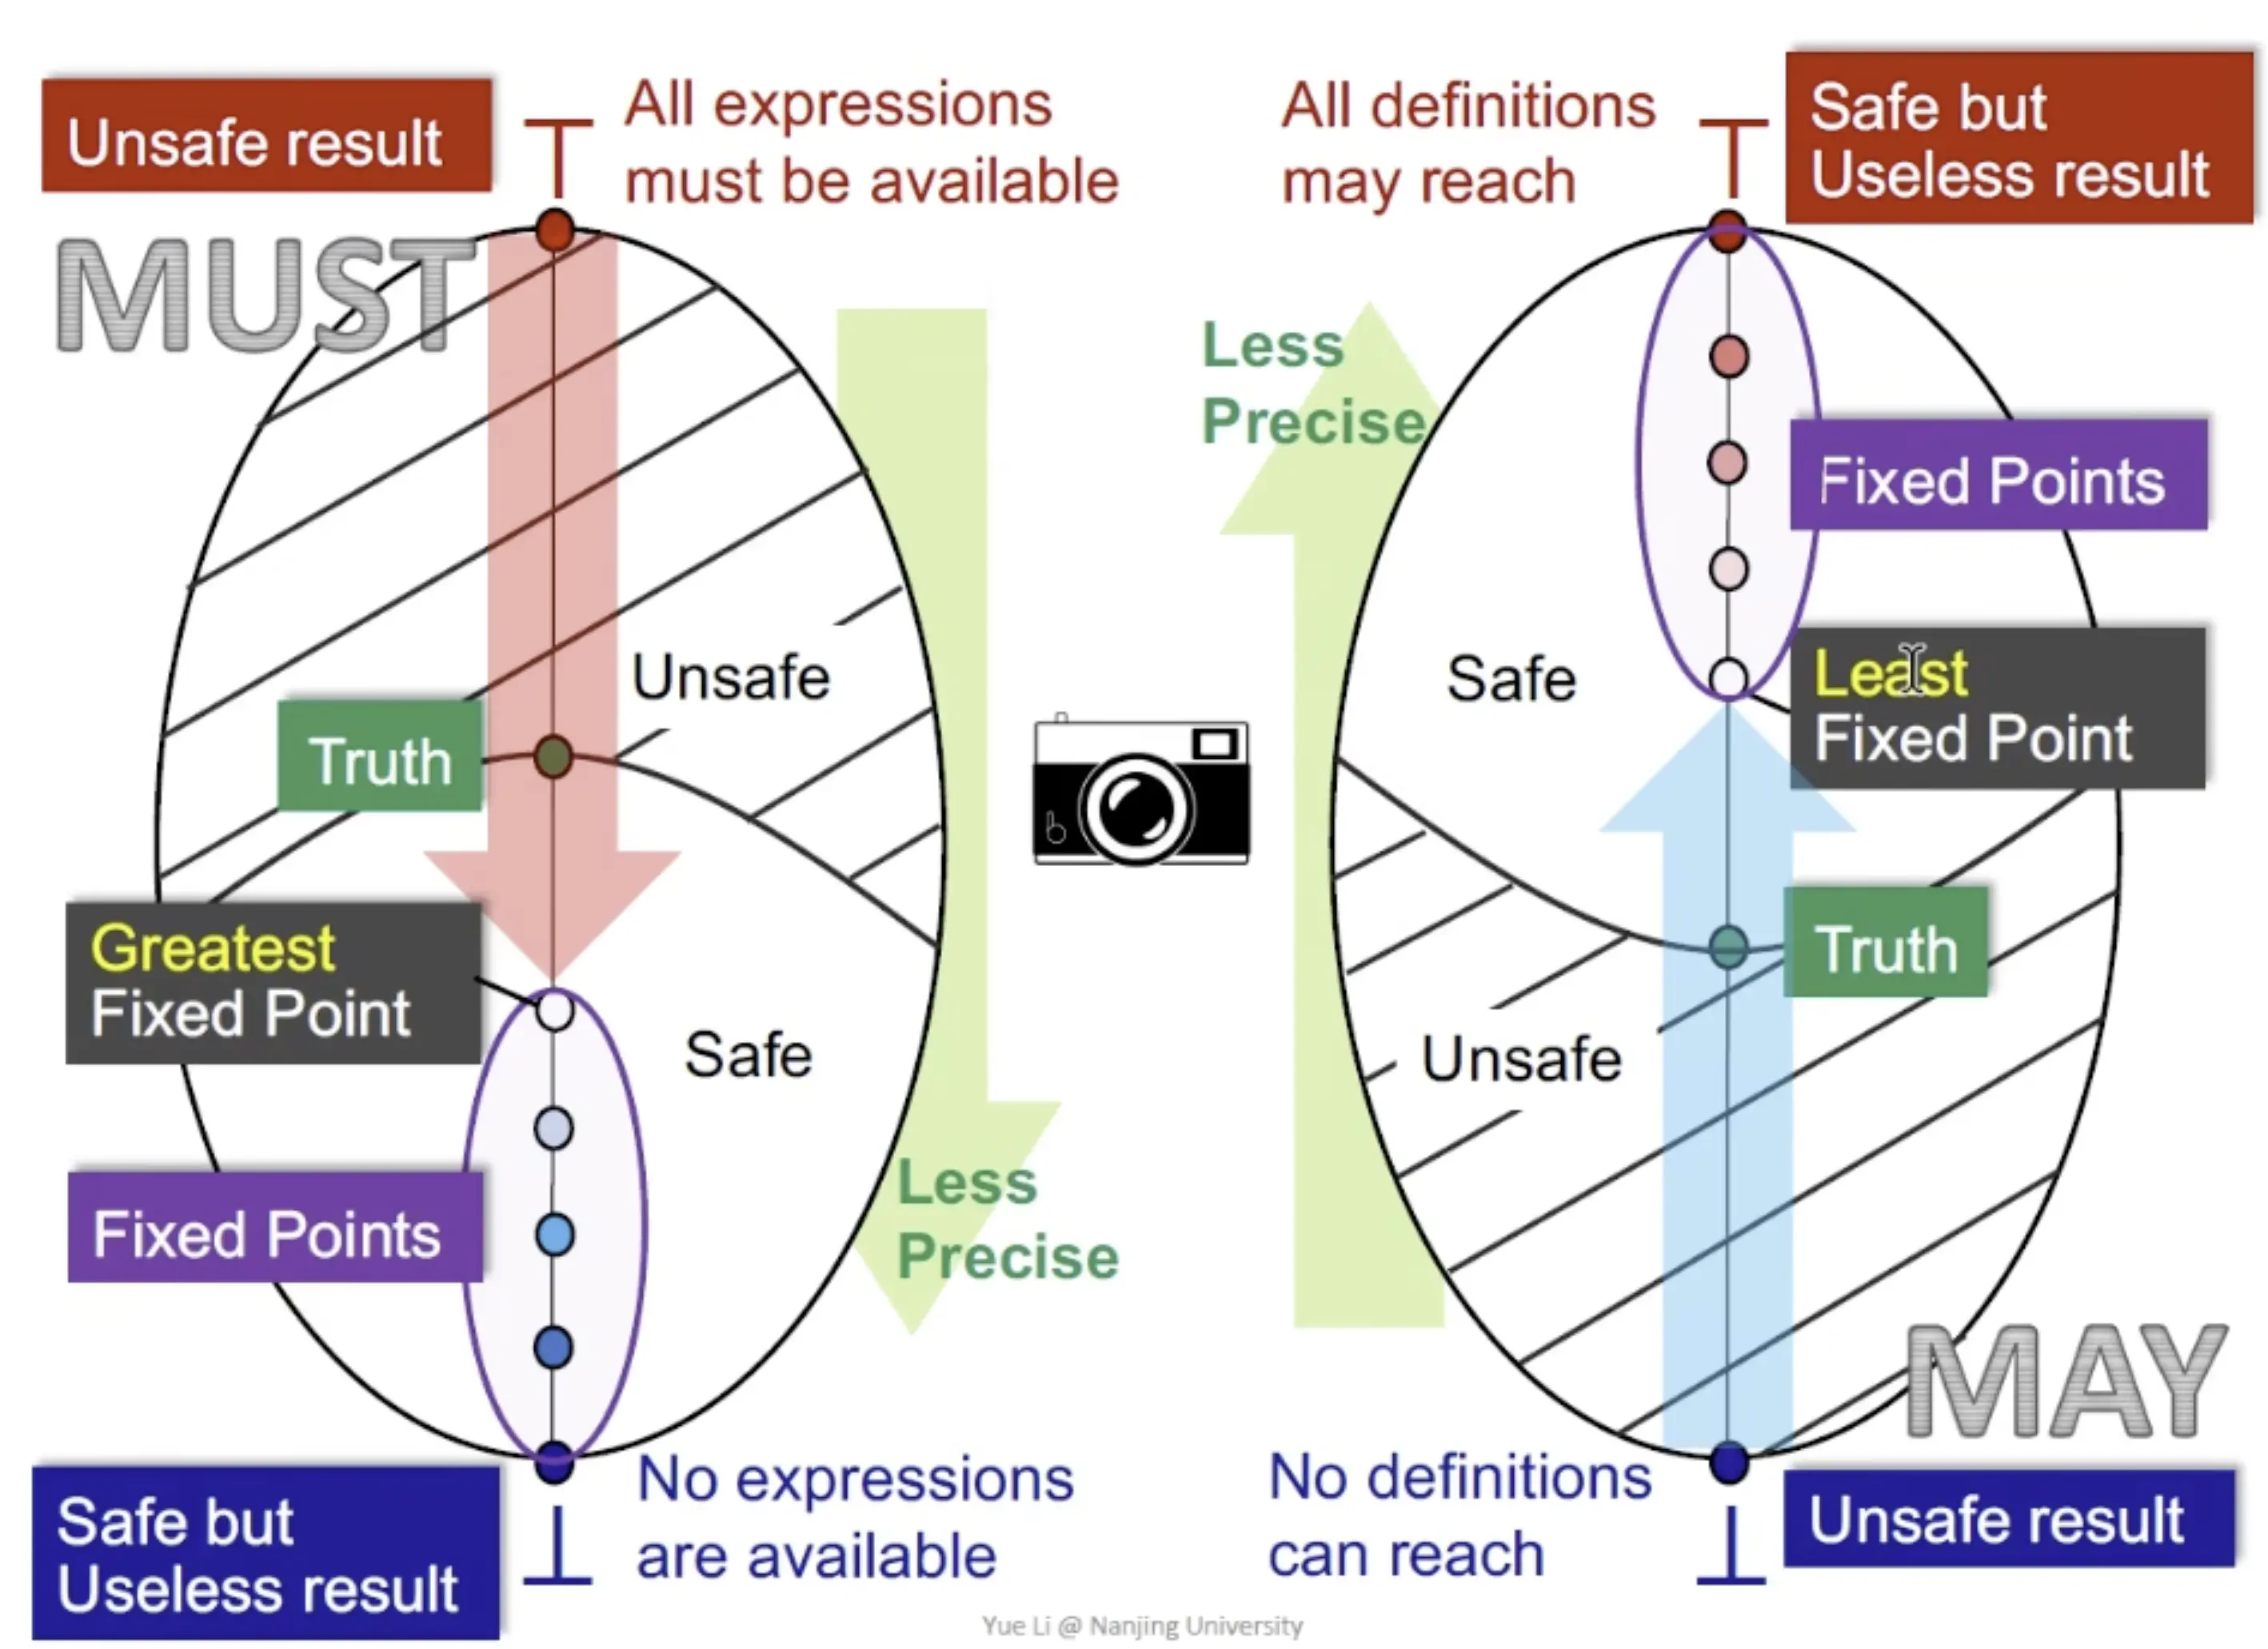
只需要知道,当算法是一个(从Top 到 Buttom的)Must Analysis时,需要不断的求不动点的最大下界也就是glb(greatest lower bound)
而当算法是(从Buttom 到 Top的)May Analysis时,需要求不动点的最小上界lub
当谈及precise精确度时,我们介绍另一种算法
MOP(Meet-Over-All-Paths Solution)
关注整条path路径上的transfer function
(之前是一个statement上的transfer function)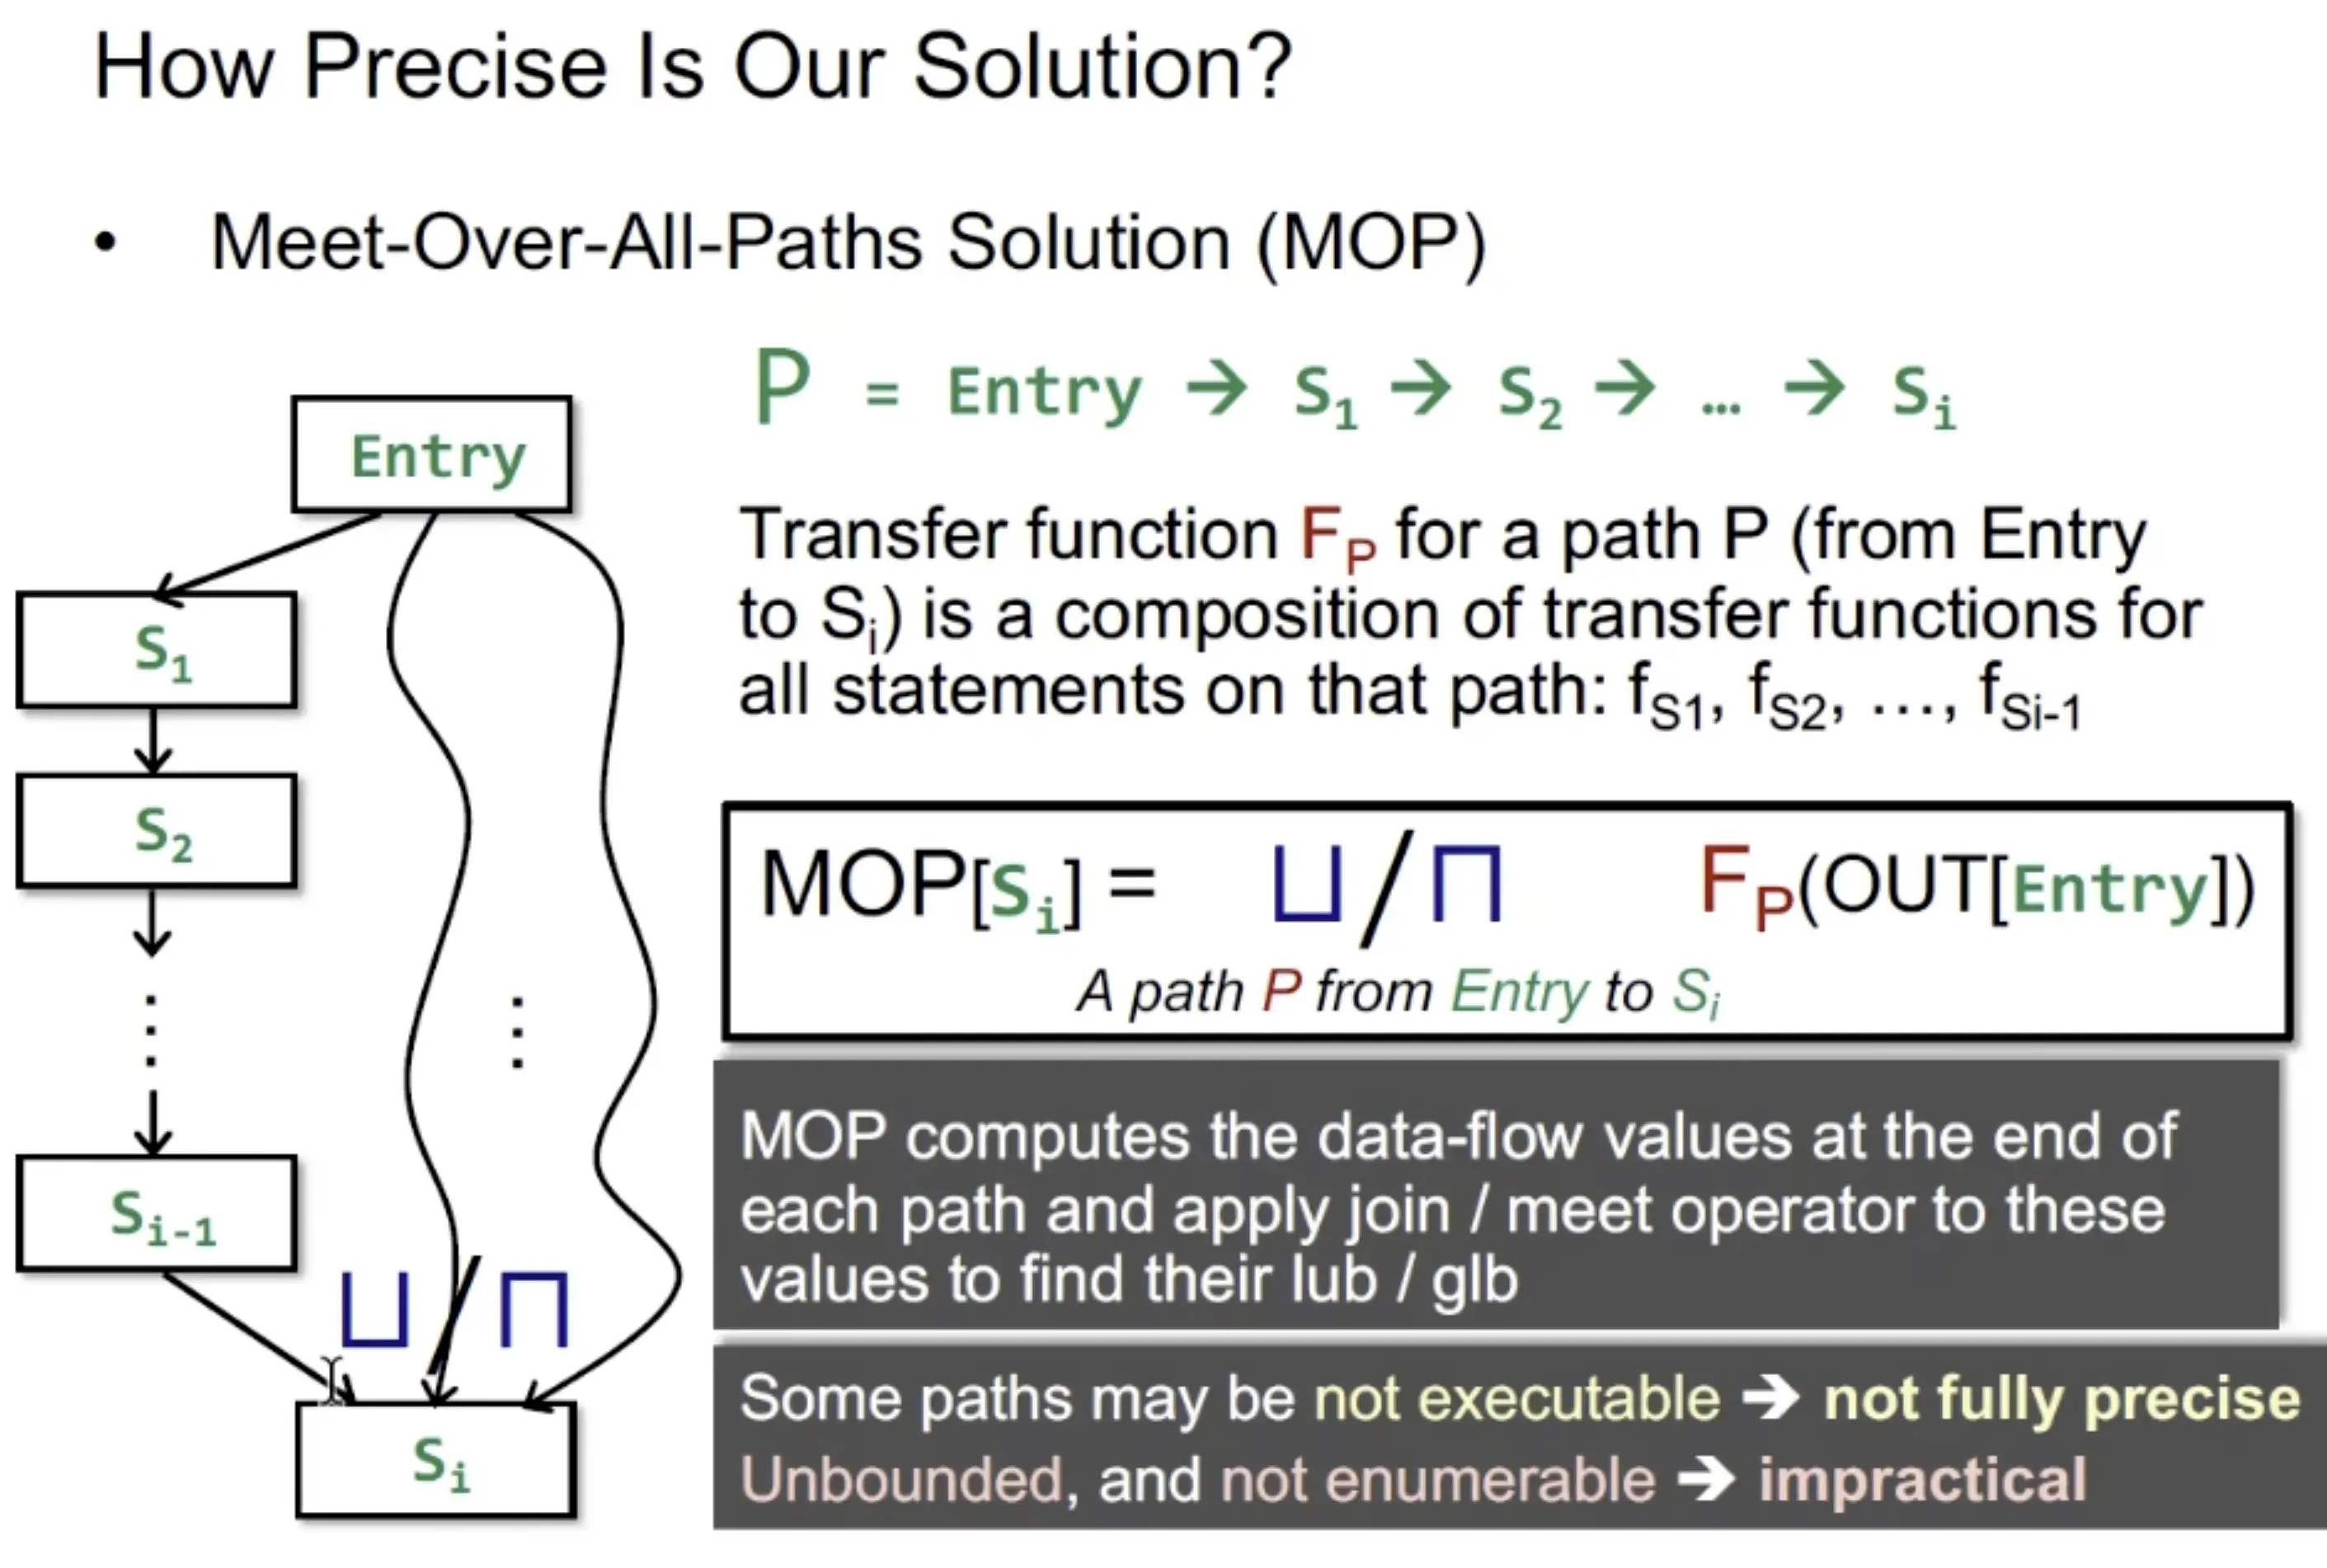
MOP 计算每条路径结束时的数据流值,并应用 join / meet 运算符对这些值进行处理,以找到它们的 lub(最小上界) / glb(最大下界)
而这些路径中可能某些路径不可执行(无论什么输入,都不可能执行这一branch),而在静态分析时,如果我们把一条不可执行的路径的结果也union起来,那么就产生了误报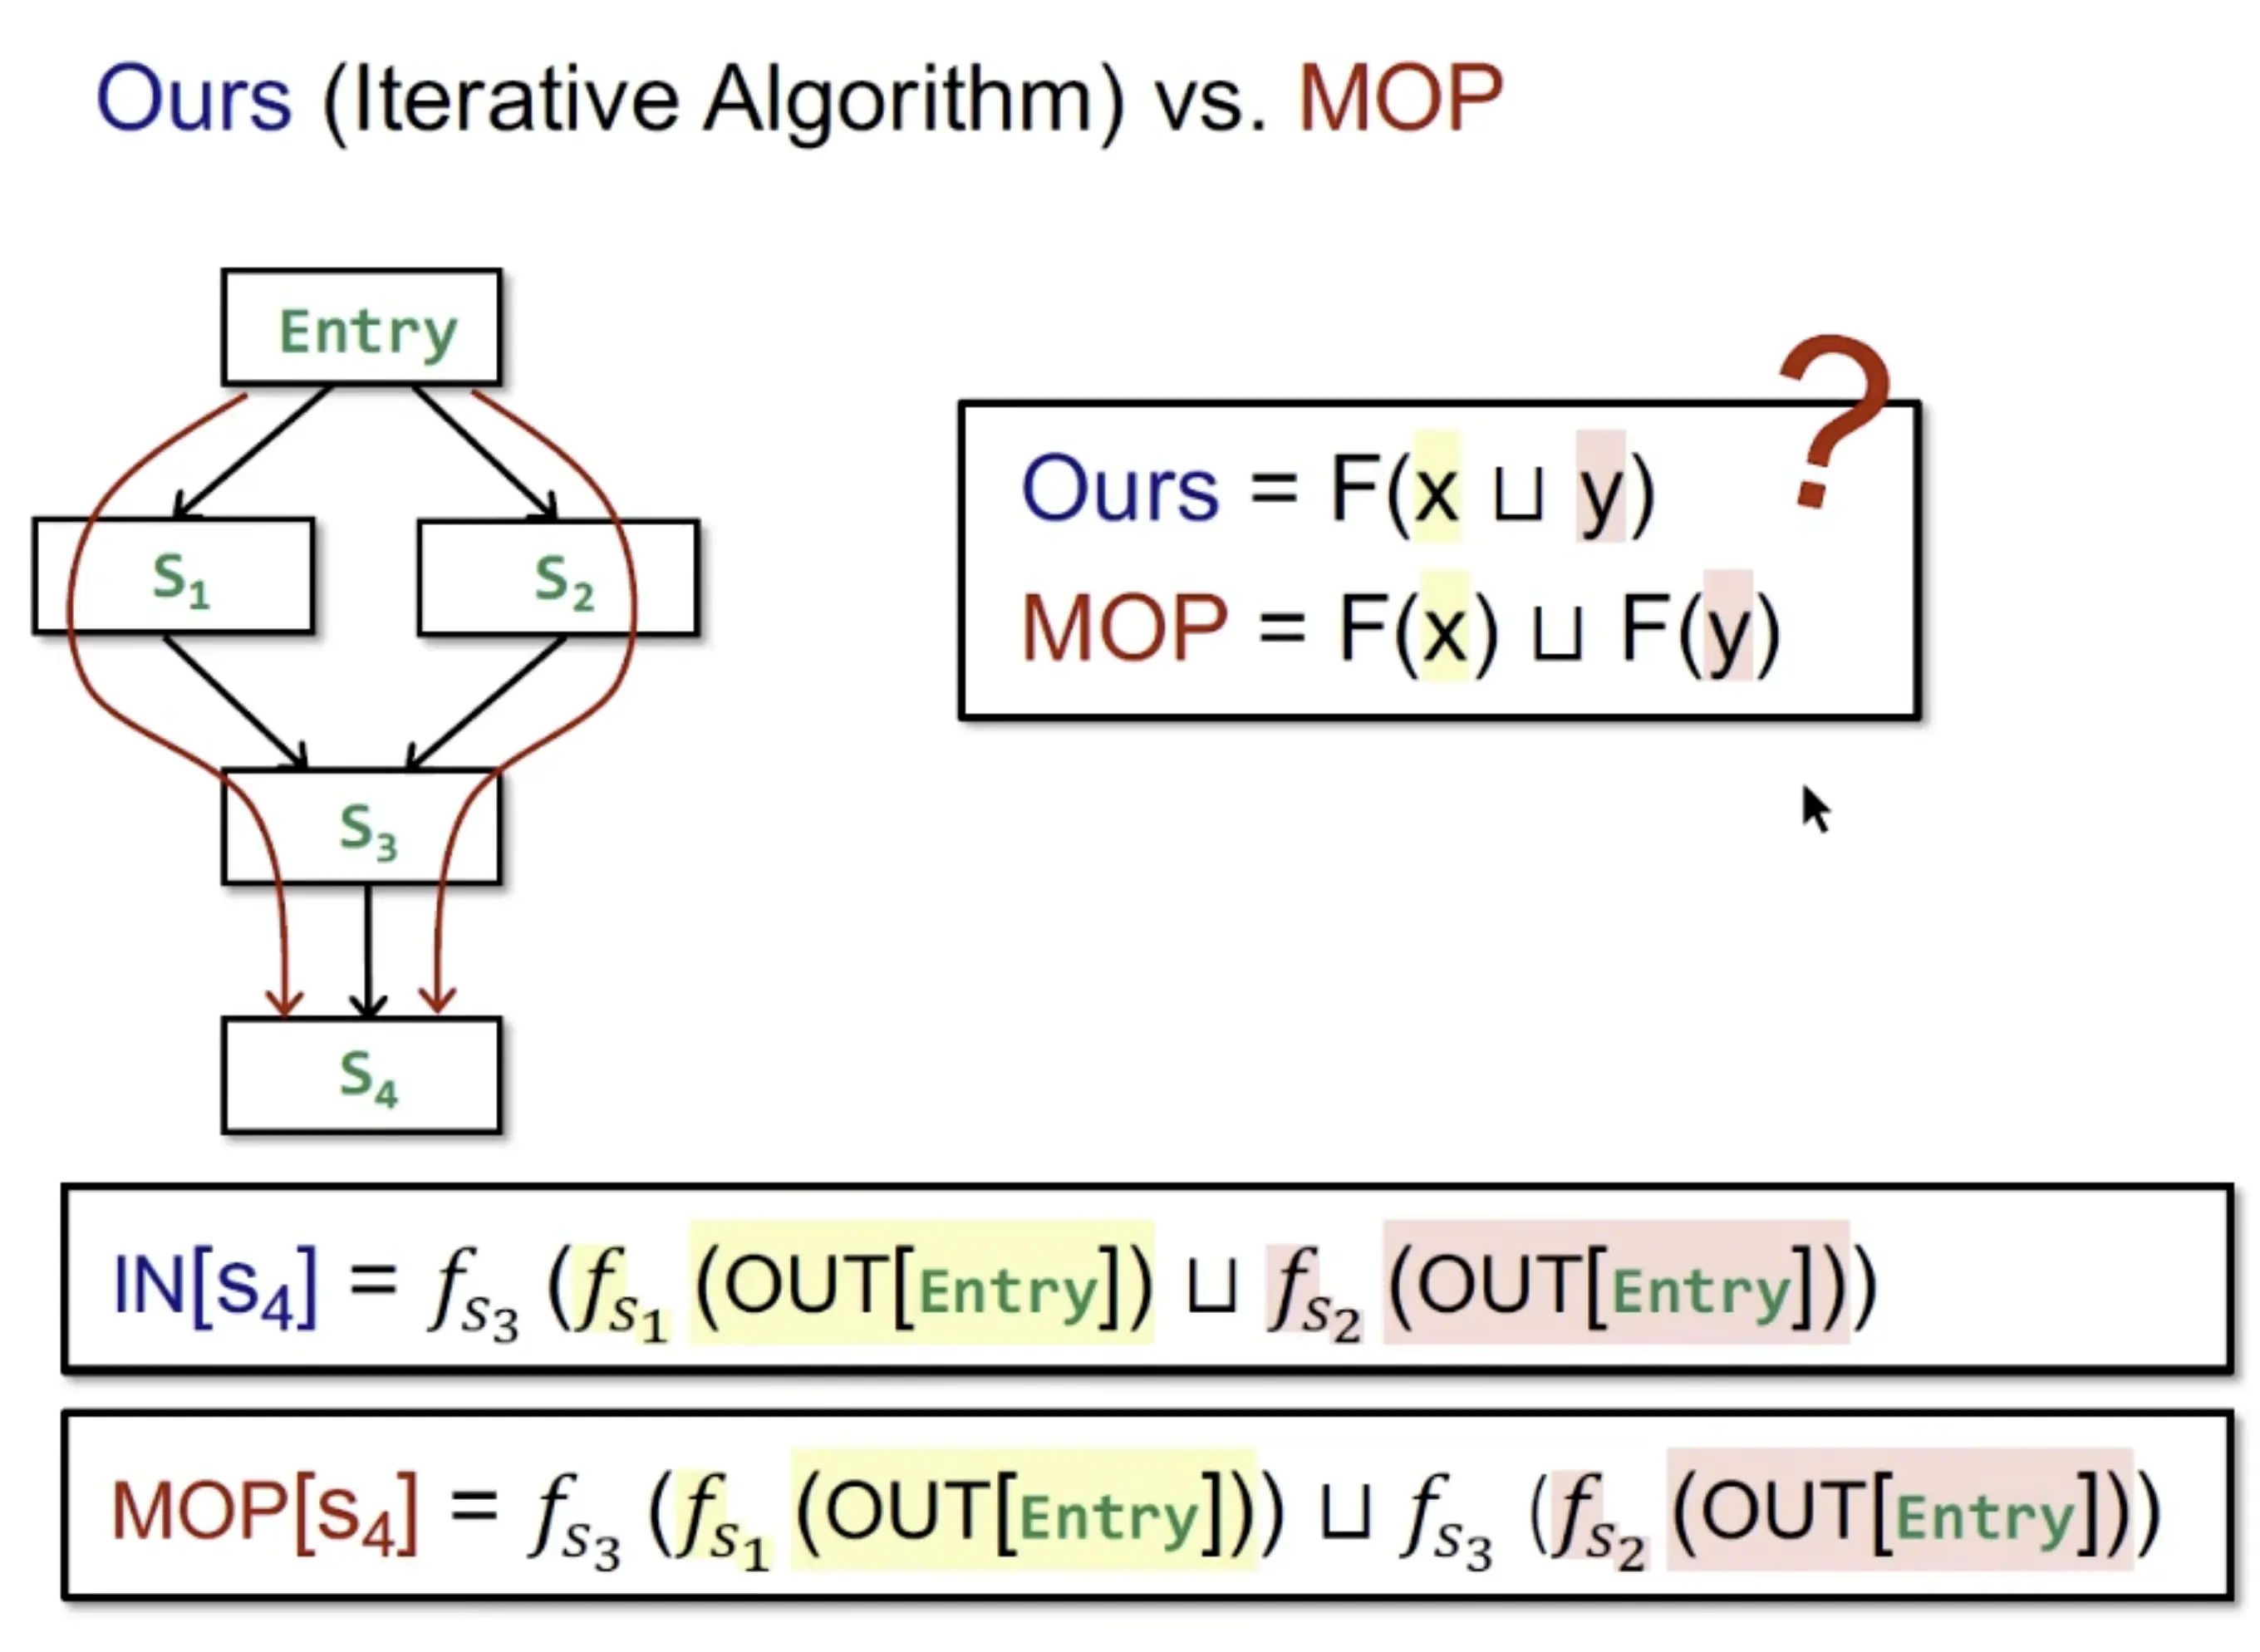
图中可以直观看出这两种算法大概的运算区别,我们先前的算法在每一个节点都union一次,而mop是对路径进行union
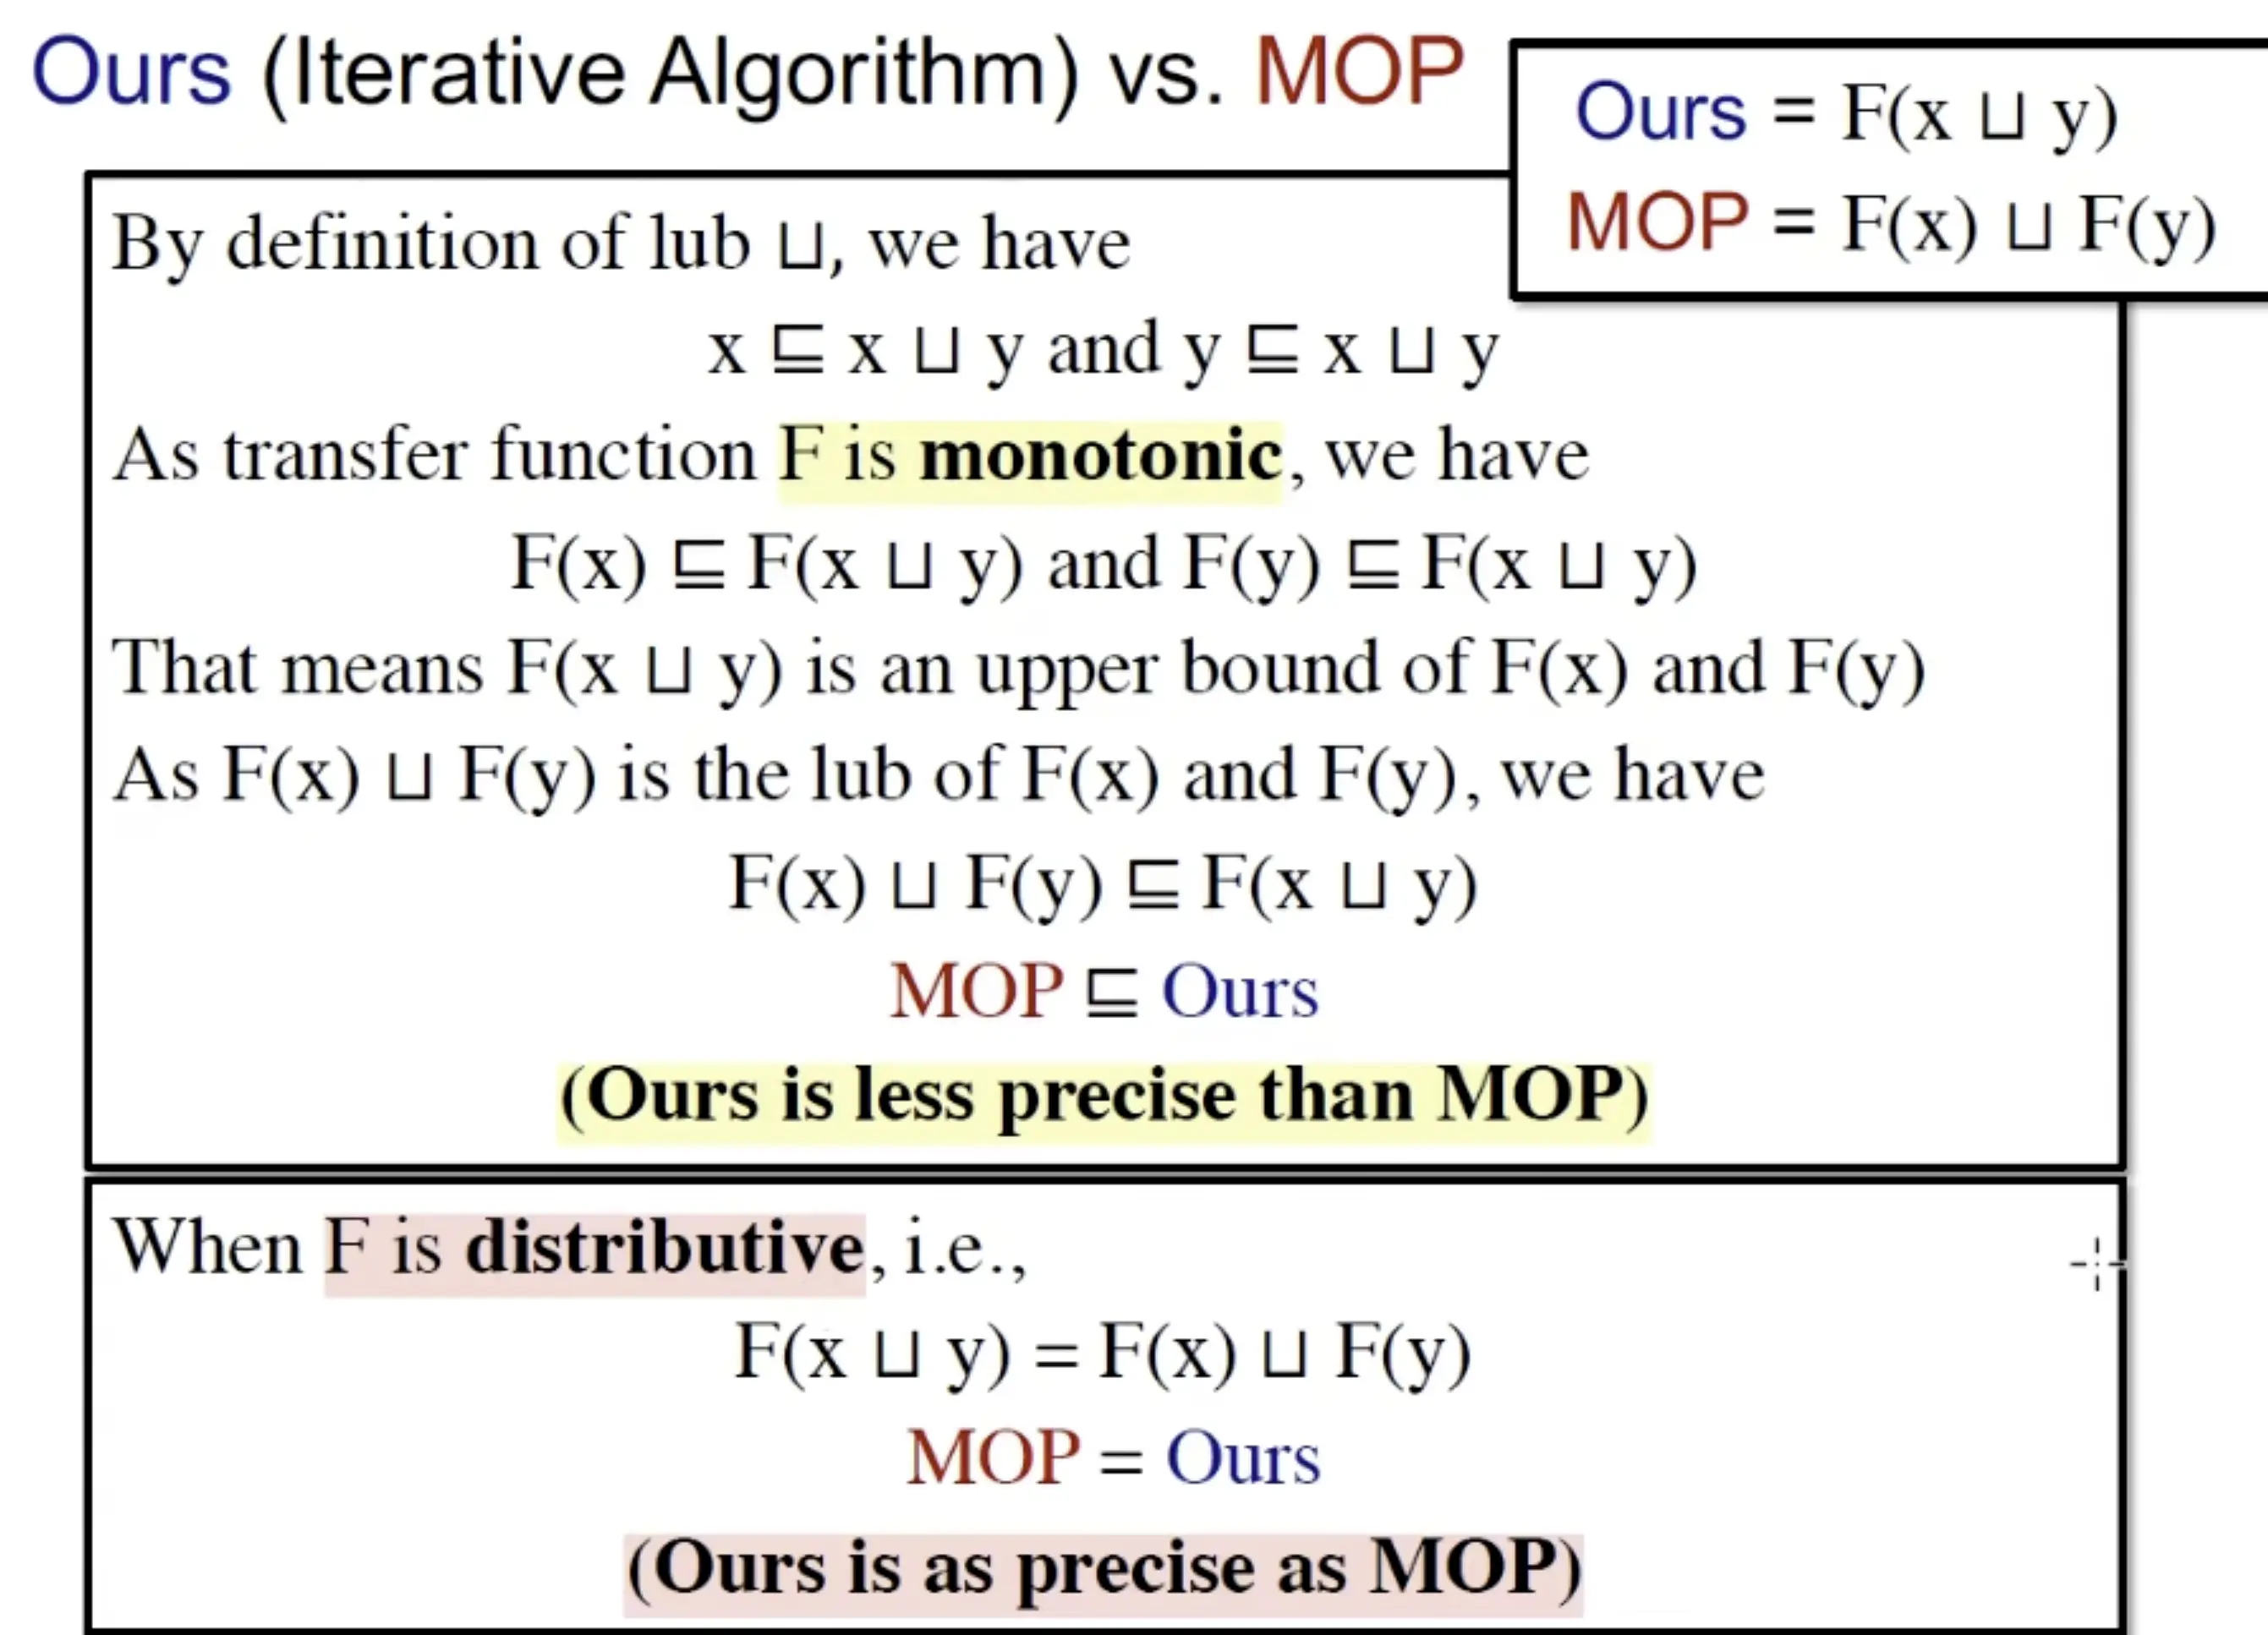
由单调性和lub的性质可以证得MOP是更精准于Ours的(如上面那两个椭圆的右图)
但是也有一样准的时候(当讨论的distributive(可分配)的如bit-vector也叫gen/kill 问题的时候,也就是前面学的那三种算法)
Constant Propagation
下面我们介绍一个分析算法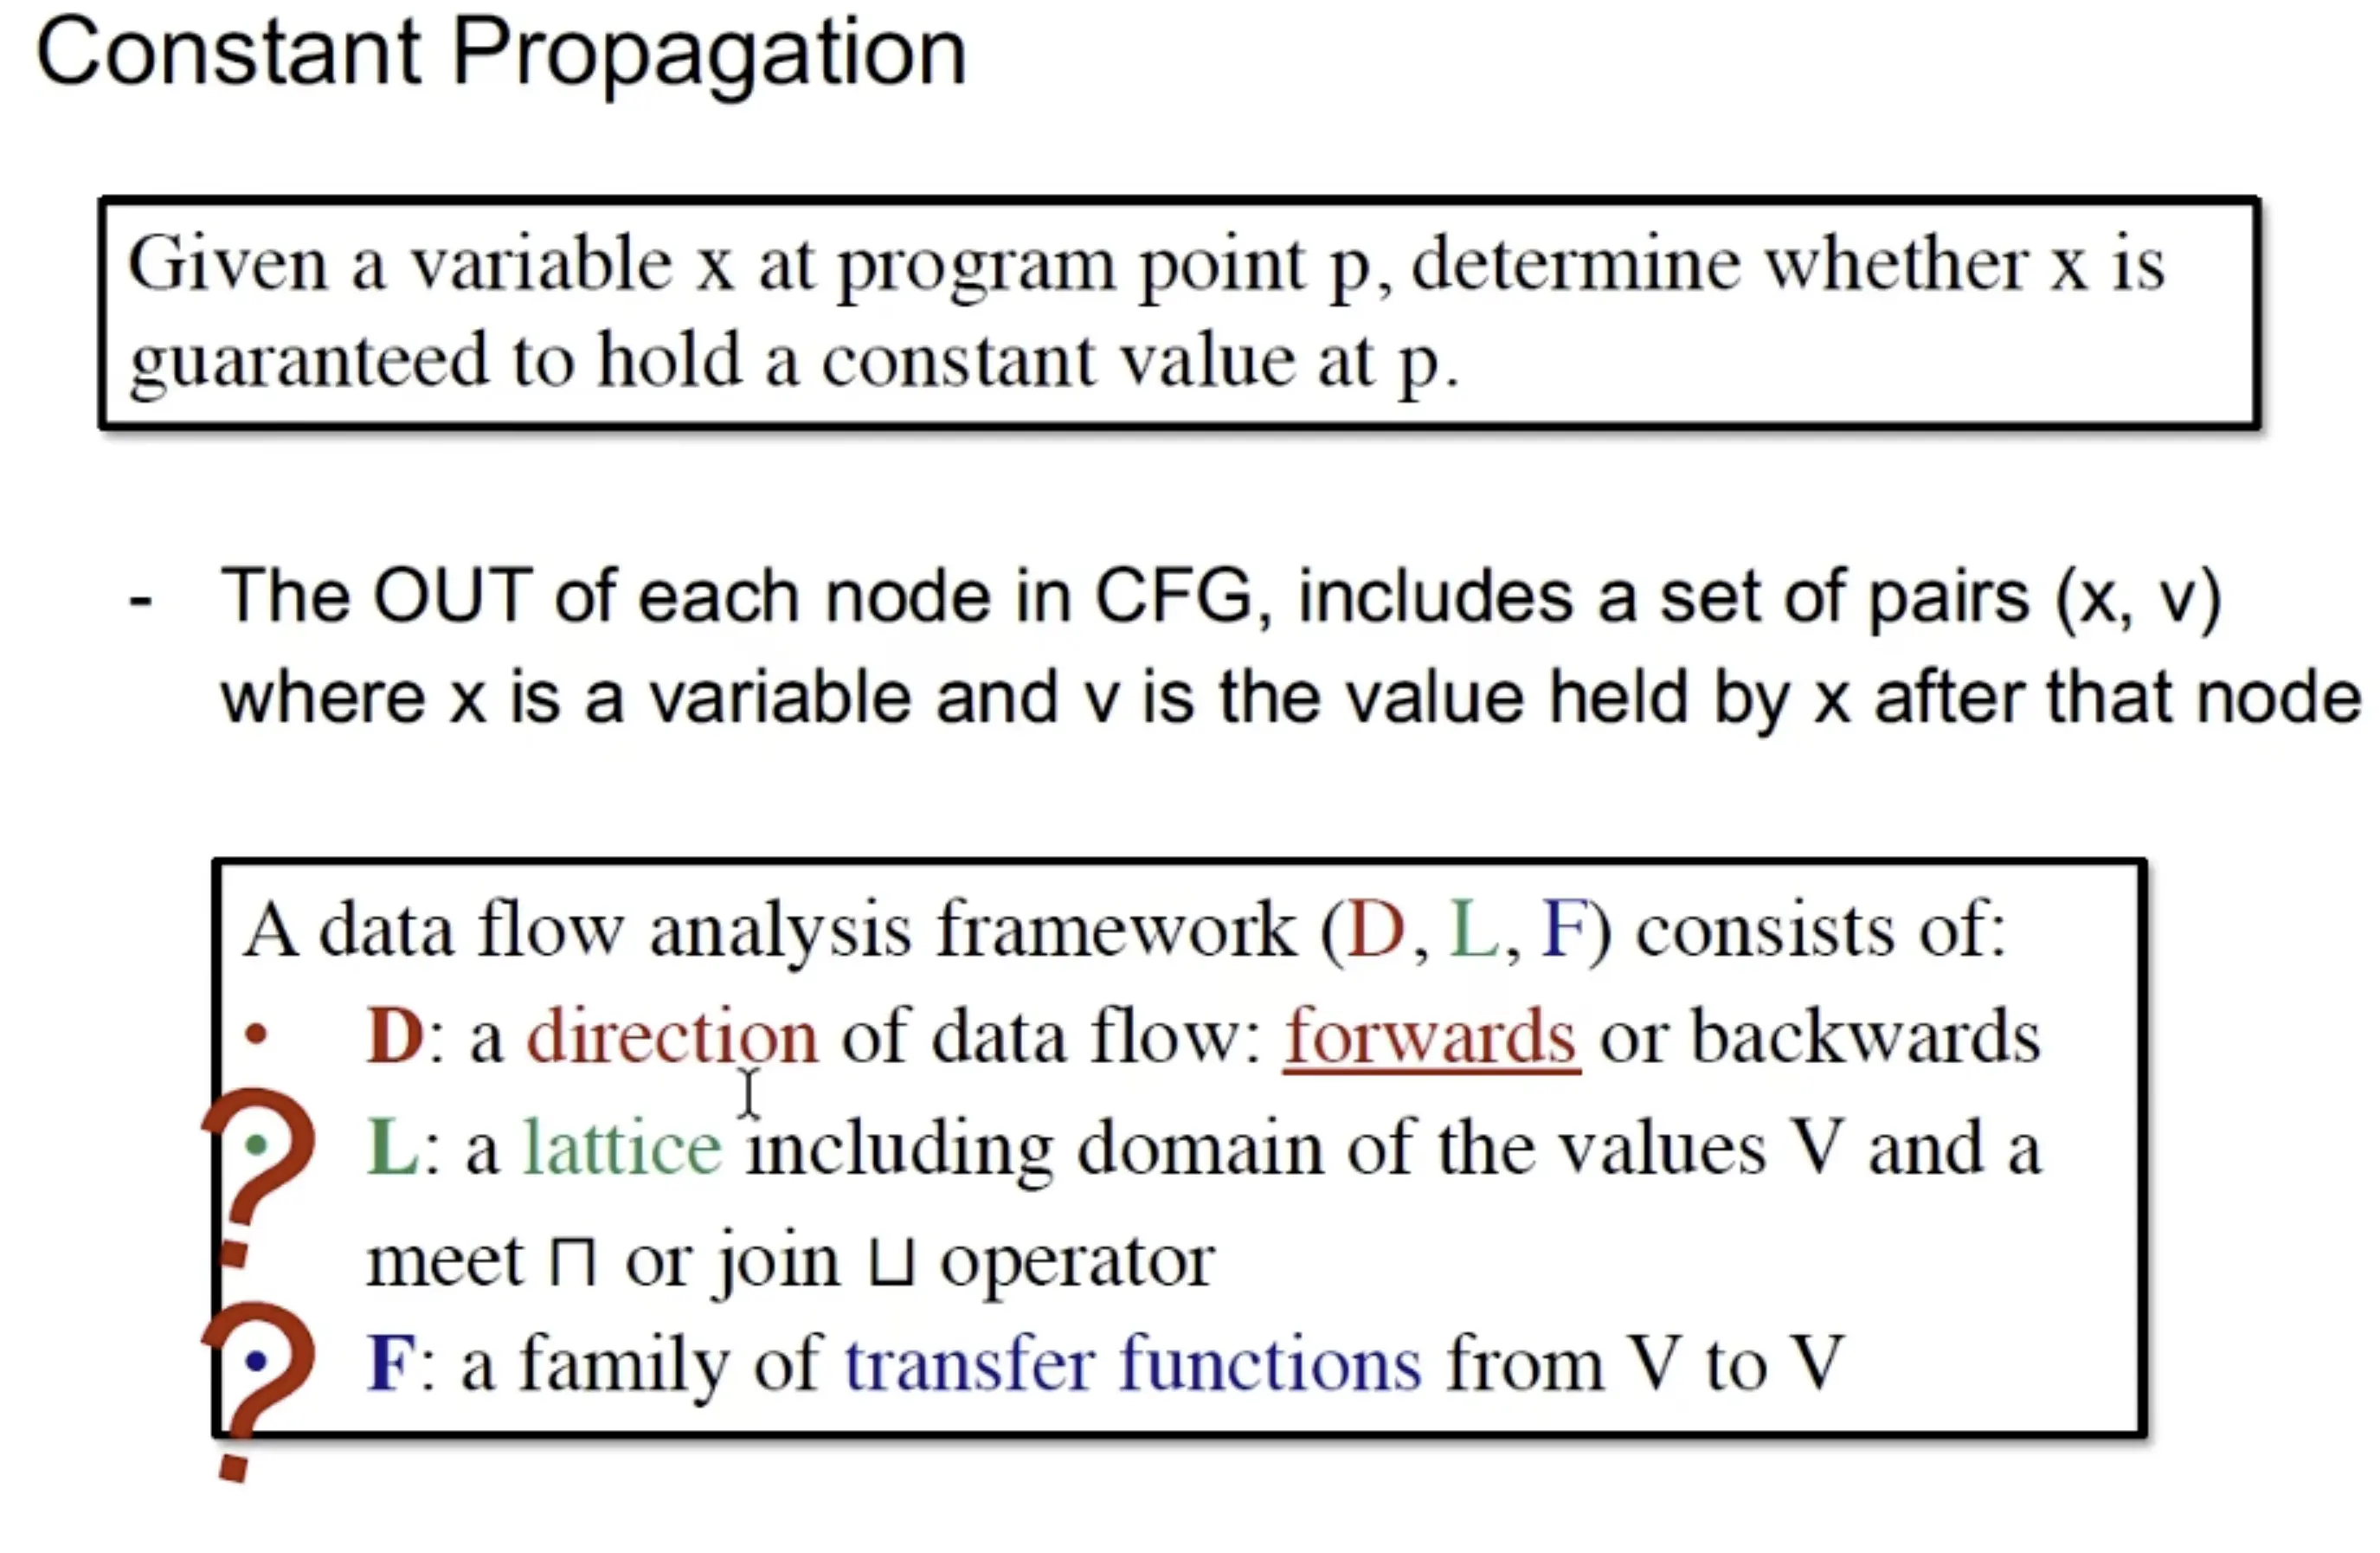
CFG中每个节点的OUT包括一组(x, v)对,其中x是变量,v是该节点之后x持有的值
该分析致力于找出那些从头到尾都不会改变值的变量,并直接将这些变量用常量替换以实现优化
Constant Propagation的Lattice有点特殊,它的初始化是UNDEF,也就是变量未被定义,这很好理解
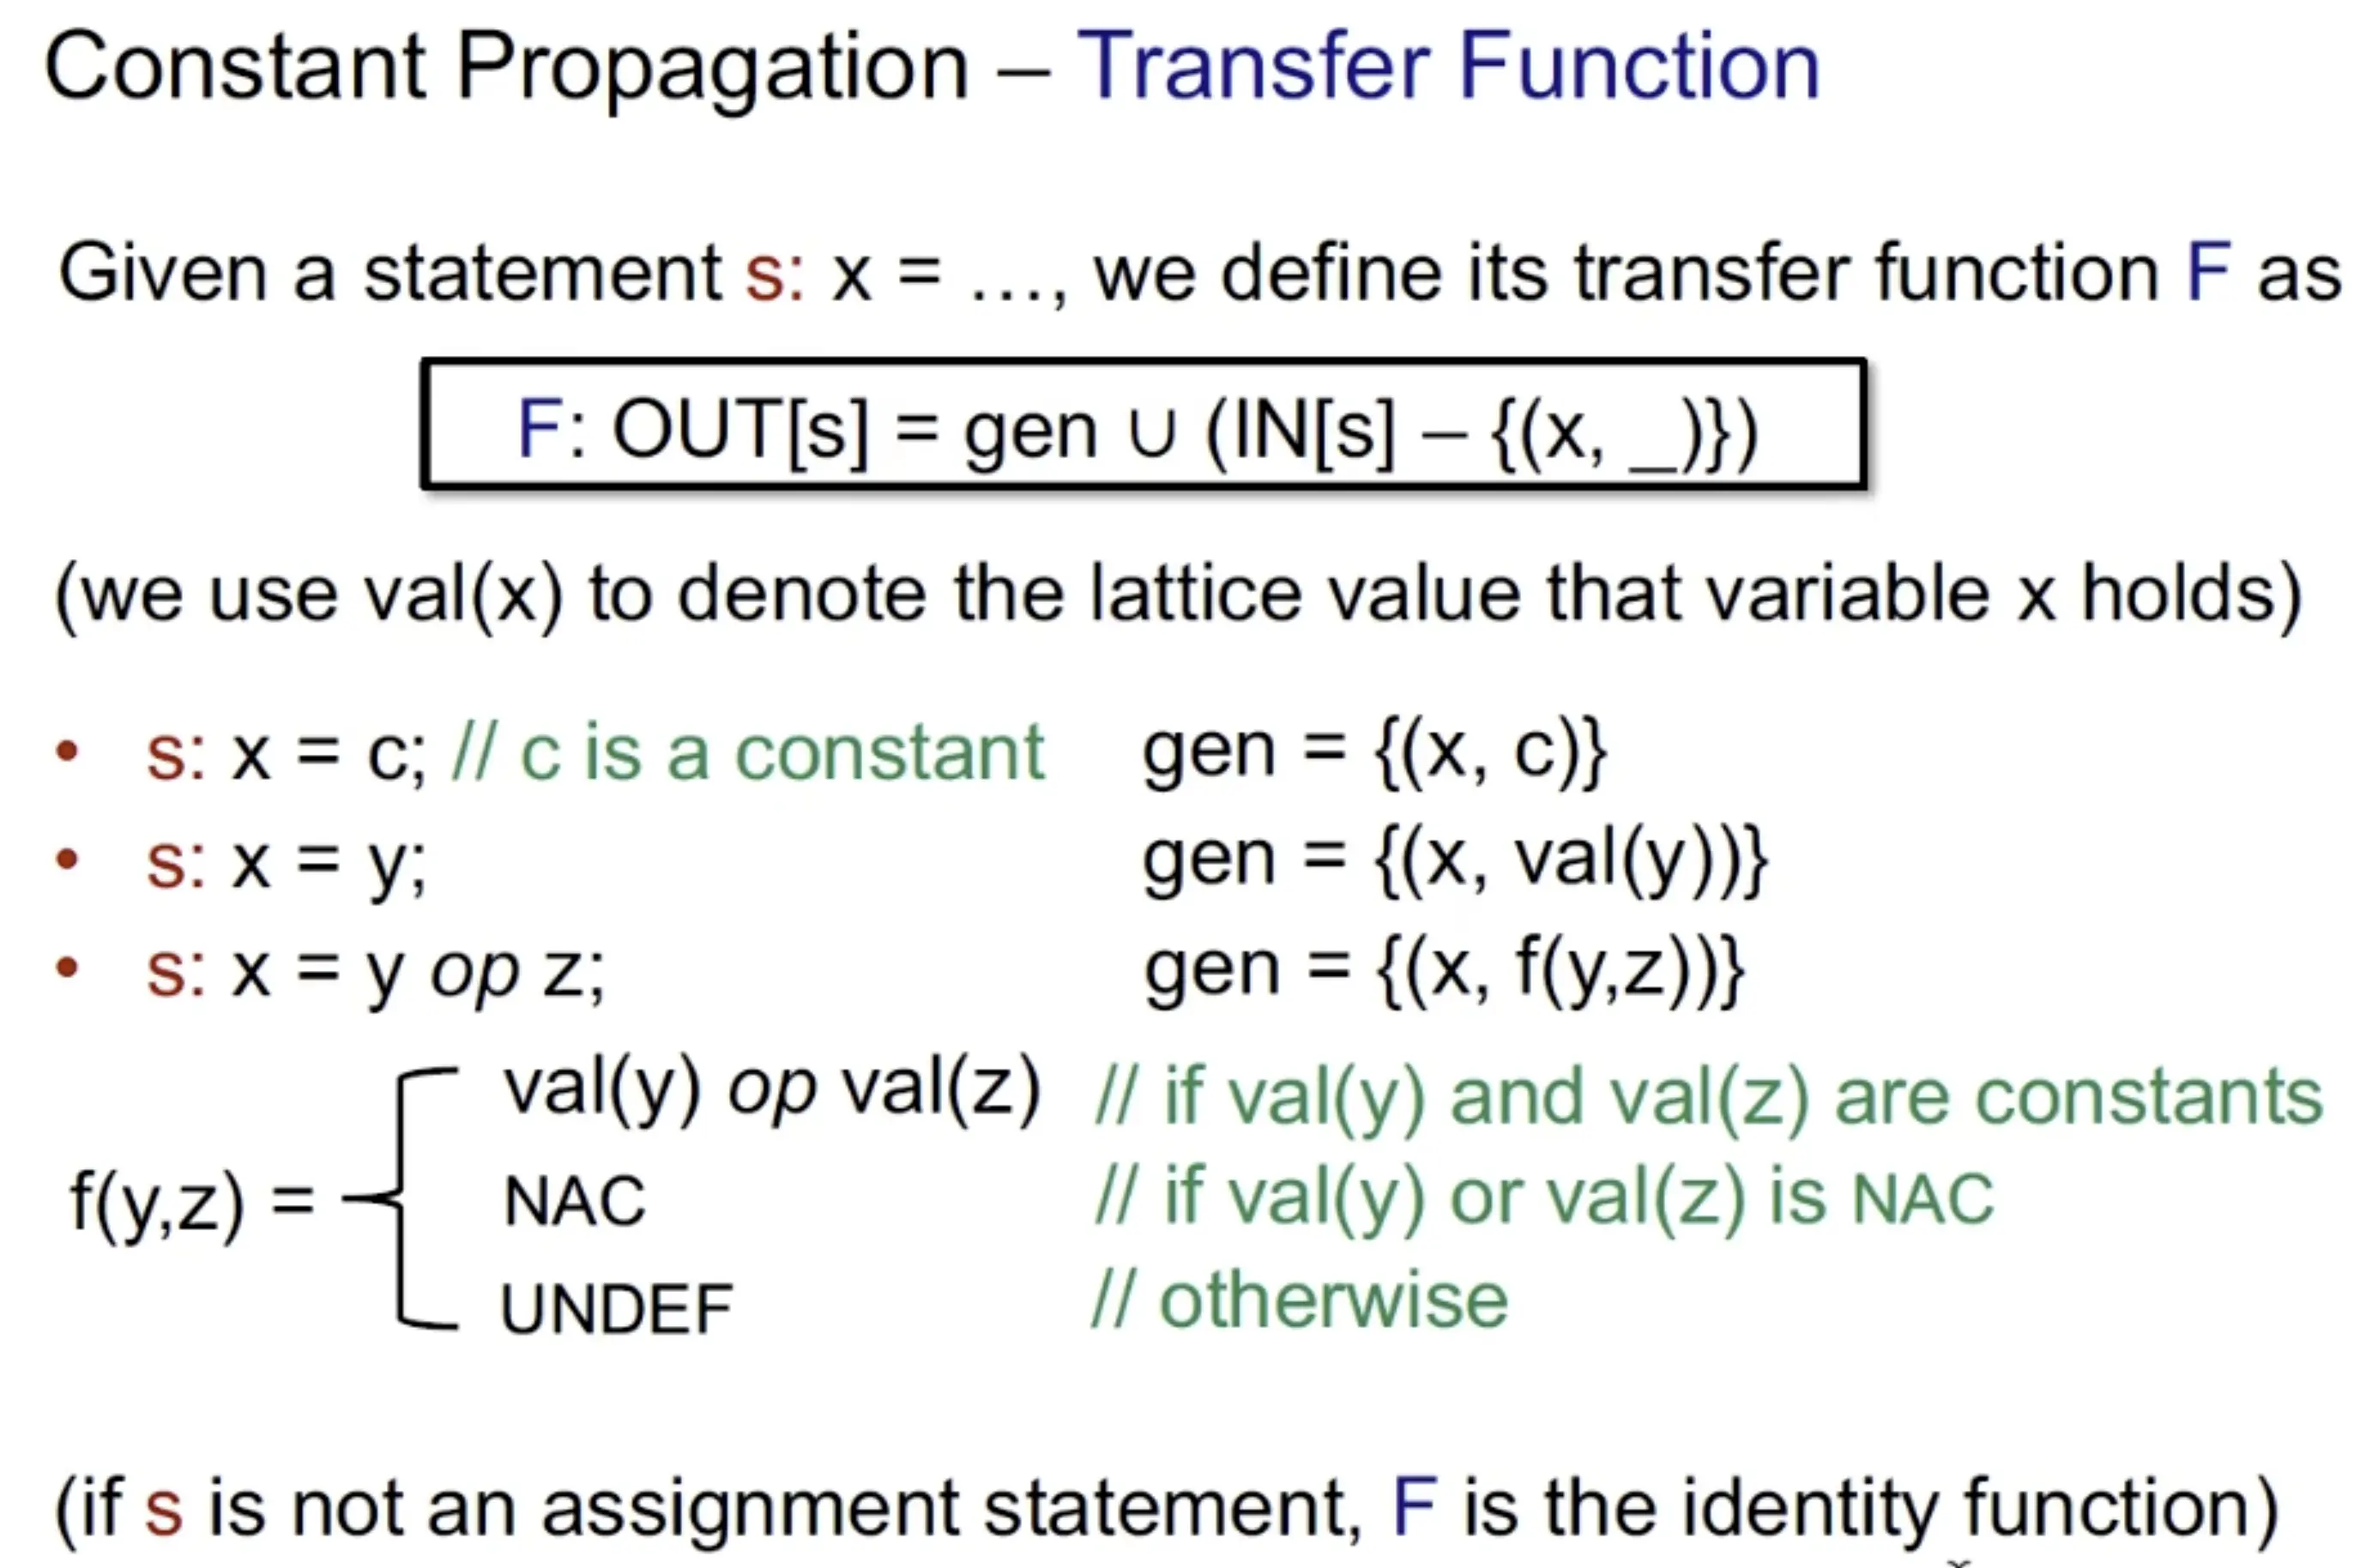
而它的meet比较特殊,不是简单的meet/join,而是有一套自己的规则(但其实这才是大多数情况)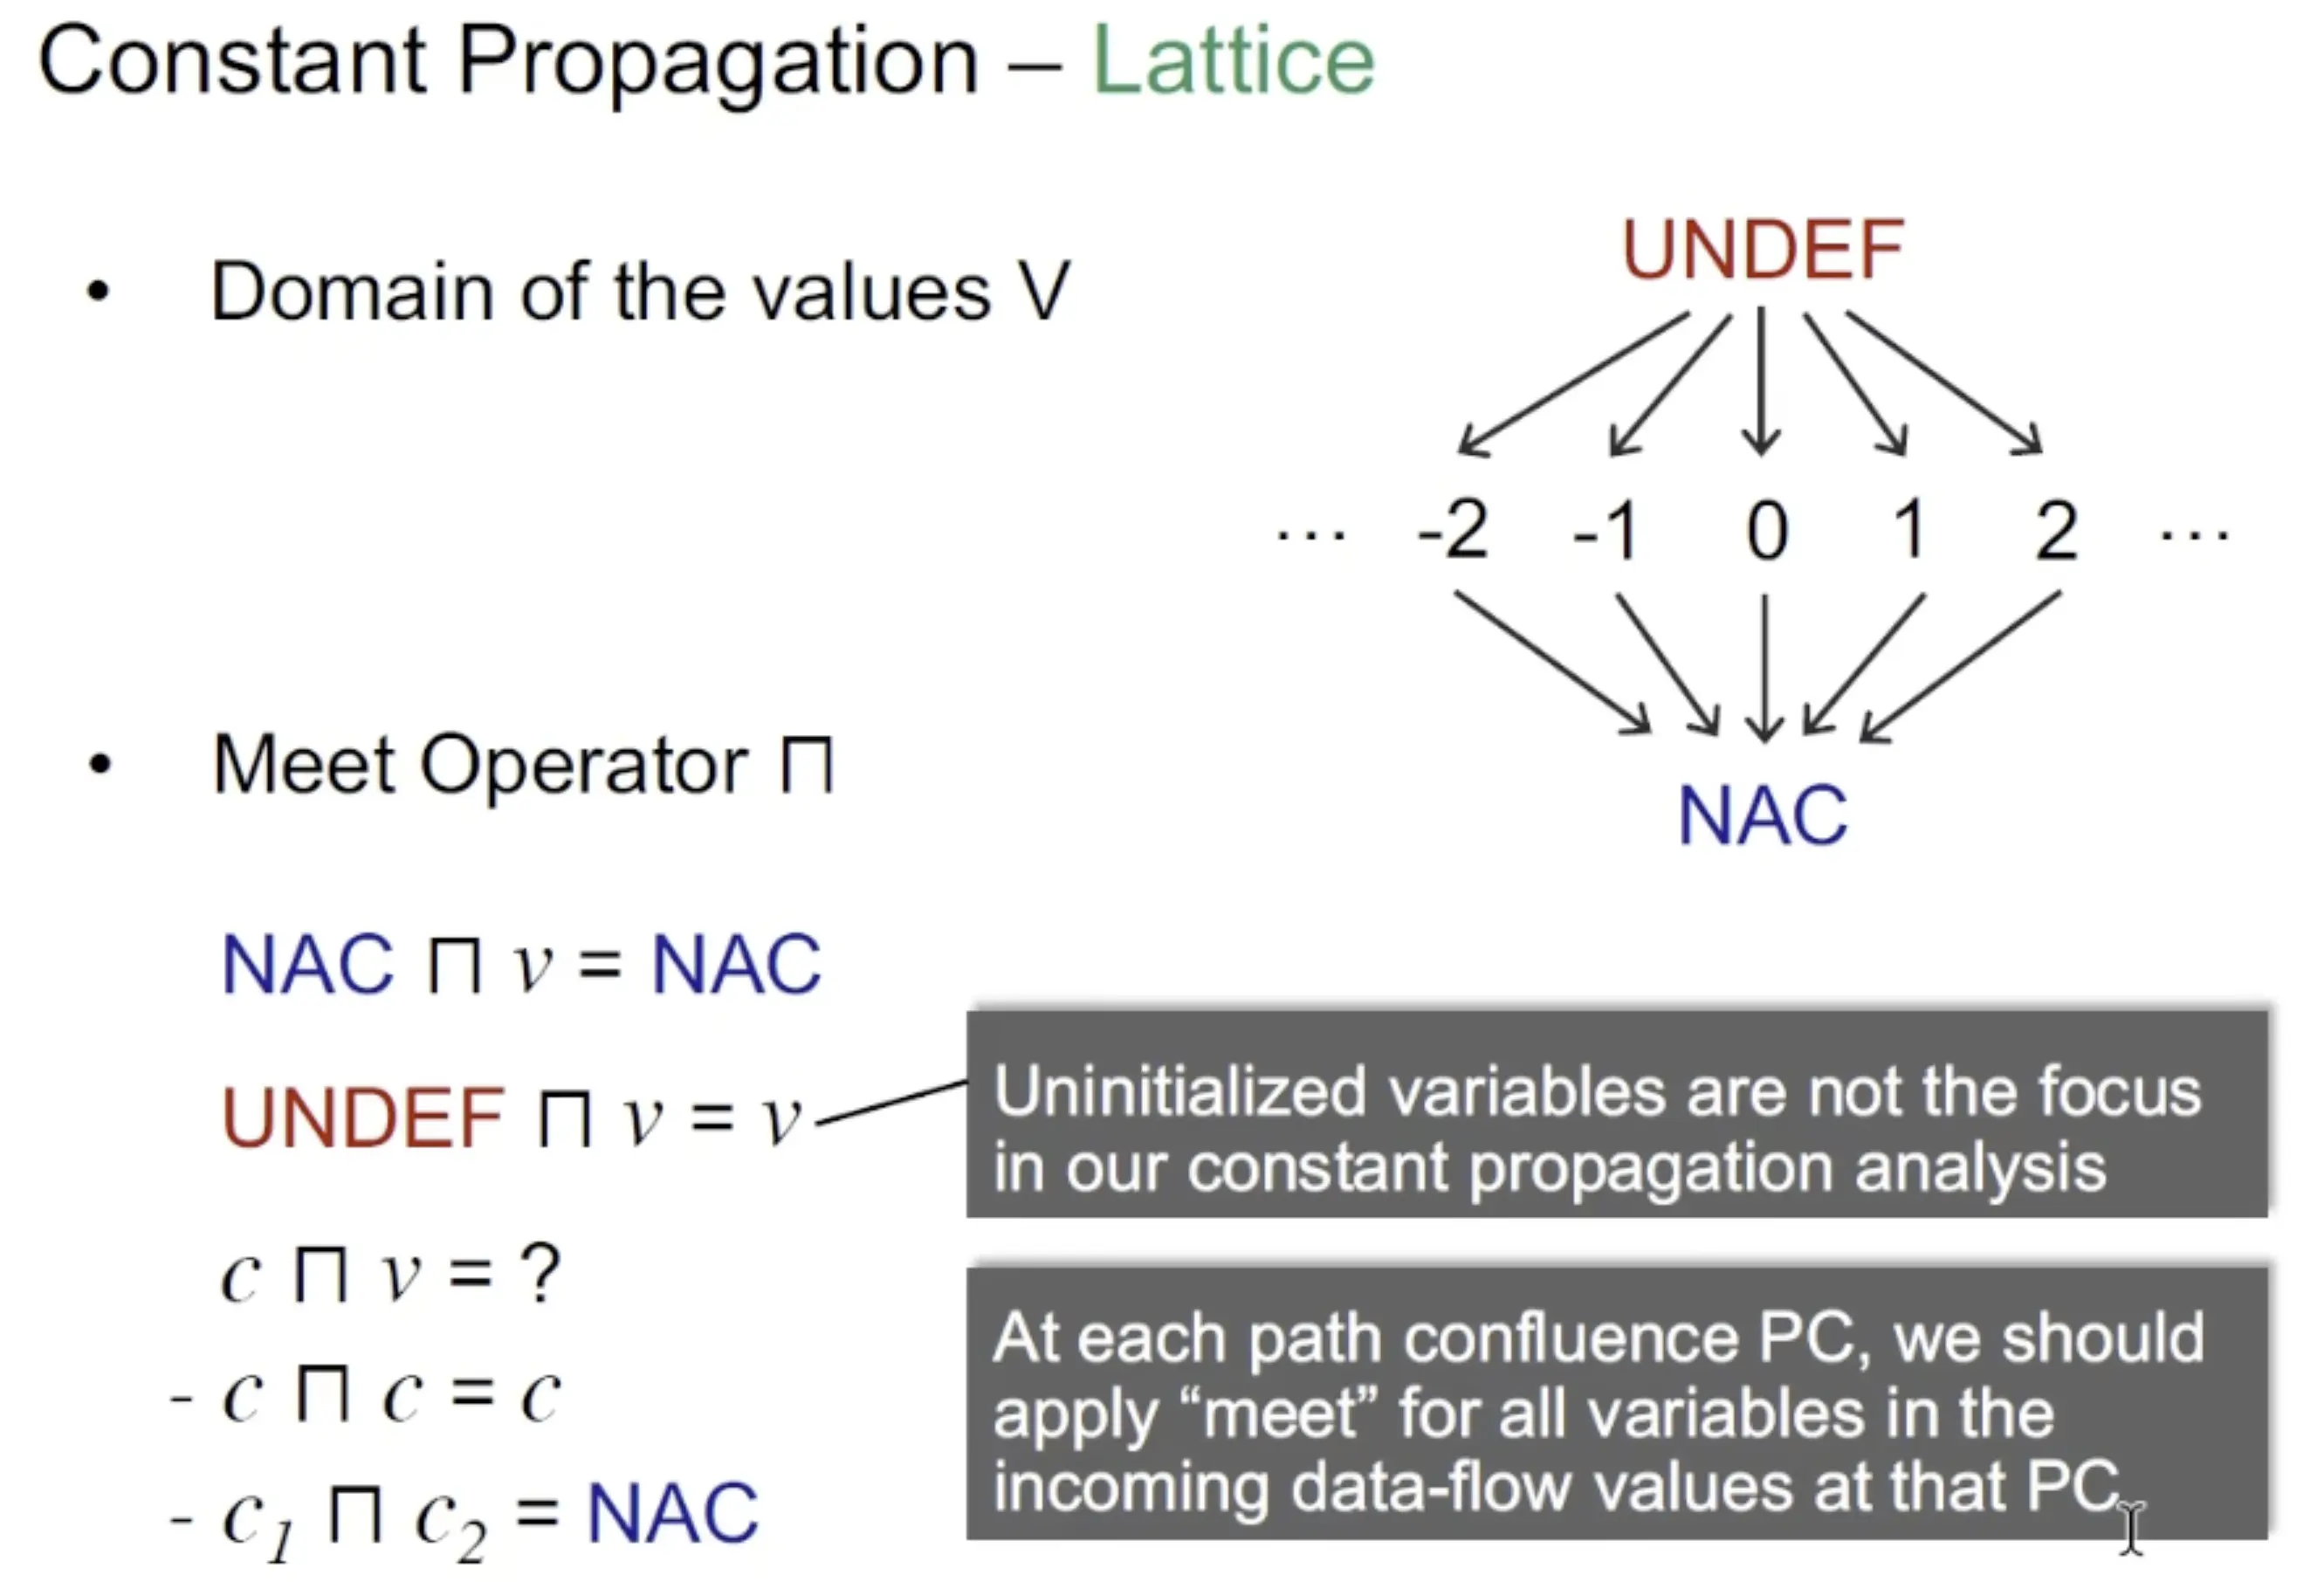 transfer funtion
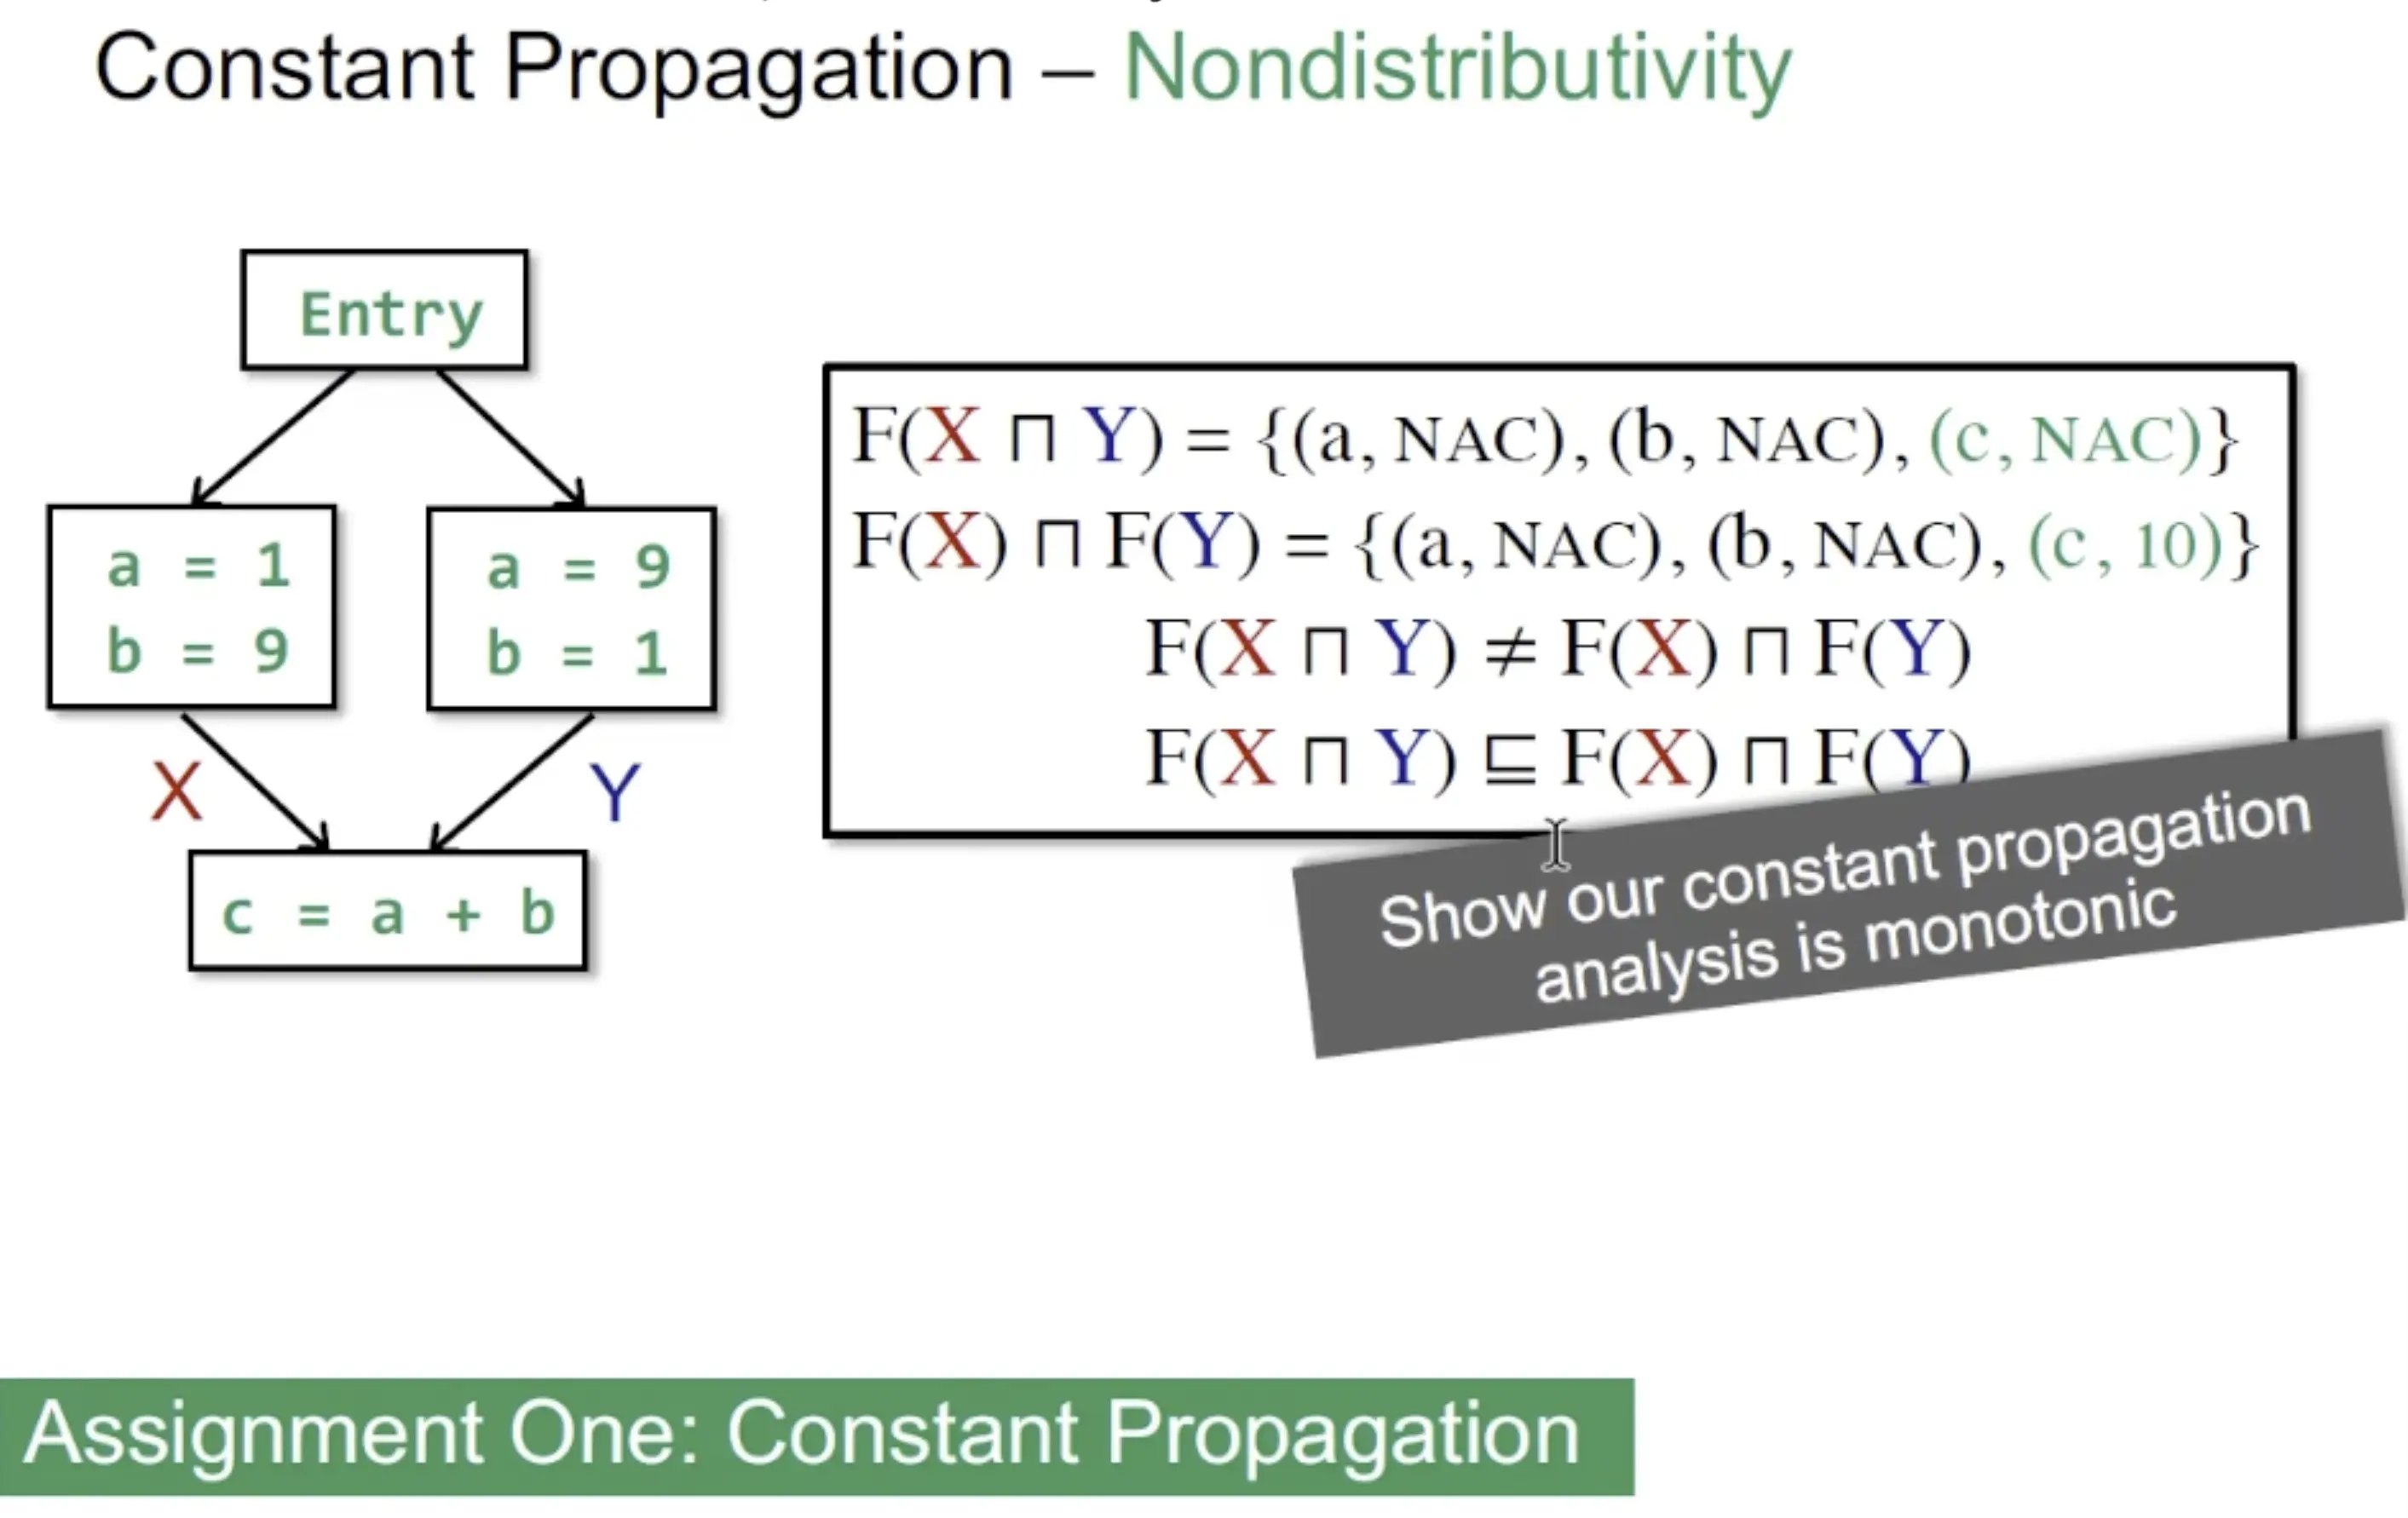
但是迭代算法由于只要有一个node的值发生了变化就整个图都要重新遍历迭代一遍,造成了不小的开支. 想象我们分析的是一个几十万行代码的应用(在企业中很常见)时,任何算法上的优化都会带来很大的速度提升
这里介绍了一种更高效的算法 worklist 算法,只需给可能有变化的block再次计算transfer funtion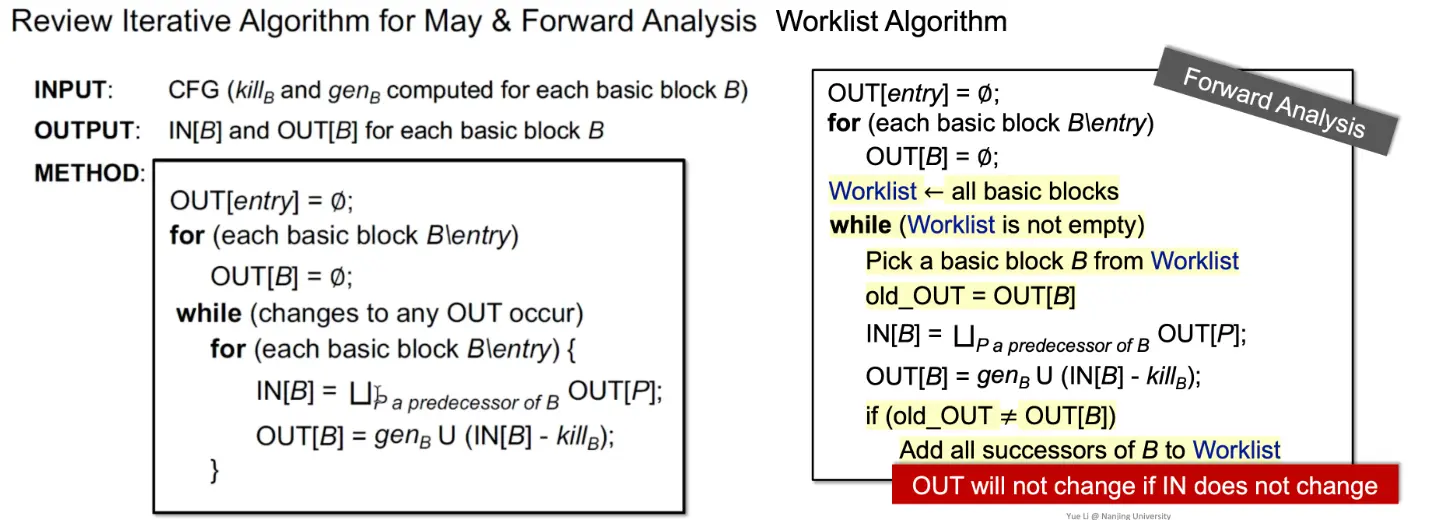
左边是原来的迭代算法,右边是改进后的worklist算法,初始时将所有的blocks都加入worklist中,后面每次迭代时,只将那些in变了的block加入到下一轮的worklist里(因为in不变的话,out肯定不会变),这样每次要遍历的block越来越少知道没有一个block的in变动达到不动点
这节课到这里就结束了,总的来说讲解数学上的不动点原理的证明较多,需要不少离散数学的知识,比较适合后续用到相关深入的知识时回顾,对于初学者来说一次就全掌握不太现实,老师也给出了一张图(两个椭圆)供快速查询
还是先走完一轮完整的课程,后续慢慢补充这节课的理论好了